mirror of
https://github.com/pgsty/minio.git
synced 2026-11-04 06:42:04 +03:00
Compare commits
43 Commits
| Author | SHA1 | Date | |
|---|---|---|---|
 Harshavardhana |
c09fe2c40e | ||
|
Klaus Post
|
f01820a4ee | ||
|
Harshavardhana
|
df4914b6f3 | ||
|
Harshavardhana
|
0287711dc9 | ||
|
Klaus Post
|
9d1b6fb37d | ||
|
Minio Trusted
|
783ea5eb5c | ||
|
Harshavardhana
|
32d8a48d4e | ||
|
Poorna Krishnamoorthy
|
a27339826c | ||
|
Harshavardhana
|
6060b755c6 | ||
|
Krishnan Parthasarathi
|
cfa94cc35c | ||
|
Klaus Post
|
2ca9c533ef | ||
|
Anis Elleuch
|
866593fd94 | ||
|
Harshavardhana
|
ecb5525c91 | ||
|
Klaus Post
|
c2c803dd30 | ||
|
Harshavardhana
|
4f5d75f22b | ||
|
Harshavardhana
|
bb7fbcdc09 | ||
|
Andreas Auernhammer
|
82c53ac260 | ||
|
Harshavardhana
|
a70e0da19e | ||
|
Harshavardhana
|
c6b7dc012a | ||
|
Harshavardhana
|
267f12a2a1 | ||
|
Harshavardhana
|
2daba018d6 | ||
|
Harshavardhana
|
d610578d84 | ||
|
Harshavardhana
|
a096a92c63 | ||
|
Harshavardhana
|
3d9873106d | ||
|
Klaus Post
|
cde6469b88 | ||
|
Klaus Post
|
55375fa7f6 | ||
|
Harshavardhana
|
f1e479d274 | ||
|
Minio Trusted
|
ce3d9dc9fa | ||
|
Harshavardhana
|
2ab9dc7609 | ||
|
Harshavardhana
|
4d876d03e8 | ||
|
Harshavardhana
|
d84261aa6d | ||
|
Harshavardhana
|
5b18c57a54 | ||
|
Harshavardhana
|
7334247c98 | ||
|
Andreas Auernhammer
|
a1f70b106f | ||
|
Poorna Krishnamoorthy
|
951acf561c | ||
|
Harshavardhana
|
397391c89f | ||
|
Andreas Auernhammer
|
9cd9f5a0b3 | ||
|
Andreas Auernhammer
|
b989e5a514 | ||
|
Harshavardhana
|
5c0a7189c7 | ||
|
Harshavardhana
|
57aed841dd | ||
|
Nitish Tiwari
|
a592d3be19 | ||
|
Klaus Post
|
229d83bb75 | ||
|
Minio Trusted
|
f63eedb2b4 |
@@ -17,8 +17,8 @@ checks:
|
||||
getdeps:
|
||||
@mkdir -p ${GOPATH}/bin
|
||||
@which golangci-lint 1>/dev/null || (echo "Installing golangci-lint" && curl -sSfL https://raw.githubusercontent.com/golangci/golangci-lint/master/install.sh | sh -s -- -b $(GOPATH)/bin v1.27.0)
|
||||
@which msgp 1>/dev/null || (echo "Installing msgp" && go get github.com/tinylib/msgp@v1.1.3)
|
||||
@which stringer 1>/dev/null || (echo "Installing stringer" && go get golang.org/x/tools/cmd/stringer)
|
||||
@which msgp 1>/dev/null || (echo "Installing msgp" && go install -v github.com/tinylib/msgp@v1.1.3)
|
||||
@which stringer 1>/dev/null || (echo "Installing stringer" && go install -v golang.org/x/tools/cmd/stringer)
|
||||
|
||||
crosscompile:
|
||||
@(env bash $(PWD)/buildscripts/cross-compile.sh)
|
||||
|
||||
@@ -14,3 +14,15 @@
|
||||
* limitations under the License.
|
||||
*/
|
||||
|
||||
export const OPEN_ID_NONCE_KEY = 'openIDKey'
|
||||
|
||||
export const buildOpenIDAuthURL = (authEp, authScopes, redirectURI, clientID, nonce) => {
|
||||
const params = new URLSearchParams()
|
||||
params.set("response_type", "id_token")
|
||||
params.set("scope", authScopes.join(" "))
|
||||
params.set("client_id", clientID)
|
||||
params.set("redirect_uri", redirectURI)
|
||||
params.set("nonce", nonce)
|
||||
|
||||
return `${authEp}?${params.toString()}`
|
||||
}
|
||||
|
||||
Generated
+21338
-24
File diff suppressed because it is too large
Load Diff
File diff suppressed because one or more lines are too long
@@ -523,6 +523,7 @@ func (a adminAPIHandlers) AddServiceAccount(w http.ResponseWriter, r *http.Reque
|
||||
return
|
||||
}
|
||||
// targerUser is set to bindDN at this point in time.
|
||||
// targetGroups is set to the groups at this point in time.
|
||||
} else {
|
||||
if cred.IsServiceAccount() || cred.IsTemp() {
|
||||
if cred.ParentUser == "" {
|
||||
@@ -534,7 +535,10 @@ func (a adminAPIHandlers) AddServiceAccount(w http.ResponseWriter, r *http.Reque
|
||||
targetUser = cred.ParentUser
|
||||
}
|
||||
}
|
||||
targetGroups = cred.Groups
|
||||
// targetGroups not yet set, so set this to cred.Groups
|
||||
if len(targetGroups) == 0 {
|
||||
targetGroups = cred.Groups
|
||||
}
|
||||
}
|
||||
|
||||
var sp *iampolicy.Policy
|
||||
|
||||
@@ -1304,6 +1304,7 @@ func (a adminAPIHandlers) KMSKeyStatusHandler(w http.ResponseWriter, r *http.Req
|
||||
writeErrorResponseJSON(ctx, w, errorCodes.ToAPIErr(ErrKMSNotConfigured), r.URL)
|
||||
return
|
||||
}
|
||||
|
||||
stat, err := GlobalKMS.Stat()
|
||||
if err != nil {
|
||||
writeCustomErrorResponseJSON(ctx, w, errorCodes.ToAPIErr(ErrInternalError), err.Error(), r.URL)
|
||||
@@ -1333,7 +1334,7 @@ func (a adminAPIHandlers) KMSKeyStatusHandler(w http.ResponseWriter, r *http.Req
|
||||
}
|
||||
|
||||
// 2. Verify that we can indeed decrypt the (encrypted) key
|
||||
decryptedKey, err := GlobalKMS.DecryptKey(key.KeyID, key.Plaintext, kmsContext)
|
||||
decryptedKey, err := GlobalKMS.DecryptKey(key.KeyID, key.Ciphertext, kmsContext)
|
||||
if err != nil {
|
||||
response.DecryptionErr = err.Error()
|
||||
resp, err := json.Marshal(response)
|
||||
@@ -1800,10 +1801,6 @@ func fetchKMSStatus() madmin.KMS {
|
||||
kmsStat.Status = stat.Name
|
||||
return kmsStat
|
||||
}
|
||||
if err := checkConnection(stat.Endpoints[0], 15*time.Second); err != nil {
|
||||
kmsStat.Status = string(madmin.ItemOffline)
|
||||
return kmsStat
|
||||
}
|
||||
kmsStat.Status = string(madmin.ItemOnline)
|
||||
|
||||
kmsContext := kms.Context{"MinIO admin API": "ServerInfoHandler"} // Context for a test key operation
|
||||
|
||||
+3
-1
@@ -766,7 +766,7 @@ var errorCodes = errorCodeMap{
|
||||
},
|
||||
ErrSlowDown: {
|
||||
Code: "SlowDown",
|
||||
Description: "Please reduce your request",
|
||||
Description: "Resource requested is unreadable, please reduce your request rate",
|
||||
HTTPStatusCode: http.StatusServiceUnavailable,
|
||||
},
|
||||
ErrInvalidPrefixMarker: {
|
||||
@@ -1814,6 +1814,8 @@ func toAPIErrorCode(ctx context.Context, err error) (apiErr APIErrorCode) {
|
||||
apiErr = ErrAdminInvalidAccessKey
|
||||
case auth.ErrInvalidSecretKeyLength:
|
||||
apiErr = ErrAdminInvalidSecretKey
|
||||
case errInvalidStorageClass:
|
||||
apiErr = ErrInvalidStorageClass
|
||||
// SSE errors
|
||||
case errInvalidEncryptionParameters:
|
||||
apiErr = ErrInvalidEncryptionParameters
|
||||
|
||||
+32
-26
@@ -90,7 +90,22 @@ type rejectedAPI struct {
|
||||
path string
|
||||
}
|
||||
|
||||
var rejectedAPIs = []rejectedAPI{
|
||||
var rejectedObjAPIs = []rejectedAPI{
|
||||
{
|
||||
api: "torrent",
|
||||
methods: []string{http.MethodPut, http.MethodDelete, http.MethodGet},
|
||||
queries: []string{"torrent", ""},
|
||||
path: "/{object:.+}",
|
||||
},
|
||||
{
|
||||
api: "acl",
|
||||
methods: []string{http.MethodDelete},
|
||||
queries: []string{"acl", ""},
|
||||
path: "/{object:.+}",
|
||||
},
|
||||
}
|
||||
|
||||
var rejectedBucketAPIs = []rejectedAPI{
|
||||
{
|
||||
api: "inventory",
|
||||
methods: []string{http.MethodGet, http.MethodPut, http.MethodDelete},
|
||||
@@ -126,18 +141,6 @@ var rejectedAPIs = []rejectedAPI{
|
||||
methods: []string{http.MethodPut, http.MethodDelete},
|
||||
queries: []string{"requestPayment", ""},
|
||||
},
|
||||
{
|
||||
api: "torrent",
|
||||
methods: []string{http.MethodPut, http.MethodDelete, http.MethodGet},
|
||||
queries: []string{"torrent", ""},
|
||||
path: "/{object:.+}",
|
||||
},
|
||||
{
|
||||
api: "acl",
|
||||
methods: []string{http.MethodDelete},
|
||||
queries: []string{"acl", ""},
|
||||
path: "/{object:.+}",
|
||||
},
|
||||
{
|
||||
api: "acl",
|
||||
methods: []string{http.MethodDelete, http.MethodPut, http.MethodHead},
|
||||
@@ -165,17 +168,6 @@ var rejectedAPIs = []rejectedAPI{
|
||||
},
|
||||
}
|
||||
|
||||
func rejectUnsupportedAPIs(router *mux.Router) {
|
||||
for _, r := range rejectedAPIs {
|
||||
t := router.Methods(r.methods...).
|
||||
HandlerFunc(collectAPIStats(r.api, httpTraceAll(notImplementedHandler))).
|
||||
Queries(r.queries...)
|
||||
if r.path != "" {
|
||||
t.Path(r.path)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// registerAPIRouter - registers S3 compatible APIs.
|
||||
func registerAPIRouter(router *mux.Router) {
|
||||
// Initialize API.
|
||||
@@ -215,7 +207,14 @@ func registerAPIRouter(router *mux.Router) {
|
||||
routers = append(routers, apiRouter.PathPrefix("/{bucket}").Subrouter())
|
||||
|
||||
for _, router := range routers {
|
||||
rejectUnsupportedAPIs(router)
|
||||
// Register all rejected object APIs
|
||||
for _, r := range rejectedObjAPIs {
|
||||
t := router.Methods(r.methods...).
|
||||
HandlerFunc(collectAPIStats(r.api, httpTraceAll(notImplementedHandler))).
|
||||
Queries(r.queries...)
|
||||
t.Path(r.path)
|
||||
}
|
||||
|
||||
// Object operations
|
||||
// HeadObject
|
||||
router.Methods(http.MethodHead).Path("/{object:.+}").HandlerFunc(
|
||||
@@ -422,16 +421,23 @@ func registerAPIRouter(router *mux.Router) {
|
||||
// DeleteBucket
|
||||
router.Methods(http.MethodDelete).HandlerFunc(
|
||||
collectAPIStats("deletebucket", maxClients(httpTraceAll(api.DeleteBucketHandler))))
|
||||
|
||||
// MinIO extension API for replication.
|
||||
//
|
||||
// GetBucketReplicationMetrics
|
||||
router.Methods(http.MethodGet).HandlerFunc(
|
||||
collectAPIStats("getbucketreplicationmetrics", maxClients(httpTraceAll(api.GetBucketReplicationMetricsHandler)))).Queries("replication-metrics", "")
|
||||
|
||||
// Register rejected bucket APIs
|
||||
for _, r := range rejectedBucketAPIs {
|
||||
router.Methods(r.methods...).
|
||||
HandlerFunc(collectAPIStats(r.api, httpTraceAll(notImplementedHandler))).
|
||||
Queries(r.queries...)
|
||||
}
|
||||
|
||||
// S3 ListObjectsV1 (Legacy)
|
||||
router.Methods(http.MethodGet).HandlerFunc(
|
||||
collectAPIStats("listobjectsv1", maxClients(httpTraceAll(api.ListObjectsV1Handler))))
|
||||
|
||||
}
|
||||
|
||||
/// Root operation
|
||||
|
||||
+20
-6
@@ -57,9 +57,15 @@ func (b *streamingBitrotWriter) Write(p []byte) (int, error) {
|
||||
hashBytes := b.h.Sum(nil)
|
||||
_, err := b.iow.Write(hashBytes)
|
||||
if err != nil {
|
||||
b.closeWithErr(err)
|
||||
return 0, err
|
||||
}
|
||||
return b.iow.Write(p)
|
||||
n, err := b.iow.Write(p)
|
||||
if err != nil {
|
||||
b.closeWithErr(err)
|
||||
return n, err
|
||||
}
|
||||
return n, err
|
||||
}
|
||||
|
||||
func (b *streamingBitrotWriter) Close() error {
|
||||
@@ -77,13 +83,17 @@ func (b *streamingBitrotWriter) Close() error {
|
||||
return err
|
||||
}
|
||||
|
||||
// Returns streaming bitrot writer implementation.
|
||||
func newStreamingBitrotWriterBuffer(w io.Writer, algo BitrotAlgorithm, shardSize int64) io.WriteCloser {
|
||||
return &streamingBitrotWriter{iow: ioutil.NopCloser(w), h: algo.New(), shardSize: shardSize, canClose: nil}
|
||||
// newStreamingBitrotWriterBuffer returns streaming bitrot writer implementation.
|
||||
// The output is written to the supplied writer w.
|
||||
func newStreamingBitrotWriterBuffer(w io.Writer, algo BitrotAlgorithm, shardSize int64) io.Writer {
|
||||
return &streamingBitrotWriter{iow: ioutil.NopCloser(w), h: algo.New(), shardSize: shardSize, canClose: nil, closeWithErr: func(err error) error {
|
||||
// Similar to CloseWithError on pipes we always return nil.
|
||||
return nil
|
||||
}}
|
||||
}
|
||||
|
||||
// Returns streaming bitrot writer implementation.
|
||||
func newStreamingBitrotWriter(disk StorageAPI, volume, filePath string, length int64, algo BitrotAlgorithm, shardSize int64, heal bool) io.Writer {
|
||||
func newStreamingBitrotWriter(disk StorageAPI, volume, filePath string, length int64, algo BitrotAlgorithm, shardSize int64) io.Writer {
|
||||
r, w := io.Pipe()
|
||||
h := algo.New()
|
||||
|
||||
@@ -146,6 +156,11 @@ func (b *streamingBitrotReader) ReadAt(buf []byte, offset int64) (int, error) {
|
||||
streamOffset := (offset/b.shardSize)*int64(b.h.Size()) + offset
|
||||
if len(b.data) == 0 && b.tillOffset != streamOffset {
|
||||
b.rc, err = b.disk.ReadFileStream(context.TODO(), b.volume, b.filePath, streamOffset, b.tillOffset-streamOffset)
|
||||
if err != nil {
|
||||
logger.LogIf(GlobalContext,
|
||||
fmt.Errorf("Error(%w) reading erasure shards at (%s: %s/%s), will attempt to reconstruct if we have quorum",
|
||||
err, b.disk, b.volume, b.filePath))
|
||||
}
|
||||
} else {
|
||||
b.rc = io.NewSectionReader(bytes.NewReader(b.data), streamOffset, b.tillOffset-streamOffset)
|
||||
}
|
||||
@@ -153,7 +168,6 @@ func (b *streamingBitrotReader) ReadAt(buf []byte, offset int64) (int, error) {
|
||||
return 0, err
|
||||
}
|
||||
}
|
||||
|
||||
if offset != b.currOffset {
|
||||
// Can never happen unless there are programmer bugs
|
||||
return 0, errUnexpected
|
||||
|
||||
+10
-6
@@ -100,9 +100,9 @@ func BitrotAlgorithmFromString(s string) (a BitrotAlgorithm) {
|
||||
return
|
||||
}
|
||||
|
||||
func newBitrotWriter(disk StorageAPI, volume, filePath string, length int64, algo BitrotAlgorithm, shardSize int64, heal bool) io.Writer {
|
||||
func newBitrotWriter(disk StorageAPI, volume, filePath string, length int64, algo BitrotAlgorithm, shardSize int64) io.Writer {
|
||||
if algo == HighwayHash256S {
|
||||
return newStreamingBitrotWriter(disk, volume, filePath, length, algo, shardSize, heal)
|
||||
return newStreamingBitrotWriter(disk, volume, filePath, length, algo, shardSize)
|
||||
}
|
||||
return newWholeBitrotWriter(disk, volume, filePath, algo, shardSize)
|
||||
}
|
||||
@@ -164,7 +164,6 @@ func bitrotVerify(r io.Reader, wantSize, partSize int64, algo BitrotAlgorithm, w
|
||||
|
||||
h := algo.New()
|
||||
hashBuf := make([]byte, h.Size())
|
||||
buf := make([]byte, shardSize)
|
||||
left := wantSize
|
||||
|
||||
// Calculate the size of the bitrot file and compare
|
||||
@@ -173,6 +172,9 @@ func bitrotVerify(r io.Reader, wantSize, partSize int64, algo BitrotAlgorithm, w
|
||||
return errFileCorrupt
|
||||
}
|
||||
|
||||
bufp := xlPoolSmall.Get().(*[]byte)
|
||||
defer xlPoolSmall.Put(bufp)
|
||||
|
||||
for left > 0 {
|
||||
// Read expected hash...
|
||||
h.Reset()
|
||||
@@ -186,13 +188,15 @@ func bitrotVerify(r io.Reader, wantSize, partSize int64, algo BitrotAlgorithm, w
|
||||
if left < shardSize {
|
||||
shardSize = left
|
||||
}
|
||||
read, err := io.CopyBuffer(h, io.LimitReader(r, shardSize), buf)
|
||||
|
||||
read, err := io.CopyBuffer(h, io.LimitReader(r, shardSize), *bufp)
|
||||
if err != nil {
|
||||
// Read's failed for object with right size, at different offsets.
|
||||
return err
|
||||
return errFileCorrupt
|
||||
}
|
||||
|
||||
left -= read
|
||||
if !bytes.Equal(h.Sum(nil), hashBuf) {
|
||||
if !bytes.Equal(h.Sum(nil), hashBuf[:n]) {
|
||||
return errFileCorrupt
|
||||
}
|
||||
}
|
||||
|
||||
+1
-1
@@ -42,7 +42,7 @@ func testBitrotReaderWriterAlgo(t *testing.T, bitrotAlgo BitrotAlgorithm) {
|
||||
|
||||
disk.MakeVol(context.Background(), volume)
|
||||
|
||||
writer := newBitrotWriter(disk, volume, filePath, 35, bitrotAlgo, 10, false)
|
||||
writer := newBitrotWriter(disk, volume, filePath, 35, bitrotAlgo, 10)
|
||||
|
||||
_, err = writer.Write([]byte("aaaaaaaaaa"))
|
||||
if err != nil {
|
||||
|
||||
@@ -53,7 +53,7 @@ func validateBucketSSEConfig(r io.Reader) (*bucketsse.BucketSSEConfig, error) {
|
||||
return nil, err
|
||||
}
|
||||
|
||||
if len(encConfig.Rules) == 1 && encConfig.Rules[0].DefaultEncryptionAction.Algorithm == bucketsse.AES256 {
|
||||
if len(encConfig.Rules) == 1 {
|
||||
return encConfig, nil
|
||||
}
|
||||
|
||||
|
||||
@@ -19,7 +19,6 @@ package cmd
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"errors"
|
||||
"testing"
|
||||
)
|
||||
|
||||
@@ -47,12 +46,12 @@ func TestValidateBucketSSEConfig(t *testing.T) {
|
||||
<Rule>
|
||||
<ApplyServerSideEncryptionByDefault>
|
||||
<SSEAlgorithm>aws:kms</SSEAlgorithm>
|
||||
<KMSMasterKeyID>arn:aws:kms:us-east-1:1234/5678example</KMSMasterKeyID>
|
||||
<KMSMasterKeyID>my-key</KMSMasterKeyID>
|
||||
</ApplyServerSideEncryptionByDefault>
|
||||
</Rule>
|
||||
</ServerSideEncryptionConfiguration>`,
|
||||
expectedErr: errors.New("Unsupported bucket encryption configuration"),
|
||||
shouldPass: false,
|
||||
expectedErr: nil,
|
||||
shouldPass: true,
|
||||
},
|
||||
}
|
||||
|
||||
|
||||
+23
-22
@@ -992,12 +992,8 @@ func (api objectAPIHandlers) PostPolicyBucketHandler(w http.ResponseWriter, r *h
|
||||
var objectEncryptionKey crypto.ObjectKey
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
if _, err = globalBucketSSEConfigSys.Get(bucket); err == nil || globalAutoEncryption {
|
||||
// This request header needs to be set prior to setting ObjectOptions
|
||||
if !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
}
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(bucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
// get gateway encryption options
|
||||
var opts ObjectOptions
|
||||
@@ -1246,22 +1242,6 @@ func (api objectAPIHandlers) DeleteBucketHandler(w http.ResponseWriter, r *http.
|
||||
}
|
||||
}
|
||||
|
||||
deleteBucket := objectAPI.DeleteBucket
|
||||
|
||||
// Attempt to delete bucket.
|
||||
if err := deleteBucket(ctx, bucket, forceDelete); err != nil {
|
||||
if _, ok := err.(BucketNotEmpty); ok && (globalBucketVersioningSys.Enabled(bucket) || globalBucketVersioningSys.Suspended(bucket)) {
|
||||
apiErr := toAPIError(ctx, err)
|
||||
apiErr.Description = "The bucket you tried to delete is not empty. You must delete all versions in the bucket."
|
||||
writeErrorResponse(ctx, w, apiErr, r.URL, guessIsBrowserReq(r))
|
||||
} else {
|
||||
writeErrorResponse(ctx, w, toAPIError(ctx, err), r.URL, guessIsBrowserReq(r))
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
globalNotificationSys.DeleteBucketMetadata(ctx, bucket)
|
||||
|
||||
if globalDNSConfig != nil {
|
||||
if err := globalDNSConfig.Delete(bucket); err != nil {
|
||||
logger.LogIf(ctx, fmt.Errorf("Unable to delete bucket DNS entry %w, please delete it manually", err))
|
||||
@@ -1270,6 +1250,27 @@ func (api objectAPIHandlers) DeleteBucketHandler(w http.ResponseWriter, r *http.
|
||||
}
|
||||
}
|
||||
|
||||
deleteBucket := objectAPI.DeleteBucket
|
||||
|
||||
// Attempt to delete bucket.
|
||||
if err := deleteBucket(ctx, bucket, forceDelete); err != nil {
|
||||
apiErr := toAPIError(ctx, err)
|
||||
if _, ok := err.(BucketNotEmpty); ok {
|
||||
if globalBucketVersioningSys.Enabled(bucket) || globalBucketVersioningSys.Suspended(bucket) {
|
||||
apiErr.Description = "The bucket you tried to delete is not empty. You must delete all versions in the bucket."
|
||||
}
|
||||
}
|
||||
if globalDNSConfig != nil {
|
||||
if err2 := globalDNSConfig.Put(bucket); err2 != nil {
|
||||
logger.LogIf(ctx, fmt.Errorf("Unable to restore bucket DNS entry %w, pl1ease fix it manually", err2))
|
||||
}
|
||||
}
|
||||
writeErrorResponse(ctx, w, apiErr, r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
|
||||
globalNotificationSys.DeleteBucketMetadata(ctx, bucket)
|
||||
|
||||
// Write success response.
|
||||
writeSuccessNoContent(w)
|
||||
|
||||
|
||||
@@ -80,7 +80,7 @@ func (api objectAPIHandlers) PutBucketLifecycleHandler(w http.ResponseWriter, r
|
||||
}
|
||||
|
||||
// Validate the transition storage ARNs
|
||||
if err = validateLifecycleTransition(ctx, bucket, bucketLifecycle); err != nil {
|
||||
if err = validateTransitionTier(ctx, bucketLifecycle); err != nil {
|
||||
writeErrorResponse(ctx, w, toAPIError(ctx, err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
|
||||
+10
-21
@@ -20,6 +20,7 @@ package cmd
|
||||
import (
|
||||
"context"
|
||||
"encoding/xml"
|
||||
"errors"
|
||||
"fmt"
|
||||
"io"
|
||||
"net/http"
|
||||
@@ -175,28 +176,16 @@ func initBackgroundTransition(ctx context.Context, objectAPI ObjectLayer) {
|
||||
}
|
||||
}
|
||||
|
||||
func validateLifecycleTransition(ctx context.Context, bucket string, lfc *lifecycle.Lifecycle) error {
|
||||
for _, rule := range lfc.Rules {
|
||||
if rule.Transition.StorageClass != "" {
|
||||
err := validateTransitionDestination(rule.Transition.StorageClass)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
}
|
||||
return nil
|
||||
}
|
||||
var errInvalidStorageClass = errors.New("invalid storage class")
|
||||
|
||||
// validateTransitionDestination returns error if transition destination bucket missing or not configured
|
||||
// It also returns true if transition destination is same as this server.
|
||||
func validateTransitionDestination(sc string) error {
|
||||
backend, err := globalTierConfigMgr.getDriver(sc)
|
||||
if err != nil {
|
||||
return TransitionStorageClassNotFound{}
|
||||
}
|
||||
_, err = backend.Get(context.Background(), "probeobject", WarmBackendGetOpts{})
|
||||
if !isErrObjectNotFound(err) {
|
||||
return err
|
||||
func validateTransitionTier(ctx context.Context, lfc *lifecycle.Lifecycle) error {
|
||||
for _, rule := range lfc.Rules {
|
||||
if rule.Transition.StorageClass == "" {
|
||||
continue
|
||||
}
|
||||
if valid := globalTierConfigMgr.IsTierValid(rule.Transition.StorageClass); !valid {
|
||||
return errInvalidStorageClass
|
||||
}
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
@@ -18,6 +18,8 @@
|
||||
package cmd
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"net/http"
|
||||
"testing"
|
||||
"time"
|
||||
@@ -214,3 +216,33 @@ func TestObjectIsRemote(t *testing.T) {
|
||||
t.Fatalf("Expected object not to be remote but got %v", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestValidateTransitionTier(t *testing.T) {
|
||||
globalTierConfigMgr = NewTierConfigMgr()
|
||||
testCases := []struct {
|
||||
xml []byte
|
||||
expectedErr error
|
||||
}{
|
||||
{
|
||||
// non-existent storage-class
|
||||
xml: []byte(`<LifecycleConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Rule><ID>rule</ID><Prefix /><Status>Enabled</Status><Transition><Days>1</Days><StorageClass>"NONEXISTENT"</StorageClass></Transition></Rule></LifecycleConfiguration>`),
|
||||
expectedErr: errInvalidStorageClass,
|
||||
},
|
||||
{
|
||||
// no transition rule
|
||||
xml: []byte(`<LifecycleConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Rule><ID>rule</ID><Prefix /><Status>Enabled</Status><Expiration><Days>1</Days></Expiration></Rule></LifecycleConfiguration>`),
|
||||
expectedErr: nil,
|
||||
},
|
||||
}
|
||||
for i, tc := range testCases {
|
||||
lc, err := lifecycle.ParseLifecycleConfig(bytes.NewReader(tc.xml))
|
||||
if err != nil {
|
||||
t.Fatalf("Test %d: Failed to parse lifecycle config %v", i+1, err)
|
||||
}
|
||||
|
||||
err = validateTransitionTier(context.Background(), lc)
|
||||
if err != tc.expectedErr {
|
||||
t.Fatalf("Test %d: Expected %v but got %v", i+1, tc.expectedErr, err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
@@ -95,28 +95,28 @@ func mustReplicateWeb(ctx context.Context, r *http.Request, bucket, object strin
|
||||
if permErr != ErrNone {
|
||||
return
|
||||
}
|
||||
return mustReplicater(ctx, bucket, object, meta, replStatus)
|
||||
return mustReplicater(ctx, bucket, object, meta, replStatus, false)
|
||||
}
|
||||
|
||||
// mustReplicate returns 2 booleans - true if object meets replication criteria and true if replication is to be done in
|
||||
// a synchronous manner.
|
||||
func mustReplicate(ctx context.Context, r *http.Request, bucket, object string, meta map[string]string, replStatus string) (replicate bool, sync bool) {
|
||||
func mustReplicate(ctx context.Context, r *http.Request, bucket, object string, meta map[string]string, replStatus string, metadataOnly bool) (replicate bool, sync bool) {
|
||||
if s3Err := isPutActionAllowed(ctx, getRequestAuthType(r), bucket, "", r, iampolicy.GetReplicationConfigurationAction); s3Err != ErrNone {
|
||||
return
|
||||
}
|
||||
return mustReplicater(ctx, bucket, object, meta, replStatus)
|
||||
return mustReplicater(ctx, bucket, object, meta, replStatus, metadataOnly)
|
||||
}
|
||||
|
||||
// mustReplicater returns 2 booleans - true if object meets replication criteria and true if replication is to be done in
|
||||
// a synchronous manner.
|
||||
func mustReplicater(ctx context.Context, bucket, object string, meta map[string]string, replStatus string) (replicate bool, sync bool) {
|
||||
func mustReplicater(ctx context.Context, bucket, object string, meta map[string]string, replStatus string, metadataOnly bool) (replicate bool, sync bool) {
|
||||
if globalIsGateway {
|
||||
return replicate, sync
|
||||
}
|
||||
if rs, ok := meta[xhttp.AmzBucketReplicationStatus]; ok {
|
||||
replStatus = rs
|
||||
}
|
||||
if replication.StatusType(replStatus) == replication.Replica {
|
||||
if replication.StatusType(replStatus) == replication.Replica && !metadataOnly {
|
||||
return replicate, sync
|
||||
}
|
||||
cfg, err := getReplicationConfig(ctx, bucket)
|
||||
@@ -124,8 +124,9 @@ func mustReplicater(ctx context.Context, bucket, object string, meta map[string]
|
||||
return replicate, sync
|
||||
}
|
||||
opts := replication.ObjectOpts{
|
||||
Name: object,
|
||||
SSEC: crypto.SSEC.IsEncrypted(meta),
|
||||
Name: object,
|
||||
SSEC: crypto.SSEC.IsEncrypted(meta),
|
||||
Replica: replication.StatusType(replStatus) == replication.Replica,
|
||||
}
|
||||
tagStr, ok := meta[xhttp.AmzObjectTagging]
|
||||
if ok {
|
||||
|
||||
+12
-9
@@ -38,6 +38,7 @@ import (
|
||||
"github.com/fatih/color"
|
||||
dns2 "github.com/miekg/dns"
|
||||
"github.com/minio/cli"
|
||||
"github.com/minio/kes"
|
||||
"github.com/minio/minio-go/v7/pkg/set"
|
||||
"github.com/minio/minio/cmd/config"
|
||||
xhttp "github.com/minio/minio/cmd/http"
|
||||
@@ -244,14 +245,7 @@ func handleCommonCmdArgs(ctx *cli.Context) {
|
||||
}
|
||||
|
||||
func handleCommonEnvVars() {
|
||||
wormEnabled, err := config.LookupWorm()
|
||||
if err != nil {
|
||||
logger.Fatal(config.ErrInvalidWormValue(err), "Invalid worm configuration")
|
||||
}
|
||||
if wormEnabled {
|
||||
logger.Fatal(errors.New("WORM is deprecated"), "global MINIO_WORM support is removed, please downgrade your server or migrate to https://github.com/minio/minio/tree/master/docs/retention")
|
||||
}
|
||||
|
||||
var err error
|
||||
globalBrowserEnabled, err = config.ParseBool(env.Get(config.EnvBrowser, config.EnableOn))
|
||||
if err != nil {
|
||||
logger.Fatal(config.ErrInvalidBrowserValue(err), "Invalid MINIO_BROWSER value in environment variable")
|
||||
@@ -387,15 +381,24 @@ func handleCommonEnvVars() {
|
||||
logger.Fatal(err, fmt.Sprintf("Unable to load X.509 root CAs for KES from %q", env.Get(config.EnvKESServerCA, globalCertsCADir.Get())))
|
||||
}
|
||||
|
||||
var defaultKeyID = env.Get(config.EnvKESKeyName, "")
|
||||
KMS, err := kms.NewWithConfig(kms.Config{
|
||||
Endpoints: endpoints,
|
||||
DefaultKeyID: env.Get(config.EnvKESKeyName, ""),
|
||||
DefaultKeyID: defaultKeyID,
|
||||
Certificate: certificate,
|
||||
RootCAs: rootCAs,
|
||||
})
|
||||
if err != nil {
|
||||
logger.Fatal(err, "Unable to initialize a connection to KES as specified by the shell environment")
|
||||
}
|
||||
|
||||
// We check that the default key ID exists or try to create it otherwise.
|
||||
// This implicitly checks that we can communicate to KES. We don't treat
|
||||
// a policy error as failure condition since MinIO may not have the permission
|
||||
// to create keys - just to generate/decrypt data encryption keys.
|
||||
if err = KMS.CreateKey(defaultKeyID); err != nil && !errors.Is(err, kes.ErrKeyExists) && !errors.Is(err, kes.ErrNotAllowed) {
|
||||
logger.Fatal(err, "Unable to initialize a connection to KES as specified by the shell environment")
|
||||
}
|
||||
GlobalKMS = KMS
|
||||
}
|
||||
if tiers := env.Get("_MINIO_DEBUG_REMOTE_TIERS_IMMEDIATELY", ""); tiers != "" {
|
||||
|
||||
+2
-20
@@ -28,7 +28,6 @@ import (
|
||||
"github.com/minio/madmin-go"
|
||||
"github.com/minio/minio/cmd/config"
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
"github.com/minio/minio/pkg/auth"
|
||||
"github.com/minio/minio/pkg/kms"
|
||||
etcd "go.etcd.io/etcd/clientv3"
|
||||
)
|
||||
@@ -64,23 +63,6 @@ func checkBackendEncrypted(objAPI ObjectLayer) (bool, error) {
|
||||
return err == nil && bytes.Equal(data, backendEncryptedMigrationComplete), nil
|
||||
}
|
||||
|
||||
// decryptData - decrypts input data with more that one credentials,
|
||||
func decryptData(edata []byte, creds ...auth.Credentials) ([]byte, error) {
|
||||
var err error
|
||||
var data []byte
|
||||
for _, cred := range creds {
|
||||
data, err = madmin.DecryptData(cred.String(), bytes.NewReader(edata))
|
||||
if err != nil {
|
||||
if err == madmin.ErrMaliciousData {
|
||||
continue
|
||||
}
|
||||
return nil, err
|
||||
}
|
||||
break
|
||||
}
|
||||
return data, err
|
||||
}
|
||||
|
||||
func migrateIAMConfigsEtcdToEncrypted(ctx context.Context, client *etcd.Client) error {
|
||||
encrypted, err := checkBackendEtcdEncrypted(ctx, client)
|
||||
if err != nil {
|
||||
@@ -115,7 +97,7 @@ func migrateIAMConfigsEtcdToEncrypted(ctx context.Context, client *etcd.Client)
|
||||
}
|
||||
|
||||
if !utf8.Valid(data) {
|
||||
data, err = decryptData(data, globalActiveCred)
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return fmt.Errorf("Decrypting config failed %w, possibly credentials are incorrect", err)
|
||||
}
|
||||
@@ -170,7 +152,7 @@ func migrateConfigPrefixToEncrypted(objAPI ObjectLayer, encrypted bool) error {
|
||||
}
|
||||
|
||||
if !utf8.Valid(data) {
|
||||
data, err = decryptData(data, globalActiveCred)
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return fmt.Errorf("Decrypting config failed %w, possibly credentials are incorrect", err)
|
||||
}
|
||||
|
||||
@@ -49,17 +49,17 @@ func TestDecryptData(t *testing.T) {
|
||||
|
||||
tests := []struct {
|
||||
edata []byte
|
||||
creds []auth.Credentials
|
||||
cred auth.Credentials
|
||||
success bool
|
||||
}{
|
||||
{edata1, []auth.Credentials{cred1, cred2}, true},
|
||||
{edata2, []auth.Credentials{cred1, cred2}, true},
|
||||
{data, []auth.Credentials{cred1, cred2}, false},
|
||||
{edata1, cred1, true},
|
||||
{edata2, cred2, true},
|
||||
{data, cred1, false},
|
||||
}
|
||||
|
||||
for _, test := range tests {
|
||||
t.Run("", func(t *testing.T) {
|
||||
ddata, err := decryptData(test.edata, test.creds...)
|
||||
ddata, err := madmin.DecryptData(test.cred.String(), bytes.NewReader(test.edata))
|
||||
if err != nil && test.success {
|
||||
t.Errorf("Expected success, saw failure %v", err)
|
||||
}
|
||||
|
||||
@@ -127,12 +127,6 @@ var (
|
||||
`Detected encrypted config backend, correct access and secret keys should be specified via environment variables MINIO_ROOT_USER and MINIO_ROOT_PASSWORD to be able to decrypt the MinIO config, user IAM and policies`,
|
||||
)
|
||||
|
||||
ErrMissingCredentialsBackendEncrypted = newErrFn(
|
||||
"Credentials missing",
|
||||
"Please set your credentials in the environment",
|
||||
`Detected encrypted config backend, access and secret keys should be specified via environment variables MINIO_ROOT_USER and MINIO_ROOT_PASSWORD to be able to decrypt the MinIO config, user IAM and policies`,
|
||||
)
|
||||
|
||||
ErrInvalidCredentials = newErrFn(
|
||||
"Invalid credentials",
|
||||
"Please provide correct credentials",
|
||||
@@ -145,12 +139,6 @@ var (
|
||||
`In Gateway mode, access and secret keys should be specified via environment variables MINIO_ROOT_USER and MINIO_ROOT_PASSWORD respectively`,
|
||||
)
|
||||
|
||||
ErrEnvCredentialsMissingDistributed = newErrFn(
|
||||
"Credentials missing",
|
||||
"Please set your credentials in the environment",
|
||||
`In distributed server mode, access and secret keys should be specified via environment variables MINIO_ROOT_USER and MINIO_ROOT_PASSWORD respectively`,
|
||||
)
|
||||
|
||||
ErrInvalidErasureEndpoints = newErrFn(
|
||||
"Invalid endpoint(s) in erasure mode",
|
||||
"Please provide correct combination of local/remote paths",
|
||||
|
||||
+287
-270
@@ -45,9 +45,12 @@ import (
|
||||
)
|
||||
|
||||
const (
|
||||
dataScannerSleepPerFolder = 20 * time.Millisecond // Time to wait between folders.
|
||||
dataScannerStartDelay = 1 * time.Minute // Time to wait on startup and between cycles.
|
||||
dataUsageUpdateDirCycles = 16 // Visit all folders every n cycles.
|
||||
dataScannerSleepPerFolder = time.Millisecond // Time to wait between folders.
|
||||
dataUsageUpdateDirCycles = 16 // Visit all folders every n cycles.
|
||||
dataScannerCompactLeastObject = 500 // Compact when there is less than this many objects in a branch.
|
||||
dataScannerCompactAtChildren = 10000 // Compact when there are this many children in a branch.
|
||||
dataScannerCompactAtFolders = dataScannerCompactAtChildren / 4 // Compact when this many subfolders in a single folder.
|
||||
dataScannerStartDelay = 1 * time.Minute // Time to wait on startup and between cycles.
|
||||
|
||||
healDeleteDangling = true
|
||||
healFolderIncludeProb = 32 // Include a clean folder one in n cycles.
|
||||
@@ -146,7 +149,6 @@ func runDataScanner(pctx context.Context, objAPI ObjectLayer) {
|
||||
bf, err := globalNotificationSys.updateBloomFilter(ctx, nextBloomCycle)
|
||||
logger.LogIf(ctx, err)
|
||||
err = objAPI.NSScanner(ctx, bf, results)
|
||||
close(results)
|
||||
logger.LogIf(ctx, err)
|
||||
if err == nil {
|
||||
// Store new cycle...
|
||||
@@ -175,21 +177,63 @@ type cachedFolder struct {
|
||||
}
|
||||
|
||||
type folderScanner struct {
|
||||
root string
|
||||
getSize getSizeFn
|
||||
oldCache dataUsageCache
|
||||
newCache dataUsageCache
|
||||
withFilter *bloomFilter
|
||||
root string
|
||||
getSize getSizeFn
|
||||
oldCache dataUsageCache
|
||||
newCache dataUsageCache
|
||||
updateCache dataUsageCache
|
||||
withFilter *bloomFilter
|
||||
|
||||
dataUsageScannerDebug bool
|
||||
healFolderInclude uint32 // Include a clean folder one in n cycles.
|
||||
healObjectSelect uint32 // Do a heal check on an object once every n cycles. Must divide into healFolderInclude
|
||||
|
||||
newFolders []cachedFolder
|
||||
existingFolders []cachedFolder
|
||||
disks []StorageAPI
|
||||
disks []StorageAPI
|
||||
|
||||
// If set updates will be sent regularly to this channel.
|
||||
// Will not be closed when returned.
|
||||
updates chan<- dataUsageEntry
|
||||
lastUpdate time.Time
|
||||
}
|
||||
|
||||
// Cache structure and compaction:
|
||||
//
|
||||
// A cache structure will be kept with a tree of usages.
|
||||
// The cache is a tree structure where each keeps track of its children.
|
||||
//
|
||||
// An uncompacted branch contains a count of the files only directly at the
|
||||
// branch level, and contains link to children branches or leaves.
|
||||
//
|
||||
// The leaves are "compacted" based on a number of properties.
|
||||
// A compacted leaf contains the totals of all files beneath it.
|
||||
//
|
||||
// A leaf is only scanned once every dataUsageUpdateDirCycles,
|
||||
// rarer if the bloom filter for the path is clean and no lifecycles are applied.
|
||||
// Skipped leaves have their totals transferred from the previous cycle.
|
||||
//
|
||||
// A clean leaf will be included once every healFolderIncludeProb for partial heal scans.
|
||||
// When selected there is a one in healObjectSelectProb that any object will be chosen for heal scan.
|
||||
//
|
||||
// Compaction happens when either:
|
||||
//
|
||||
// 1) The folder (and subfolders) contains less than dataScannerCompactLeastObject objects.
|
||||
// 2) The folder itself contains more than dataScannerCompactAtFolders folders.
|
||||
// 3) The folder only contains objects and no subfolders.
|
||||
//
|
||||
// A bucket root will never be compacted.
|
||||
//
|
||||
// Furthermore if a has more than dataScannerCompactAtChildren recursive children (uncompacted folders)
|
||||
// the tree will be recursively scanned and the branches with the least number of objects will be
|
||||
// compacted until the limit is reached.
|
||||
//
|
||||
// This ensures that any branch will never contain an unreasonable amount of other branches,
|
||||
// and also that small branches with few objects don't take up unreasonable amounts of space.
|
||||
// This keeps the cache size at a reasonable size for all buckets.
|
||||
//
|
||||
// Whenever a branch is scanned, it is assumed that it will be un-compacted
|
||||
// before it hits any of the above limits.
|
||||
// This will make the branch rebalance itself when scanned if the distribution of objects has changed.
|
||||
|
||||
// scanDataFolder will scanner the basepath+cache.Info.Name and return an updated cache.
|
||||
// The returned cache will always be valid, but may not be updated from the existing.
|
||||
// Before each operation sleepDuration is called which can be used to temporarily halt the scanner.
|
||||
@@ -211,18 +255,16 @@ func scanDataFolder(ctx context.Context, basePath string, cache dataUsageCache,
|
||||
return cache, errors.New("internal error: root scan attempted")
|
||||
}
|
||||
|
||||
skipHeal := cache.Info.SkipHealing
|
||||
|
||||
s := folderScanner{
|
||||
root: basePath,
|
||||
getSize: getSize,
|
||||
oldCache: cache,
|
||||
newCache: dataUsageCache{Info: cache.Info},
|
||||
newFolders: nil,
|
||||
existingFolders: nil,
|
||||
updateCache: dataUsageCache{Info: cache.Info},
|
||||
dataUsageScannerDebug: intDataUpdateTracker.debug,
|
||||
healFolderInclude: 0,
|
||||
healObjectSelect: 0,
|
||||
updates: cache.Info.updates,
|
||||
}
|
||||
|
||||
// Add disks for set healing.
|
||||
@@ -238,7 +280,7 @@ func scanDataFolder(ctx context.Context, basePath string, cache dataUsageCache,
|
||||
}
|
||||
|
||||
// Enable healing in XL mode.
|
||||
if globalIsErasure {
|
||||
if globalIsErasure && !cache.Info.SkipHealing {
|
||||
// Include a clean folder one in n cycles.
|
||||
s.healFolderInclude = healFolderIncludeProb
|
||||
// Do a heal check on an object once every n cycles. Must divide into healFolderInclude
|
||||
@@ -257,139 +299,70 @@ func scanDataFolder(ctx context.Context, basePath string, cache dataUsageCache,
|
||||
}
|
||||
|
||||
done := ctx.Done()
|
||||
var flattenLevels = 2
|
||||
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Cycle: %v, Entries: %v %s\n", cache.Info.NextCycle, len(cache.Cache), logSuffix)
|
||||
}
|
||||
|
||||
// Always scan flattenLevels deep. Cache root is level 0.
|
||||
todo := []cachedFolder{{name: cache.Info.Name, objectHealProbDiv: 1}}
|
||||
for i := 0; i < flattenLevels; i++ {
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Level %v, scanning %v directories. %s\n", i, len(todo), logSuffix)
|
||||
}
|
||||
select {
|
||||
case <-done:
|
||||
return cache, ctx.Err()
|
||||
default:
|
||||
}
|
||||
var err error
|
||||
todo, err = s.scanQueuedLevels(ctx, todo, i == flattenLevels-1, skipHeal)
|
||||
if err != nil {
|
||||
// No useful information...
|
||||
return cache, err
|
||||
}
|
||||
// Read top level in bucket.
|
||||
select {
|
||||
case <-done:
|
||||
return cache, ctx.Err()
|
||||
default:
|
||||
}
|
||||
root := dataUsageEntry{}
|
||||
folder := cachedFolder{name: cache.Info.Name, objectHealProbDiv: 1}
|
||||
err := s.scanFolder(ctx, folder, &root)
|
||||
if err != nil {
|
||||
// No useful information...
|
||||
return cache, err
|
||||
}
|
||||
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"New folders: %v %s\n", s.newFolders, logSuffix)
|
||||
}
|
||||
|
||||
// Add new folders first
|
||||
for _, folder := range s.newFolders {
|
||||
select {
|
||||
case <-done:
|
||||
return s.newCache, ctx.Err()
|
||||
default:
|
||||
}
|
||||
du, err := s.deepScanFolder(ctx, folder, skipHeal)
|
||||
if err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
continue
|
||||
}
|
||||
if du == nil {
|
||||
console.Debugln(logPrefix + "no disk usage provided" + logSuffix)
|
||||
continue
|
||||
}
|
||||
|
||||
s.newCache.replace(folder.name, "", *du)
|
||||
// Add to parent manually
|
||||
if folder.parent != nil {
|
||||
parent := s.newCache.Cache[folder.parent.Key()]
|
||||
parent.addChildString(folder.name)
|
||||
}
|
||||
}
|
||||
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Existing folders: %v %s\n", len(s.existingFolders), logSuffix)
|
||||
}
|
||||
|
||||
// Do selective scanning of existing folders.
|
||||
for _, folder := range s.existingFolders {
|
||||
select {
|
||||
case <-done:
|
||||
return s.newCache, ctx.Err()
|
||||
default:
|
||||
}
|
||||
h := hashPath(folder.name)
|
||||
if !h.mod(s.oldCache.Info.NextCycle, dataUsageUpdateDirCycles) {
|
||||
if !h.mod(s.oldCache.Info.NextCycle, s.healFolderInclude/folder.objectHealProbDiv) {
|
||||
s.newCache.replaceHashed(h, folder.parent, s.oldCache.Cache[h.Key()])
|
||||
continue
|
||||
} else {
|
||||
folder.objectHealProbDiv = s.healFolderInclude
|
||||
}
|
||||
folder.objectHealProbDiv = dataUsageUpdateDirCycles
|
||||
}
|
||||
if s.withFilter != nil {
|
||||
_, prefix := path2BucketObjectWithBasePath(basePath, folder.name)
|
||||
if s.oldCache.Info.lifeCycle == nil || !s.oldCache.Info.lifeCycle.HasActiveRules(prefix, true) {
|
||||
// If folder isn't in filter, skip it completely.
|
||||
if !s.withFilter.containsDir(folder.name) {
|
||||
if !h.mod(s.oldCache.Info.NextCycle, s.healFolderInclude/folder.objectHealProbDiv) {
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Skipping non-updated folder: %v %s\n", folder, logSuffix)
|
||||
}
|
||||
s.newCache.replaceHashed(h, folder.parent, s.oldCache.Cache[h.Key()])
|
||||
continue
|
||||
} else {
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Adding non-updated folder to heal check: %v %s\n", folder.name, logSuffix)
|
||||
}
|
||||
// Update probability of including objects
|
||||
folder.objectHealProbDiv = s.healFolderInclude
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// Update on this cycle...
|
||||
du, err := s.deepScanFolder(ctx, folder, skipHeal)
|
||||
if err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
continue
|
||||
}
|
||||
if du == nil {
|
||||
logger.LogIf(ctx, errors.New("data-usage: no disk usage provided"))
|
||||
continue
|
||||
}
|
||||
s.newCache.replaceHashed(h, folder.parent, *du)
|
||||
}
|
||||
if s.dataUsageScannerDebug {
|
||||
console.Debugf(logPrefix+"Finished scanner, %v entries %s\n", len(s.newCache.Cache), logSuffix)
|
||||
console.Debugf(logPrefix+"Finished scanner, %v entries (%+v) %s \n", len(s.newCache.Cache), *s.newCache.sizeRecursive(s.newCache.Info.Name), logSuffix)
|
||||
}
|
||||
s.newCache.Info.LastUpdate = UTCNow()
|
||||
s.newCache.Info.NextCycle++
|
||||
return s.newCache, nil
|
||||
}
|
||||
|
||||
// scanQueuedLevels will scan the provided folders.
|
||||
// sendUpdate() should be called on a regular basis when the newCache contains more recent total than previously.
|
||||
// May or may not send an update upstream.
|
||||
func (f *folderScanner) sendUpdate() {
|
||||
// Send at most an update every minute.
|
||||
if f.updates == nil || time.Since(f.lastUpdate) < time.Minute {
|
||||
return
|
||||
}
|
||||
if flat := f.updateCache.sizeRecursive(f.newCache.Info.Name); flat != nil {
|
||||
select {
|
||||
case f.updates <- *flat:
|
||||
default:
|
||||
}
|
||||
f.lastUpdate = time.Now()
|
||||
}
|
||||
}
|
||||
|
||||
// scanFolder will scan the provided folder.
|
||||
// Files found in the folders will be added to f.newCache.
|
||||
// If final is provided folders will be put into f.newFolders or f.existingFolders.
|
||||
// If final is not provided the folders found are returned from the function.
|
||||
func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFolder, final bool, skipHeal bool) ([]cachedFolder, error) {
|
||||
var nextFolders []cachedFolder
|
||||
func (f *folderScanner) scanFolder(ctx context.Context, folder cachedFolder, into *dataUsageEntry) error {
|
||||
done := ctx.Done()
|
||||
scannerLogPrefix := color.Green("folder-scanner:")
|
||||
for _, folder := range folders {
|
||||
thisHash := hashPath(folder.name)
|
||||
// Store initial compaction state.
|
||||
wasCompacted := into.Compacted
|
||||
|
||||
for {
|
||||
select {
|
||||
case <-done:
|
||||
return nil, ctx.Err()
|
||||
return ctx.Err()
|
||||
default:
|
||||
}
|
||||
thisHash := hashPath(folder.name)
|
||||
existing := f.oldCache.findChildrenCopy(thisHash)
|
||||
existing, ok := f.oldCache.Cache[thisHash.Key()]
|
||||
var abandonedChildren dataUsageHashMap
|
||||
if !into.Compacted {
|
||||
abandonedChildren = f.oldCache.findChildrenCopy(thisHash)
|
||||
}
|
||||
|
||||
// If there are lifecycle rules for the prefix, remove the filter.
|
||||
filter := f.withFilter
|
||||
@@ -402,28 +375,30 @@ func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFo
|
||||
activeLifeCycle = f.oldCache.Info.lifeCycle
|
||||
filter = nil
|
||||
}
|
||||
if _, ok := f.oldCache.Cache[thisHash.Key()]; filter != nil && ok {
|
||||
|
||||
// Check if we can skip it due to bloom filter...
|
||||
if filter != nil && ok && existing.Compacted {
|
||||
// If folder isn't in filter and we have data, skip it completely.
|
||||
if folder.name != dataUsageRoot && !filter.containsDir(folder.name) {
|
||||
if !thisHash.mod(f.oldCache.Info.NextCycle, f.healFolderInclude/folder.objectHealProbDiv) {
|
||||
if f.healObjectSelect == 0 || !thisHash.mod(f.oldCache.Info.NextCycle, f.healFolderInclude/folder.objectHealProbDiv) {
|
||||
f.newCache.copyWithChildren(&f.oldCache, thisHash, folder.parent)
|
||||
f.updateCache.copyWithChildren(&f.oldCache, thisHash, folder.parent)
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(scannerLogPrefix+" Skipping non-updated folder: %v\n", folder.name)
|
||||
}
|
||||
continue
|
||||
} else {
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(scannerLogPrefix+" Adding non-updated folder to heal check: %v\n", folder.name)
|
||||
}
|
||||
// If probability was already scannerHealFolderInclude, keep it.
|
||||
folder.objectHealProbDiv = f.healFolderInclude
|
||||
return nil
|
||||
}
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(scannerLogPrefix+" Adding non-updated folder to heal check: %v\n", folder.name)
|
||||
}
|
||||
// If probability was already scannerHealFolderInclude, keep it.
|
||||
folder.objectHealProbDiv = f.healFolderInclude
|
||||
}
|
||||
}
|
||||
scannerSleeper.Sleep(ctx, dataScannerSleepPerFolder)
|
||||
|
||||
cache := dataUsageEntry{}
|
||||
|
||||
var existingFolders, newFolders []cachedFolder
|
||||
var foundObjects bool
|
||||
err := readDirFn(path.Join(f.root, folder.name), func(entName string, typ os.FileMode) error {
|
||||
// Parse
|
||||
entName = pathClean(path.Join(folder.name, entName))
|
||||
@@ -455,26 +430,16 @@ func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFo
|
||||
}
|
||||
|
||||
if typ&os.ModeDir != 0 {
|
||||
scannerSleeper.Sleep(ctx, dataScannerSleepPerFolder)
|
||||
|
||||
h := hashPath(entName)
|
||||
_, exists := f.oldCache.Cache[h.Key()]
|
||||
cache.addChildString(entName)
|
||||
|
||||
this := cachedFolder{name: entName, parent: &thisHash, objectHealProbDiv: folder.objectHealProbDiv}
|
||||
|
||||
delete(existing, h.Key()) // h.Key() already accounted for.
|
||||
|
||||
cache.addChild(h)
|
||||
|
||||
if final {
|
||||
if exists {
|
||||
f.existingFolders = append(f.existingFolders, this)
|
||||
} else {
|
||||
f.newFolders = append(f.newFolders, this)
|
||||
}
|
||||
delete(abandonedChildren, h.Key()) // h.Key() already accounted for.
|
||||
if exists {
|
||||
existingFolders = append(existingFolders, this)
|
||||
f.updateCache.copyWithChildren(&f.oldCache, h, &thisHash)
|
||||
} else {
|
||||
nextFolders = append(nextFolders, this)
|
||||
newFolders = append(newFolders, this)
|
||||
}
|
||||
return nil
|
||||
}
|
||||
@@ -497,54 +462,144 @@ func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFo
|
||||
// if the drive belongs to an erasure set
|
||||
// that is already being healed, skip the
|
||||
// healing attempt on this drive.
|
||||
item.heal = item.heal && !skipHeal
|
||||
item.heal = item.heal && f.healObjectSelect > 0
|
||||
|
||||
sizeSummary, err := f.getSize(item)
|
||||
sz, err := f.getSize(item)
|
||||
if err == errSkipFile {
|
||||
wait() // wait to proceed to next entry.
|
||||
|
||||
return nil
|
||||
}
|
||||
|
||||
// successfully read means we have a valid object.
|
||||
|
||||
foundObjects = true
|
||||
// Remove filename i.e is the meta file to construct object name
|
||||
item.transformMetaDir()
|
||||
|
||||
// Object already accounted for, remove from heal map,
|
||||
// simply because getSize() function already heals the
|
||||
// object.
|
||||
delete(existing, path.Join(item.bucket, item.objectPath()))
|
||||
delete(abandonedChildren, path.Join(item.bucket, item.objectPath()))
|
||||
|
||||
cache.addSizes(sizeSummary)
|
||||
cache.Objects++
|
||||
cache.ObjSizes.add(sizeSummary.totalSize)
|
||||
into.addSizes(sz)
|
||||
into.Objects++
|
||||
|
||||
wait() // wait to proceed to next entry.
|
||||
|
||||
return nil
|
||||
})
|
||||
if err != nil {
|
||||
return nil, err
|
||||
return err
|
||||
}
|
||||
|
||||
if f.healObjectSelect == 0 {
|
||||
// If we are not scanning, return now.
|
||||
f.newCache.replaceHashed(thisHash, folder.parent, cache)
|
||||
continue
|
||||
if foundObjects && globalIsErasure {
|
||||
// If we found an object in erasure mode, we skip subdirs (only datadirs)...
|
||||
break
|
||||
}
|
||||
|
||||
// If we have many subfolders, compact ourself.
|
||||
if !into.Compacted &&
|
||||
f.newCache.Info.Name != folder.name &&
|
||||
len(existingFolders)+len(newFolders) >= dataScannerCompactAtFolders {
|
||||
into.Compacted = true
|
||||
newFolders = append(newFolders, existingFolders...)
|
||||
existingFolders = nil
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(scannerLogPrefix+" Preemptively compacting: %v, entries: %v\n", folder.name, len(existingFolders)+len(newFolders))
|
||||
}
|
||||
}
|
||||
|
||||
scanFolder := func(folder cachedFolder) {
|
||||
if contextCanceled(ctx) {
|
||||
return
|
||||
}
|
||||
dst := into
|
||||
if !into.Compacted {
|
||||
dst = &dataUsageEntry{Compacted: false}
|
||||
}
|
||||
if err := f.scanFolder(ctx, folder, dst); err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
return
|
||||
}
|
||||
if !into.Compacted {
|
||||
into.addChild(dataUsageHash(folder.name))
|
||||
}
|
||||
// We scanned a folder, optionally send update.
|
||||
f.sendUpdate()
|
||||
}
|
||||
|
||||
// Scan new...
|
||||
for _, folder := range newFolders {
|
||||
h := hashPath(folder.name)
|
||||
// Add new folders to the update tree so totals update for these.
|
||||
if !into.Compacted {
|
||||
var foundAny bool
|
||||
parent := thisHash
|
||||
for parent != hashPath(f.updateCache.Info.Name) {
|
||||
e := f.updateCache.find(parent.Key())
|
||||
if e == nil || e.Compacted {
|
||||
foundAny = true
|
||||
break
|
||||
}
|
||||
if next := f.updateCache.searchParent(parent); next == nil {
|
||||
foundAny = true
|
||||
break
|
||||
} else {
|
||||
parent = *next
|
||||
}
|
||||
}
|
||||
if !foundAny {
|
||||
// Add non-compacted empty entry.
|
||||
f.updateCache.replaceHashed(h, &thisHash, dataUsageEntry{})
|
||||
}
|
||||
}
|
||||
scanFolder(folder)
|
||||
// Add new folders if this is new and we don't have existing.
|
||||
if !into.Compacted {
|
||||
parent := f.updateCache.find(thisHash.Key())
|
||||
if parent != nil && !parent.Compacted {
|
||||
f.updateCache.deleteRecursive(h)
|
||||
f.updateCache.copyWithChildren(&f.newCache, h, &thisHash)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// Scan existing...
|
||||
for _, folder := range existingFolders {
|
||||
h := hashPath(folder.name)
|
||||
// Check if we should skip scanning folder...
|
||||
// We can only skip if we are not indexing into a compacted destination
|
||||
// and the entry itself is compacted.
|
||||
if !into.Compacted && f.oldCache.isCompacted(h) {
|
||||
if !h.mod(f.oldCache.Info.NextCycle, dataUsageUpdateDirCycles) {
|
||||
if f.healObjectSelect == 0 || !h.mod(f.oldCache.Info.NextCycle, f.healFolderInclude/folder.objectHealProbDiv) {
|
||||
// Transfer and add as child...
|
||||
f.newCache.copyWithChildren(&f.oldCache, h, folder.parent)
|
||||
into.addChild(h)
|
||||
continue
|
||||
}
|
||||
folder.objectHealProbDiv = dataUsageUpdateDirCycles
|
||||
}
|
||||
}
|
||||
scanFolder(folder)
|
||||
}
|
||||
|
||||
// Scan for healing
|
||||
if f.healObjectSelect == 0 || len(abandonedChildren) == 0 {
|
||||
// If we are not heal scanning, return now.
|
||||
break
|
||||
}
|
||||
|
||||
objAPI, ok := newObjectLayerFn().(*erasureServerPools)
|
||||
if !ok || len(f.disks) == 0 {
|
||||
continue
|
||||
break
|
||||
}
|
||||
|
||||
bgSeq, found := globalBackgroundHealState.getHealSequenceByToken(bgHealingUUID)
|
||||
if !found {
|
||||
continue
|
||||
break
|
||||
}
|
||||
|
||||
// Whatever remains in 'existing' are folders at this level
|
||||
// Whatever remains in 'abandonedChildren' are folders at this level
|
||||
// that existed in the previous run but wasn't found now.
|
||||
//
|
||||
// This may be because of 2 reasons:
|
||||
@@ -563,7 +618,7 @@ func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFo
|
||||
}
|
||||
|
||||
healObjectsPrefix := color.Green("healObjects:")
|
||||
for k := range existing {
|
||||
for k := range abandonedChildren {
|
||||
bucket, prefix := path2BucketObject(k)
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(scannerLogPrefix+" checking disappeared folder: %v/%v\n", bucket, prefix)
|
||||
@@ -677,115 +732,75 @@ func (f *folderScanner) scanQueuedLevels(ctx context.Context, folders []cachedFo
|
||||
objAPI.HealObjects(ctx, bucket, prefix, madmin.HealOpts{
|
||||
Recursive: true,
|
||||
Remove: healDeleteDangling,
|
||||
},
|
||||
func(bucket, object, versionID string) error {
|
||||
// Wait for each heal as per scanner frequency.
|
||||
wait()
|
||||
return bgSeq.queueHealTask(healSource{
|
||||
bucket: bucket,
|
||||
object: object,
|
||||
versionID: versionID,
|
||||
}, madmin.HealItemObject)
|
||||
})
|
||||
}, func(bucket, object, versionID string) error {
|
||||
// Wait for each heal as per scanner frequency.
|
||||
wait()
|
||||
wait = scannerSleeper.Timer(ctx)
|
||||
return bgSeq.queueHealTask(healSource{
|
||||
bucket: bucket,
|
||||
object: object,
|
||||
versionID: versionID,
|
||||
}, madmin.HealItemObject)
|
||||
})
|
||||
}
|
||||
|
||||
// Add unless healing returned an error.
|
||||
if foundObjs {
|
||||
this := cachedFolder{name: k, parent: &thisHash, objectHealProbDiv: folder.objectHealProbDiv}
|
||||
cache.addChild(hashPath(k))
|
||||
if final {
|
||||
f.existingFolders = append(f.existingFolders, this)
|
||||
} else {
|
||||
nextFolders = append(nextFolders, this)
|
||||
this := cachedFolder{name: k, parent: &thisHash, objectHealProbDiv: 1}
|
||||
scanFolder(this)
|
||||
}
|
||||
}
|
||||
break
|
||||
}
|
||||
if !wasCompacted {
|
||||
f.newCache.replaceHashed(thisHash, folder.parent, *into)
|
||||
}
|
||||
|
||||
if !into.Compacted && f.newCache.Info.Name != folder.name {
|
||||
flat := f.newCache.sizeRecursive(thisHash.Key())
|
||||
flat.Compacted = true
|
||||
var compact bool
|
||||
if flat.Objects < dataScannerCompactLeastObject {
|
||||
if f.dataUsageScannerDebug && flat.Objects > 1 {
|
||||
// Disabled, rather chatty:
|
||||
//console.Debugf(scannerLogPrefix+" Only %d objects, compacting %s -> %+v\n", flat.Objects, folder.name, flat)
|
||||
}
|
||||
compact = true
|
||||
} else {
|
||||
// Compact if we only have objects as children...
|
||||
compact = true
|
||||
for k := range into.Children {
|
||||
if v, ok := f.newCache.Cache[k]; ok {
|
||||
if len(v.Children) > 0 || v.Objects > 1 {
|
||||
compact = false
|
||||
break
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
f.newCache.replaceHashed(thisHash, folder.parent, cache)
|
||||
}
|
||||
return nextFolders, nil
|
||||
}
|
||||
|
||||
// deepScanFolder will deep scan a folder and return the size if no error occurs.
|
||||
func (f *folderScanner) deepScanFolder(ctx context.Context, folder cachedFolder, skipHeal bool) (*dataUsageEntry, error) {
|
||||
var cache dataUsageEntry
|
||||
|
||||
done := ctx.Done()
|
||||
|
||||
var addDir func(entName string, typ os.FileMode) error
|
||||
var dirStack = []string{f.root, folder.name}
|
||||
|
||||
deepScannerLogPrefix := color.Green("deep-scanner:")
|
||||
addDir = func(entName string, typ os.FileMode) error {
|
||||
select {
|
||||
case <-done:
|
||||
return errDoneForNow
|
||||
default:
|
||||
}
|
||||
|
||||
if typ&os.ModeDir != 0 {
|
||||
dirStack = append(dirStack, entName)
|
||||
err := readDirFn(path.Join(dirStack...), addDir)
|
||||
dirStack = dirStack[:len(dirStack)-1]
|
||||
scannerSleeper.Sleep(ctx, dataScannerSleepPerFolder)
|
||||
return err
|
||||
}
|
||||
|
||||
// Dynamic time delay.
|
||||
wait := scannerSleeper.Timer(ctx)
|
||||
|
||||
// Get file size, ignore errors.
|
||||
dirStack = append(dirStack, entName)
|
||||
fileName := path.Join(dirStack...)
|
||||
dirStack = dirStack[:len(dirStack)-1]
|
||||
|
||||
bucket, prefix := path2BucketObjectWithBasePath(f.root, fileName)
|
||||
var activeLifeCycle *lifecycle.Lifecycle
|
||||
if f.oldCache.Info.lifeCycle != nil && f.oldCache.Info.lifeCycle.HasActiveRules(prefix, false) {
|
||||
if f.dataUsageScannerDebug {
|
||||
console.Debugf(deepScannerLogPrefix+" Prefix %q has active rules\n", prefix)
|
||||
if f.dataUsageScannerDebug && compact {
|
||||
// Disabled, rather chatty:
|
||||
//console.Debugf(scannerLogPrefix+" Only objects (%d), compacting %s -> %+v\n", flat.Objects, folder.name, flat)
|
||||
}
|
||||
activeLifeCycle = f.oldCache.Info.lifeCycle
|
||||
}
|
||||
if compact {
|
||||
f.newCache.deleteRecursive(thisHash)
|
||||
f.newCache.replaceHashed(thisHash, folder.parent, *flat)
|
||||
}
|
||||
|
||||
item := scannerItem{
|
||||
Path: fileName,
|
||||
Typ: typ,
|
||||
bucket: bucket,
|
||||
prefix: path.Dir(prefix),
|
||||
objectName: path.Base(entName),
|
||||
debug: f.dataUsageScannerDebug,
|
||||
lifeCycle: activeLifeCycle,
|
||||
heal: hashPath(path.Join(prefix, entName)).mod(f.oldCache.Info.NextCycle, f.healObjectSelect/folder.objectHealProbDiv) && globalIsErasure,
|
||||
}
|
||||
|
||||
// if the drive belongs to an erasure set
|
||||
// that is already being healed, skip the
|
||||
// healing attempt on this drive.
|
||||
item.heal = item.heal && !skipHeal
|
||||
|
||||
sizeSummary, err := f.getSize(item)
|
||||
if err == errSkipFile {
|
||||
// Wait to throttle IO
|
||||
wait()
|
||||
|
||||
return nil
|
||||
}
|
||||
|
||||
logger.LogIf(ctx, err)
|
||||
cache.addSizes(sizeSummary)
|
||||
cache.Objects++
|
||||
cache.ObjSizes.add(sizeSummary.totalSize)
|
||||
|
||||
// Wait to throttle IO
|
||||
wait()
|
||||
|
||||
return nil
|
||||
}
|
||||
err := readDirFn(path.Join(dirStack...), addDir)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
// Compact if too many children...
|
||||
if !into.Compacted {
|
||||
f.newCache.reduceChildrenOf(thisHash, dataScannerCompactAtChildren, f.newCache.Info.Name != folder.name)
|
||||
}
|
||||
return &cache, nil
|
||||
if _, ok := f.updateCache.Cache[thisHash.Key()]; !wasCompacted && ok {
|
||||
// Replace if existed before.
|
||||
if flat := f.newCache.sizeRecursive(thisHash.Key()); flat != nil {
|
||||
f.updateCache.deleteRecursive(thisHash)
|
||||
f.updateCache.replaceHashed(thisHash, folder.parent, *flat)
|
||||
}
|
||||
}
|
||||
|
||||
return nil
|
||||
}
|
||||
|
||||
// scannerItem represents each file while walking.
|
||||
@@ -803,6 +818,7 @@ type scannerItem struct {
|
||||
|
||||
type sizeSummary struct {
|
||||
totalSize int64
|
||||
versions uint64
|
||||
replicatedSize int64
|
||||
pendingSize int64
|
||||
failedSize int64
|
||||
@@ -863,7 +879,8 @@ func (i *scannerItem) applyLifecycle(ctx context.Context, o ObjectLayer, meta ac
|
||||
}
|
||||
if i.lifeCycle == nil {
|
||||
if i.debug {
|
||||
console.Debugf(applyActionsLogPrefix+" no lifecycle rules to apply: %q\n", i.objectPath())
|
||||
// disabled, very chatty:
|
||||
// console.Debugf(applyActionsLogPrefix+" no lifecycle rules to apply: %q\n", i.objectPath())
|
||||
}
|
||||
return false, size
|
||||
}
|
||||
|
||||
+17
-30
@@ -40,24 +40,20 @@ import (
|
||||
|
||||
const (
|
||||
// Estimate bloom filter size. With this many items
|
||||
dataUpdateTrackerEstItems = 10000000
|
||||
dataUpdateTrackerEstItems = 200000
|
||||
// ... we want this false positive rate:
|
||||
dataUpdateTrackerFP = 0.99
|
||||
dataUpdateTrackerFP = 0.1
|
||||
dataUpdateTrackerQueueSize = 0
|
||||
|
||||
dataUpdateTrackerFilename = dataUsageBucket + SlashSeparator + ".tracker.bin"
|
||||
dataUpdateTrackerVersion = 4
|
||||
dataUpdateTrackerVersion = 5
|
||||
dataUpdateTrackerSaveInterval = 5 * time.Minute
|
||||
)
|
||||
|
||||
var (
|
||||
objectUpdatedCh chan<- string
|
||||
intDataUpdateTracker *dataUpdateTracker
|
||||
)
|
||||
var intDataUpdateTracker *dataUpdateTracker
|
||||
|
||||
func init() {
|
||||
intDataUpdateTracker = newDataUpdateTracker()
|
||||
objectUpdatedCh = intDataUpdateTracker.input
|
||||
}
|
||||
|
||||
type dataUpdateTracker struct {
|
||||
@@ -404,8 +400,10 @@ func (d *dataUpdateTracker) deserialize(src io.Reader, newerThan time.Time) erro
|
||||
return err
|
||||
}
|
||||
switch tmp[0] {
|
||||
case 1, 2, 3:
|
||||
console.Println(color.Green("dataUpdateTracker: ") + "deprecated data version, updating.")
|
||||
case 1, 2, 3, 4:
|
||||
if intDataUpdateTracker.debug {
|
||||
console.Debugln(color.Green("dataUpdateTracker: ") + "deprecated data version, updating.")
|
||||
}
|
||||
return nil
|
||||
case dataUpdateTrackerVersion:
|
||||
default:
|
||||
@@ -498,9 +496,6 @@ func (d *dataUpdateTracker) startCollector(ctx context.Context) {
|
||||
// Add all paths until done.
|
||||
d.mu.Lock()
|
||||
for i := range split {
|
||||
if d.debug {
|
||||
console.Debugln(color.Green("dataUpdateTracker:") + " Marking path dirty: " + color.Blue(path.Join(split[:i+1]...)))
|
||||
}
|
||||
d.Current.bf.AddString(hashPath(path.Join(split[:i+1]...)).String())
|
||||
}
|
||||
d.dirty = d.dirty || len(split) > 0
|
||||
@@ -509,30 +504,22 @@ func (d *dataUpdateTracker) startCollector(ctx context.Context) {
|
||||
}
|
||||
|
||||
// markDirty adds the supplied path to the current bloom filter.
|
||||
func (d *dataUpdateTracker) markDirty(in string) {
|
||||
bucket, _ := path2BucketObjectWithBasePath("", in)
|
||||
func (d *dataUpdateTracker) markDirty(bucket, prefix string) {
|
||||
dateUpdateTrackerLogPrefix := color.Green("dataUpdateTracker:")
|
||||
if bucket == "" {
|
||||
if d.debug && len(in) > 0 {
|
||||
console.Debugf(dateUpdateTrackerLogPrefix+" no bucket (%s)\n", in)
|
||||
}
|
||||
if bucket == "" && d.debug {
|
||||
console.Debugf(dateUpdateTrackerLogPrefix + " no bucket specified\n")
|
||||
return
|
||||
}
|
||||
|
||||
if isReservedOrInvalidBucket(bucket, false) {
|
||||
if d.debug && false {
|
||||
console.Debugf(dateUpdateTrackerLogPrefix+" isReservedOrInvalidBucket: %v, entry: %v\n", bucket, in)
|
||||
}
|
||||
if isReservedOrInvalidBucket(bucket, false) && d.debug {
|
||||
console.Debugf(dateUpdateTrackerLogPrefix+" isReservedOrInvalidBucket: %v, entry: %v\n", bucket, prefix)
|
||||
return
|
||||
}
|
||||
split := splitPathDeterministic(in)
|
||||
split := splitPathDeterministic(pathJoin(bucket, prefix))
|
||||
|
||||
// Add all paths until done.
|
||||
d.mu.Lock()
|
||||
for i := range split {
|
||||
if d.debug {
|
||||
console.Debugln(dateUpdateTrackerLogPrefix + " Marking path dirty: " + color.Blue(path.Join(split[:i+1]...)))
|
||||
}
|
||||
d.Current.bf.AddString(hashPath(path.Join(split[:i+1]...)).String())
|
||||
}
|
||||
d.dirty = d.dirty || len(split) > 0
|
||||
@@ -685,10 +672,10 @@ type bloomFilterResponse struct {
|
||||
Filter []byte
|
||||
}
|
||||
|
||||
// ObjectPathUpdated indicates a path has been updated.
|
||||
// NSUpdated indicates namespace has been updated.
|
||||
// The function will block until the entry has been picked up.
|
||||
func ObjectPathUpdated(s string) {
|
||||
func NSUpdated(bucket, prefix string) {
|
||||
if intDataUpdateTracker != nil {
|
||||
intDataUpdateTracker.markDirty(s)
|
||||
intDataUpdateTracker.markDirty(bucket, prefix)
|
||||
}
|
||||
}
|
||||
|
||||
@@ -224,6 +224,7 @@ func TestDataUpdateTracker(t *testing.T) {
|
||||
t.Fatal("wanted oldest index 3, got", bfr2.OldestIdx)
|
||||
}
|
||||
|
||||
t.Logf("Size of filter %d bytes, M: %d, K:%d", len(bfr2.Filter), dut.Current.bf.Cap(), dut.Current.bf.K())
|
||||
// Rerun test with returned bfr2
|
||||
bf := dut.newBloomFilter()
|
||||
_, err = bf.ReadFrom(bytes.NewReader(bfr2.Filter))
|
||||
|
||||
+337
-63
@@ -25,6 +25,7 @@ import (
|
||||
"net/http"
|
||||
"path"
|
||||
"path/filepath"
|
||||
"sort"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
@@ -51,8 +52,10 @@ type dataUsageEntry struct {
|
||||
// These fields do no include any children.
|
||||
Size int64
|
||||
Objects uint64
|
||||
Versions uint64 // Versions that are not delete markers.
|
||||
ObjSizes sizeHistogram
|
||||
ReplicationStats replicationStats
|
||||
ReplicationStats *replicationStats
|
||||
Compacted bool
|
||||
}
|
||||
|
||||
//msgp:tuple replicationStats
|
||||
@@ -69,6 +72,9 @@ type replicationStats struct {
|
||||
AfterThresholdCount uint64
|
||||
}
|
||||
|
||||
//msgp:encode ignore dataUsageEntryV2 dataUsageEntryV3 dataUsageEntryV4
|
||||
//msgp:marshal ignore dataUsageEntryV2 dataUsageEntryV3 dataUsageEntryV4
|
||||
|
||||
//msgp:tuple dataUsageEntryV2
|
||||
type dataUsageEntryV2 struct {
|
||||
// These fields do no include any children.
|
||||
@@ -91,13 +97,26 @@ type dataUsageEntryV3 struct {
|
||||
Children dataUsageHashMap
|
||||
}
|
||||
|
||||
// dataUsageCache contains a cache of data usage entries latest version 4.
|
||||
//msgp:tuple dataUsageEntryV4
|
||||
type dataUsageEntryV4 struct {
|
||||
Children dataUsageHashMap
|
||||
// These fields do no include any children.
|
||||
Size int64
|
||||
Objects uint64
|
||||
ObjSizes sizeHistogram
|
||||
ReplicationStats replicationStats
|
||||
}
|
||||
|
||||
// dataUsageCache contains a cache of data usage entries latest version.
|
||||
type dataUsageCache struct {
|
||||
Info dataUsageCacheInfo
|
||||
Cache map[string]dataUsageEntry
|
||||
Disks []string
|
||||
}
|
||||
|
||||
//msgp:encode ignore dataUsageCacheV2 dataUsageCacheV3 dataUsageCacheV4
|
||||
//msgp:marshal ignore dataUsageCacheV2 dataUsageCacheV3 dataUsageCacheV4
|
||||
|
||||
// dataUsageCacheV2 contains a cache of data usage entries version 2.
|
||||
type dataUsageCacheV2 struct {
|
||||
Info dataUsageCacheInfo
|
||||
@@ -112,6 +131,13 @@ type dataUsageCacheV3 struct {
|
||||
Cache map[string]dataUsageEntryV3
|
||||
}
|
||||
|
||||
// dataUsageCache contains a cache of data usage entries version 4.
|
||||
type dataUsageCacheV4 struct {
|
||||
Info dataUsageCacheInfo
|
||||
Disks []string
|
||||
Cache map[string]dataUsageEntryV4
|
||||
}
|
||||
|
||||
//msgp:ignore dataUsageEntryInfo
|
||||
type dataUsageEntryInfo struct {
|
||||
Name string
|
||||
@@ -127,31 +153,55 @@ type dataUsageCacheInfo struct {
|
||||
// indicates if the disk is being healed and scanner
|
||||
// should skip healing the disk
|
||||
SkipHealing bool
|
||||
BloomFilter []byte `msg:"BloomFilter,omitempty"`
|
||||
lifeCycle *lifecycle.Lifecycle `msg:"-"`
|
||||
BloomFilter []byte `msg:"BloomFilter,omitempty"`
|
||||
|
||||
// Active lifecycle, if any on the bucket
|
||||
lifeCycle *lifecycle.Lifecycle `msg:"-"`
|
||||
|
||||
// optional updates channel.
|
||||
// If set updates will be sent regularly to this channel.
|
||||
// Will not be closed when returned.
|
||||
updates chan<- dataUsageEntry `msg:"-"`
|
||||
}
|
||||
|
||||
func (e *dataUsageEntry) addSizes(summary sizeSummary) {
|
||||
e.Size += summary.totalSize
|
||||
e.ReplicationStats.ReplicatedSize += uint64(summary.replicatedSize)
|
||||
e.ReplicationStats.FailedSize += uint64(summary.failedSize)
|
||||
e.ReplicationStats.PendingSize += uint64(summary.pendingSize)
|
||||
e.ReplicationStats.ReplicaSize += uint64(summary.replicaSize)
|
||||
e.ReplicationStats.PendingCount += uint64(summary.pendingCount)
|
||||
e.ReplicationStats.FailedCount += uint64(summary.failedCount)
|
||||
e.Versions += summary.versions
|
||||
e.ObjSizes.add(summary.totalSize)
|
||||
|
||||
if summary.replicaSize > 0 || summary.pendingSize > 0 || summary.replicatedSize > 0 ||
|
||||
summary.failedCount > 0 || summary.pendingCount > 0 || summary.failedSize > 0 {
|
||||
if e.ReplicationStats == nil {
|
||||
e.ReplicationStats = &replicationStats{}
|
||||
}
|
||||
e.ReplicationStats.ReplicatedSize += uint64(summary.replicatedSize)
|
||||
e.ReplicationStats.FailedSize += uint64(summary.failedSize)
|
||||
e.ReplicationStats.PendingSize += uint64(summary.pendingSize)
|
||||
e.ReplicationStats.ReplicaSize += uint64(summary.replicaSize)
|
||||
e.ReplicationStats.PendingCount += summary.pendingCount
|
||||
e.ReplicationStats.FailedCount += summary.failedCount
|
||||
}
|
||||
}
|
||||
|
||||
// merge other data usage entry into this, excluding children.
|
||||
func (e *dataUsageEntry) merge(other dataUsageEntry) {
|
||||
e.Objects += other.Objects
|
||||
e.Versions += other.Versions
|
||||
e.Size += other.Size
|
||||
e.ReplicationStats.PendingSize += other.ReplicationStats.PendingSize
|
||||
e.ReplicationStats.FailedSize += other.ReplicationStats.FailedSize
|
||||
e.ReplicationStats.ReplicatedSize += other.ReplicationStats.ReplicatedSize
|
||||
e.ReplicationStats.ReplicaSize += other.ReplicationStats.ReplicaSize
|
||||
e.ReplicationStats.PendingCount += other.ReplicationStats.PendingCount
|
||||
e.ReplicationStats.FailedCount += other.ReplicationStats.FailedCount
|
||||
ors := other.ReplicationStats
|
||||
empty := replicationStats{}
|
||||
if ors != nil && *ors != empty {
|
||||
if e.ReplicationStats == nil {
|
||||
e.ReplicationStats = &replicationStats{}
|
||||
}
|
||||
e.ReplicationStats.PendingSize += other.ReplicationStats.PendingSize
|
||||
e.ReplicationStats.FailedSize += other.ReplicationStats.FailedSize
|
||||
e.ReplicationStats.ReplicatedSize += other.ReplicationStats.ReplicatedSize
|
||||
e.ReplicationStats.ReplicaSize += other.ReplicationStats.ReplicaSize
|
||||
e.ReplicationStats.PendingCount += other.ReplicationStats.PendingCount
|
||||
e.ReplicationStats.FailedCount += other.ReplicationStats.FailedCount
|
||||
|
||||
}
|
||||
|
||||
for i, v := range other.ObjSizes[:] {
|
||||
e.ObjSizes[i] += v
|
||||
@@ -196,6 +246,16 @@ func (d *dataUsageCache) find(path string) *dataUsageEntry {
|
||||
return &due
|
||||
}
|
||||
|
||||
// isCompacted returns whether an entry is compacted.
|
||||
// Returns false if not found.
|
||||
func (d *dataUsageCache) isCompacted(h dataUsageHash) bool {
|
||||
due, ok := d.Cache[h.Key()]
|
||||
if !ok {
|
||||
return false
|
||||
}
|
||||
return due.Compacted
|
||||
}
|
||||
|
||||
// findChildrenCopy returns a copy of the children of the supplied hash.
|
||||
func (d *dataUsageCache) findChildrenCopy(h dataUsageHash) dataUsageHashMap {
|
||||
ch := d.Cache[h.String()].Children
|
||||
@@ -206,6 +266,31 @@ func (d *dataUsageCache) findChildrenCopy(h dataUsageHash) dataUsageHashMap {
|
||||
return res
|
||||
}
|
||||
|
||||
// searchParent will search for the parent of h.
|
||||
// This is an O(N*N) operation if there is no parent or it cannot be guessed.
|
||||
func (d *dataUsageCache) searchParent(h dataUsageHash) *dataUsageHash {
|
||||
want := h.Key()
|
||||
if idx := strings.LastIndexByte(want, '/'); idx >= 0 {
|
||||
if v := d.find(want[:idx]); v != nil {
|
||||
for child := range v.Children {
|
||||
if child == want {
|
||||
found := hashPath(want[:idx])
|
||||
return &found
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
for k, v := range d.Cache {
|
||||
for child := range v.Children {
|
||||
if child == want {
|
||||
found := dataUsageHash(k)
|
||||
return &found
|
||||
}
|
||||
}
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
// Returns nil if not found.
|
||||
func (d *dataUsageCache) subCache(path string) dataUsageCache {
|
||||
dst := dataUsageCache{Info: dataUsageCacheInfo{
|
||||
@@ -217,6 +302,7 @@ func (d *dataUsageCache) subCache(path string) dataUsageCache {
|
||||
return dst
|
||||
}
|
||||
|
||||
// deleteRecursive will delete an entry recursively, but not change its parent.
|
||||
func (d *dataUsageCache) deleteRecursive(h dataUsageHash) {
|
||||
if existing, ok := d.Cache[h.String()]; ok {
|
||||
// Delete first if there should be a loop.
|
||||
@@ -227,6 +313,15 @@ func (d *dataUsageCache) deleteRecursive(h dataUsageHash) {
|
||||
}
|
||||
}
|
||||
|
||||
// deleteChildren will delete any children, but not the entry itself.
|
||||
func (d *dataUsageCache) deleteChildren(h dataUsageHash) {
|
||||
if existing, ok := d.Cache[h.String()]; ok {
|
||||
for child := range existing.Children {
|
||||
d.deleteRecursive(dataUsageHash(child))
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// replaceRootChild will replace the child of root in d with the root of 'other'.
|
||||
func (d *dataUsageCache) replaceRootChild(other dataUsageCache) {
|
||||
otherRoot := other.root()
|
||||
@@ -285,19 +380,22 @@ func (d *dataUsageCache) dui(path string, buckets []BucketInfo) madmin.DataUsage
|
||||
return madmin.DataUsageInfo{}
|
||||
}
|
||||
flat := d.flatten(*e)
|
||||
return madmin.DataUsageInfo{
|
||||
LastUpdate: d.Info.LastUpdate,
|
||||
ObjectsTotalCount: flat.Objects,
|
||||
ObjectsTotalSize: uint64(flat.Size),
|
||||
ReplicatedSize: flat.ReplicationStats.ReplicatedSize,
|
||||
ReplicationFailedSize: flat.ReplicationStats.FailedSize,
|
||||
ReplicationPendingSize: flat.ReplicationStats.PendingSize,
|
||||
ReplicaSize: flat.ReplicationStats.ReplicaSize,
|
||||
ReplicationPendingCount: flat.ReplicationStats.PendingCount,
|
||||
ReplicationFailedCount: flat.ReplicationStats.FailedCount,
|
||||
BucketsCount: uint64(len(e.Children)),
|
||||
BucketsUsage: d.bucketsUsageInfo(buckets),
|
||||
dui := madmin.DataUsageInfo{
|
||||
LastUpdate: d.Info.LastUpdate,
|
||||
ObjectsTotalCount: flat.Objects,
|
||||
ObjectsTotalSize: uint64(flat.Size),
|
||||
BucketsCount: uint64(len(e.Children)),
|
||||
BucketsUsage: d.bucketsUsageInfo(buckets),
|
||||
}
|
||||
if flat.ReplicationStats != nil {
|
||||
dui.ReplicationPendingSize = flat.ReplicationStats.PendingSize
|
||||
dui.ReplicatedSize = flat.ReplicationStats.ReplicatedSize
|
||||
dui.ReplicationFailedSize = flat.ReplicationStats.FailedSize
|
||||
dui.ReplicationPendingCount = flat.ReplicationStats.PendingCount
|
||||
dui.ReplicationFailedCount = flat.ReplicationStats.FailedCount
|
||||
dui.ReplicaSize = flat.ReplicationStats.ReplicaSize
|
||||
}
|
||||
return dui
|
||||
}
|
||||
|
||||
// replace will add or replace an entry in the cache.
|
||||
@@ -317,6 +415,16 @@ func (d *dataUsageCache) replace(path, parent string, e dataUsageEntry) {
|
||||
}
|
||||
}
|
||||
|
||||
// listCache will return all cache paths.
|
||||
func (d *dataUsageCache) listCache() []string {
|
||||
dst := make([]string, 0, len(d.Cache))
|
||||
for k := range d.Cache {
|
||||
dst = append(dst, k)
|
||||
}
|
||||
sort.Strings(dst)
|
||||
return dst
|
||||
}
|
||||
|
||||
// replaceHashed add or replaces an entry to the cache based on its hash.
|
||||
// If a parent is specified it will be added to that if not already there.
|
||||
// If the parent does not exist, it will be added.
|
||||
@@ -358,6 +466,91 @@ func (d *dataUsageCache) copyWithChildren(src *dataUsageCache, hash dataUsageHas
|
||||
}
|
||||
}
|
||||
|
||||
// reduceChildrenOf will reduce the recursive number of children to the limit
|
||||
// by compacting the children with the least number of objects.
|
||||
func (d *dataUsageCache) reduceChildrenOf(path dataUsageHash, limit int, compactSelf bool) {
|
||||
e, ok := d.Cache[path.Key()]
|
||||
if !ok {
|
||||
return
|
||||
}
|
||||
if e.Compacted {
|
||||
return
|
||||
}
|
||||
// If direct children have more, compact all.
|
||||
if len(e.Children) > limit && compactSelf {
|
||||
flat := d.sizeRecursive(path.Key())
|
||||
flat.Compacted = true
|
||||
d.deleteRecursive(path)
|
||||
d.replaceHashed(path, nil, *flat)
|
||||
return
|
||||
}
|
||||
total := d.totalChildrenRec(path.Key())
|
||||
if total < limit {
|
||||
return
|
||||
}
|
||||
|
||||
// Appears to be printed with _MINIO_SERVER_DEBUG=off
|
||||
// console.Debugf(" %d children found, compacting %v\n", total, path)
|
||||
|
||||
var leaves = make([]struct {
|
||||
objects uint64
|
||||
path dataUsageHash
|
||||
}, total)
|
||||
// Collect current leaves that have children.
|
||||
leaves = leaves[:0]
|
||||
remove := total - limit
|
||||
var add func(path dataUsageHash)
|
||||
add = func(path dataUsageHash) {
|
||||
e, ok := d.Cache[path.Key()]
|
||||
if !ok {
|
||||
return
|
||||
}
|
||||
if len(e.Children) == 0 {
|
||||
return
|
||||
}
|
||||
sz := d.sizeRecursive(path.Key())
|
||||
leaves = append(leaves, struct {
|
||||
objects uint64
|
||||
path dataUsageHash
|
||||
}{objects: sz.Objects, path: path})
|
||||
for ch := range e.Children {
|
||||
add(dataUsageHash(ch))
|
||||
}
|
||||
}
|
||||
|
||||
// Add path recursively.
|
||||
add(path)
|
||||
sort.Slice(leaves, func(i, j int) bool {
|
||||
return leaves[i].objects < leaves[j].objects
|
||||
})
|
||||
for remove > 0 && len(leaves) > 0 {
|
||||
// Remove top entry.
|
||||
e := leaves[0]
|
||||
candidate := e.path
|
||||
if candidate == path && !compactSelf {
|
||||
// We should be the biggest,
|
||||
// if we cannot compact ourself, we are done.
|
||||
break
|
||||
}
|
||||
removing := d.totalChildrenRec(candidate.Key())
|
||||
flat := d.sizeRecursive(candidate.Key())
|
||||
if flat == nil {
|
||||
leaves = leaves[1:]
|
||||
continue
|
||||
}
|
||||
// Appears to be printed with _MINIO_SERVER_DEBUG=off
|
||||
// console.Debugf("compacting %v, removing %d children\n", candidate, removing)
|
||||
|
||||
flat.Compacted = true
|
||||
d.deleteRecursive(candidate)
|
||||
d.replaceHashed(candidate, nil, *flat)
|
||||
|
||||
// Remove top entry and subtract removed children.
|
||||
remove -= removing
|
||||
leaves = leaves[1:]
|
||||
}
|
||||
}
|
||||
|
||||
// StringAll returns a detailed string representation of all entries in the cache.
|
||||
func (d *dataUsageCache) StringAll() string {
|
||||
s := fmt.Sprintf("info:%+v\n", d.Info)
|
||||
@@ -372,7 +565,7 @@ func (h dataUsageHash) String() string {
|
||||
return string(h)
|
||||
}
|
||||
|
||||
// String returns a human readable representation of the string.
|
||||
// Key returns the key.
|
||||
func (h dataUsageHash) Key() string {
|
||||
return string(h)
|
||||
}
|
||||
@@ -421,17 +614,20 @@ func (d *dataUsageCache) bucketsUsageInfo(buckets []BucketInfo) map[string]madmi
|
||||
continue
|
||||
}
|
||||
flat := d.flatten(*e)
|
||||
dst[bucket.Name] = madmin.BucketUsageInfo{
|
||||
Size: uint64(flat.Size),
|
||||
ObjectsCount: flat.Objects,
|
||||
ReplicationPendingSize: flat.ReplicationStats.PendingSize,
|
||||
ReplicatedSize: flat.ReplicationStats.ReplicatedSize,
|
||||
ReplicationFailedSize: flat.ReplicationStats.FailedSize,
|
||||
ReplicationPendingCount: flat.ReplicationStats.PendingCount,
|
||||
ReplicationFailedCount: flat.ReplicationStats.FailedCount,
|
||||
ReplicaSize: flat.ReplicationStats.ReplicaSize,
|
||||
ObjectSizesHistogram: flat.ObjSizes.toMap(),
|
||||
bui := madmin.BucketUsageInfo{
|
||||
Size: uint64(flat.Size),
|
||||
ObjectsCount: flat.Objects,
|
||||
ObjectSizesHistogram: flat.ObjSizes.toMap(),
|
||||
}
|
||||
if flat.ReplicationStats != nil {
|
||||
bui.ReplicationPendingSize = flat.ReplicationStats.PendingSize
|
||||
bui.ReplicatedSize = flat.ReplicationStats.ReplicatedSize
|
||||
bui.ReplicationFailedSize = flat.ReplicationStats.FailedSize
|
||||
bui.ReplicationPendingCount = flat.ReplicationStats.PendingCount
|
||||
bui.ReplicationFailedCount = flat.ReplicationStats.FailedCount
|
||||
bui.ReplicaSize = flat.ReplicationStats.ReplicaSize
|
||||
}
|
||||
dst[bucket.Name] = bui
|
||||
}
|
||||
return dst
|
||||
}
|
||||
@@ -444,17 +640,20 @@ func (d *dataUsageCache) bucketUsageInfo(bucket string) madmin.BucketUsageInfo {
|
||||
return madmin.BucketUsageInfo{}
|
||||
}
|
||||
flat := d.flatten(*e)
|
||||
return madmin.BucketUsageInfo{
|
||||
Size: uint64(flat.Size),
|
||||
ObjectsCount: flat.Objects,
|
||||
ReplicationPendingSize: flat.ReplicationStats.PendingSize,
|
||||
ReplicationPendingCount: flat.ReplicationStats.PendingCount,
|
||||
ReplicatedSize: flat.ReplicationStats.ReplicatedSize,
|
||||
ReplicationFailedSize: flat.ReplicationStats.FailedSize,
|
||||
ReplicationFailedCount: flat.ReplicationStats.FailedCount,
|
||||
ReplicaSize: flat.ReplicationStats.ReplicaSize,
|
||||
ObjectSizesHistogram: flat.ObjSizes.toMap(),
|
||||
bui := madmin.BucketUsageInfo{
|
||||
Size: uint64(flat.Size),
|
||||
ObjectsCount: flat.Objects,
|
||||
ObjectSizesHistogram: flat.ObjSizes.toMap(),
|
||||
}
|
||||
if flat.ReplicationStats != nil {
|
||||
bui.ReplicationPendingSize = flat.ReplicationStats.PendingSize
|
||||
bui.ReplicatedSize = flat.ReplicationStats.ReplicatedSize
|
||||
bui.ReplicationFailedSize = flat.ReplicationStats.FailedSize
|
||||
bui.ReplicationPendingCount = flat.ReplicationStats.PendingCount
|
||||
bui.ReplicationFailedCount = flat.ReplicationStats.FailedCount
|
||||
bui.ReplicaSize = flat.ReplicationStats.ReplicaSize
|
||||
}
|
||||
return bui
|
||||
}
|
||||
|
||||
// sizeRecursive returns the path as a flattened entry.
|
||||
@@ -467,6 +666,19 @@ func (d *dataUsageCache) sizeRecursive(path string) *dataUsageEntry {
|
||||
return &flat
|
||||
}
|
||||
|
||||
// totalChildrenRec returns the total number of children recorded.
|
||||
func (d *dataUsageCache) totalChildrenRec(path string) int {
|
||||
root := d.find(path)
|
||||
if root == nil || len(root.Children) == 0 {
|
||||
return 0
|
||||
}
|
||||
n := len(root.Children)
|
||||
for ch := range root.Children {
|
||||
n += d.totalChildrenRec(ch)
|
||||
}
|
||||
return n
|
||||
}
|
||||
|
||||
// root returns the root of the cache.
|
||||
func (d *dataUsageCache) root() *dataUsageEntry {
|
||||
return d.find(d.Info.Name)
|
||||
@@ -529,6 +741,9 @@ type objectIO interface {
|
||||
// Only backend errors are returned as errors.
|
||||
// If the object is not found or unable to deserialize d is cleared and nil error is returned.
|
||||
func (d *dataUsageCache) load(ctx context.Context, store objectIO, name string) error {
|
||||
// Abandon if more than 5 minutes, so we don't hold up scanner.
|
||||
ctx, cancel := context.WithTimeout(ctx, 5*time.Minute)
|
||||
defer cancel()
|
||||
r, err := store.GetObjectNInfo(ctx, dataUsageBucket, name, nil, http.Header{}, readLock, ObjectOptions{})
|
||||
if err != nil {
|
||||
switch err.(type) {
|
||||
@@ -562,6 +777,9 @@ func (d *dataUsageCache) save(ctx context.Context, store objectIO, name string)
|
||||
return err
|
||||
}
|
||||
|
||||
// Abandon if more than 5 minutes, so we don't hold up scanner.
|
||||
ctx, cancel := context.WithTimeout(ctx, 5*time.Minute)
|
||||
defer cancel()
|
||||
_, err = store.PutObject(ctx,
|
||||
dataUsageBucket,
|
||||
name,
|
||||
@@ -577,16 +795,17 @@ func (d *dataUsageCache) save(ctx context.Context, store objectIO, name string)
|
||||
// Bumping the cache version will drop data from previous versions
|
||||
// and write new data with the new version.
|
||||
const (
|
||||
dataUsageCacheVerV4 = 4
|
||||
dataUsageCacheVerV3 = 3
|
||||
dataUsageCacheVerV2 = 2
|
||||
dataUsageCacheVerV1 = 1
|
||||
dataUsageCacheVerCurrent = 5
|
||||
dataUsageCacheVerV4 = 4
|
||||
dataUsageCacheVerV3 = 3
|
||||
dataUsageCacheVerV2 = 2
|
||||
dataUsageCacheVerV1 = 1
|
||||
)
|
||||
|
||||
// serialize the contents of the cache.
|
||||
func (d *dataUsageCache) serializeTo(dst io.Writer) error {
|
||||
// Add version and compress.
|
||||
_, err := dst.Write([]byte{dataUsageCacheVerV4})
|
||||
_, err := dst.Write([]byte{dataUsageCacheVerCurrent})
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
@@ -620,7 +839,8 @@ func (d *dataUsageCache) deserialize(r io.Reader) error {
|
||||
if n != 1 {
|
||||
return io.ErrUnexpectedEOF
|
||||
}
|
||||
switch b[0] {
|
||||
ver := int(b[0])
|
||||
switch ver {
|
||||
case dataUsageCacheVerV1:
|
||||
return errors.New("cache version deprecated (will autoupdate)")
|
||||
case dataUsageCacheVerV2:
|
||||
@@ -640,10 +860,11 @@ func (d *dataUsageCache) deserialize(r io.Reader) error {
|
||||
d.Cache = make(map[string]dataUsageEntry, len(dold.Cache))
|
||||
for k, v := range dold.Cache {
|
||||
d.Cache[k] = dataUsageEntry{
|
||||
Size: v.Size,
|
||||
Objects: v.Objects,
|
||||
ObjSizes: v.ObjSizes,
|
||||
Children: v.Children,
|
||||
Size: v.Size,
|
||||
Objects: v.Objects,
|
||||
ObjSizes: v.ObjSizes,
|
||||
Children: v.Children,
|
||||
Compacted: len(v.Children) == 0 && k != d.Info.Name,
|
||||
}
|
||||
}
|
||||
return nil
|
||||
@@ -662,18 +883,23 @@ func (d *dataUsageCache) deserialize(r io.Reader) error {
|
||||
d.Disks = dold.Disks
|
||||
d.Cache = make(map[string]dataUsageEntry, len(dold.Cache))
|
||||
for k, v := range dold.Cache {
|
||||
d.Cache[k] = dataUsageEntry{
|
||||
due := dataUsageEntry{
|
||||
Size: v.Size,
|
||||
Objects: v.Objects,
|
||||
ObjSizes: v.ObjSizes,
|
||||
Children: v.Children,
|
||||
ReplicationStats: replicationStats{
|
||||
}
|
||||
if v.ReplicatedSize > 0 || v.ReplicaSize > 0 || v.ReplicationFailedSize > 0 || v.ReplicationPendingSize > 0 {
|
||||
due.ReplicationStats = &replicationStats{
|
||||
ReplicatedSize: v.ReplicatedSize,
|
||||
ReplicaSize: v.ReplicaSize,
|
||||
FailedSize: v.ReplicationFailedSize,
|
||||
PendingSize: v.ReplicationPendingSize,
|
||||
},
|
||||
}
|
||||
}
|
||||
due.Compacted = len(due.Children) == 0 && k != d.Info.Name
|
||||
|
||||
d.Cache[k] = due
|
||||
}
|
||||
return nil
|
||||
case dataUsageCacheVerV4:
|
||||
@@ -683,10 +909,50 @@ func (d *dataUsageCache) deserialize(r io.Reader) error {
|
||||
return err
|
||||
}
|
||||
defer dec.Close()
|
||||
dold := &dataUsageCacheV4{}
|
||||
if err = dold.DecodeMsg(msgp.NewReader(dec)); err != nil {
|
||||
return err
|
||||
}
|
||||
d.Info = dold.Info
|
||||
d.Disks = dold.Disks
|
||||
d.Cache = make(map[string]dataUsageEntry, len(dold.Cache))
|
||||
for k, v := range dold.Cache {
|
||||
due := dataUsageEntry{
|
||||
Size: v.Size,
|
||||
Objects: v.Objects,
|
||||
ObjSizes: v.ObjSizes,
|
||||
Children: v.Children,
|
||||
}
|
||||
empty := replicationStats{}
|
||||
if v.ReplicationStats != empty {
|
||||
due.ReplicationStats = &v.ReplicationStats
|
||||
}
|
||||
due.Compacted = len(due.Children) == 0 && k != d.Info.Name
|
||||
|
||||
d.Cache[k] = due
|
||||
}
|
||||
|
||||
// Populate compacted value and remove unneeded replica stats.
|
||||
empty := replicationStats{}
|
||||
for k, e := range d.Cache {
|
||||
if e.ReplicationStats != nil && *e.ReplicationStats == empty {
|
||||
e.ReplicationStats = nil
|
||||
}
|
||||
|
||||
d.Cache[k] = e
|
||||
}
|
||||
return nil
|
||||
case dataUsageCacheVerCurrent:
|
||||
// Zstd compressed.
|
||||
dec, err := zstd.NewReader(r, zstd.WithDecoderConcurrency(2))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
defer dec.Close()
|
||||
return d.DecodeMsg(msgp.NewReader(dec))
|
||||
default:
|
||||
return fmt.Errorf("dataUsageCache: unknown version: %d", ver)
|
||||
}
|
||||
return fmt.Errorf("dataUsageCache: unknown version: %d", int(b[0]))
|
||||
}
|
||||
|
||||
// Trim this from start+end of hashes.
|
||||
@@ -717,6 +983,10 @@ func (z *dataUsageHashMap) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0002 == 0 {
|
||||
*z = nil
|
||||
return
|
||||
}
|
||||
*z = make(dataUsageHashMap, zb0002)
|
||||
for i := uint32(0); i < zb0002; i++ {
|
||||
{
|
||||
@@ -767,6 +1037,10 @@ func (z *dataUsageHashMap) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0002 == 0 {
|
||||
*z = nil
|
||||
return bts, nil
|
||||
}
|
||||
*z = make(dataUsageHashMap, zb0002)
|
||||
for i := uint32(0); i < zb0002; i++ {
|
||||
{
|
||||
|
||||
+387
-327
@@ -593,92 +593,6 @@ func (z *dataUsageCacheV2) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
return
|
||||
}
|
||||
|
||||
// EncodeMsg implements msgp.Encodable
|
||||
func (z *dataUsageCacheV2) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// map header, size 3
|
||||
// write "Info"
|
||||
err = en.Append(0x83, 0xa4, 0x49, 0x6e, 0x66, 0x6f)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = z.Info.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
// write "Disks"
|
||||
err = en.Append(0xa5, 0x44, 0x69, 0x73, 0x6b, 0x73)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteArrayHeader(uint32(len(z.Disks)))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks")
|
||||
return
|
||||
}
|
||||
for za0001 := range z.Disks {
|
||||
err = en.WriteString(z.Disks[za0001])
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
// write "Cache"
|
||||
err = en.Append(0xa5, 0x43, 0x61, 0x63, 0x68, 0x65)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteMapHeader(uint32(len(z.Cache)))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
for za0002, za0003 := range z.Cache {
|
||||
err = en.WriteString(za0002)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
err = za0003.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// MarshalMsg implements msgp.Marshaler
|
||||
func (z *dataUsageCacheV2) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
o = msgp.Require(b, z.Msgsize())
|
||||
// map header, size 3
|
||||
// string "Info"
|
||||
o = append(o, 0x83, 0xa4, 0x49, 0x6e, 0x66, 0x6f)
|
||||
o, err = z.Info.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
// string "Disks"
|
||||
o = append(o, 0xa5, 0x44, 0x69, 0x73, 0x6b, 0x73)
|
||||
o = msgp.AppendArrayHeader(o, uint32(len(z.Disks)))
|
||||
for za0001 := range z.Disks {
|
||||
o = msgp.AppendString(o, z.Disks[za0001])
|
||||
}
|
||||
// string "Cache"
|
||||
o = append(o, 0xa5, 0x43, 0x61, 0x63, 0x68, 0x65)
|
||||
o = msgp.AppendMapHeader(o, uint32(len(z.Cache)))
|
||||
for za0002, za0003 := range z.Cache {
|
||||
o = msgp.AppendString(o, za0002)
|
||||
o, err = za0003.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageCacheV2) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var field []byte
|
||||
@@ -864,92 +778,6 @@ func (z *dataUsageCacheV3) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
return
|
||||
}
|
||||
|
||||
// EncodeMsg implements msgp.Encodable
|
||||
func (z *dataUsageCacheV3) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// map header, size 3
|
||||
// write "Info"
|
||||
err = en.Append(0x83, 0xa4, 0x49, 0x6e, 0x66, 0x6f)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = z.Info.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
// write "Disks"
|
||||
err = en.Append(0xa5, 0x44, 0x69, 0x73, 0x6b, 0x73)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteArrayHeader(uint32(len(z.Disks)))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks")
|
||||
return
|
||||
}
|
||||
for za0001 := range z.Disks {
|
||||
err = en.WriteString(z.Disks[za0001])
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
// write "Cache"
|
||||
err = en.Append(0xa5, 0x43, 0x61, 0x63, 0x68, 0x65)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteMapHeader(uint32(len(z.Cache)))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
for za0002, za0003 := range z.Cache {
|
||||
err = en.WriteString(za0002)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
err = za0003.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// MarshalMsg implements msgp.Marshaler
|
||||
func (z *dataUsageCacheV3) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
o = msgp.Require(b, z.Msgsize())
|
||||
// map header, size 3
|
||||
// string "Info"
|
||||
o = append(o, 0x83, 0xa4, 0x49, 0x6e, 0x66, 0x6f)
|
||||
o, err = z.Info.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
// string "Disks"
|
||||
o = append(o, 0xa5, 0x44, 0x69, 0x73, 0x6b, 0x73)
|
||||
o = msgp.AppendArrayHeader(o, uint32(len(z.Disks)))
|
||||
for za0001 := range z.Disks {
|
||||
o = msgp.AppendString(o, z.Disks[za0001])
|
||||
}
|
||||
// string "Cache"
|
||||
o = append(o, 0xa5, 0x43, 0x61, 0x63, 0x68, 0x65)
|
||||
o = msgp.AppendMapHeader(o, uint32(len(z.Cache)))
|
||||
for za0002, za0003 := range z.Cache {
|
||||
o = msgp.AppendString(o, za0002)
|
||||
o, err = za0003.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageCacheV3) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var field []byte
|
||||
@@ -1051,6 +879,191 @@ func (z *dataUsageCacheV3) Msgsize() (s int) {
|
||||
return
|
||||
}
|
||||
|
||||
// DecodeMsg implements msgp.Decodable
|
||||
func (z *dataUsageCacheV4) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
var field []byte
|
||||
_ = field
|
||||
var zb0001 uint32
|
||||
zb0001, err = dc.ReadMapHeader()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
for zb0001 > 0 {
|
||||
zb0001--
|
||||
field, err = dc.ReadMapKeyPtr()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
switch msgp.UnsafeString(field) {
|
||||
case "Info":
|
||||
err = z.Info.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
case "Disks":
|
||||
var zb0002 uint32
|
||||
zb0002, err = dc.ReadArrayHeader()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks")
|
||||
return
|
||||
}
|
||||
if cap(z.Disks) >= int(zb0002) {
|
||||
z.Disks = (z.Disks)[:zb0002]
|
||||
} else {
|
||||
z.Disks = make([]string, zb0002)
|
||||
}
|
||||
for za0001 := range z.Disks {
|
||||
z.Disks[za0001], err = dc.ReadString()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
case "Cache":
|
||||
var zb0003 uint32
|
||||
zb0003, err = dc.ReadMapHeader()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
if z.Cache == nil {
|
||||
z.Cache = make(map[string]dataUsageEntryV4, zb0003)
|
||||
} else if len(z.Cache) > 0 {
|
||||
for key := range z.Cache {
|
||||
delete(z.Cache, key)
|
||||
}
|
||||
}
|
||||
for zb0003 > 0 {
|
||||
zb0003--
|
||||
var za0002 string
|
||||
var za0003 dataUsageEntryV4
|
||||
za0002, err = dc.ReadString()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
err = za0003.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
z.Cache[za0002] = za0003
|
||||
}
|
||||
default:
|
||||
err = dc.Skip()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageCacheV4) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var field []byte
|
||||
_ = field
|
||||
var zb0001 uint32
|
||||
zb0001, bts, err = msgp.ReadMapHeaderBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
for zb0001 > 0 {
|
||||
zb0001--
|
||||
field, bts, err = msgp.ReadMapKeyZC(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
switch msgp.UnsafeString(field) {
|
||||
case "Info":
|
||||
bts, err = z.Info.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Info")
|
||||
return
|
||||
}
|
||||
case "Disks":
|
||||
var zb0002 uint32
|
||||
zb0002, bts, err = msgp.ReadArrayHeaderBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks")
|
||||
return
|
||||
}
|
||||
if cap(z.Disks) >= int(zb0002) {
|
||||
z.Disks = (z.Disks)[:zb0002]
|
||||
} else {
|
||||
z.Disks = make([]string, zb0002)
|
||||
}
|
||||
for za0001 := range z.Disks {
|
||||
z.Disks[za0001], bts, err = msgp.ReadStringBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Disks", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
case "Cache":
|
||||
var zb0003 uint32
|
||||
zb0003, bts, err = msgp.ReadMapHeaderBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
if z.Cache == nil {
|
||||
z.Cache = make(map[string]dataUsageEntryV4, zb0003)
|
||||
} else if len(z.Cache) > 0 {
|
||||
for key := range z.Cache {
|
||||
delete(z.Cache, key)
|
||||
}
|
||||
}
|
||||
for zb0003 > 0 {
|
||||
var za0002 string
|
||||
var za0003 dataUsageEntryV4
|
||||
zb0003--
|
||||
za0002, bts, err = msgp.ReadStringBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache")
|
||||
return
|
||||
}
|
||||
bts, err = za0003.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Cache", za0002)
|
||||
return
|
||||
}
|
||||
z.Cache[za0002] = za0003
|
||||
}
|
||||
default:
|
||||
bts, err = msgp.Skip(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
}
|
||||
}
|
||||
o = bts
|
||||
return
|
||||
}
|
||||
|
||||
// Msgsize returns an upper bound estimate of the number of bytes occupied by the serialized message
|
||||
func (z *dataUsageCacheV4) Msgsize() (s int) {
|
||||
s = 1 + 5 + z.Info.Msgsize() + 6 + msgp.ArrayHeaderSize
|
||||
for za0001 := range z.Disks {
|
||||
s += msgp.StringPrefixSize + len(z.Disks[za0001])
|
||||
}
|
||||
s += 6 + msgp.MapHeaderSize
|
||||
if z.Cache != nil {
|
||||
for za0002, za0003 := range z.Cache {
|
||||
_ = za0003
|
||||
s += msgp.StringPrefixSize + len(za0002) + za0003.Msgsize()
|
||||
}
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// DecodeMsg implements msgp.Decodable
|
||||
func (z *dataUsageEntry) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
var zb0001 uint32
|
||||
@@ -1059,8 +1072,8 @@ func (z *dataUsageEntry) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0001 != 5 {
|
||||
err = msgp.ArrayError{Wanted: 5, Got: zb0001}
|
||||
if zb0001 != 7 {
|
||||
err = msgp.ArrayError{Wanted: 7, Got: zb0001}
|
||||
return
|
||||
}
|
||||
err = z.Children.DecodeMsg(dc)
|
||||
@@ -1078,6 +1091,11 @@ func (z *dataUsageEntry) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
z.Versions, err = dc.ReadUint64()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Versions")
|
||||
return
|
||||
}
|
||||
var zb0002 uint32
|
||||
zb0002, err = dc.ReadArrayHeader()
|
||||
if err != nil {
|
||||
@@ -1095,9 +1113,26 @@ func (z *dataUsageEntry) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
return
|
||||
}
|
||||
}
|
||||
err = z.ReplicationStats.DecodeMsg(dc)
|
||||
if dc.IsNil() {
|
||||
err = dc.ReadNil()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
z.ReplicationStats = nil
|
||||
} else {
|
||||
if z.ReplicationStats == nil {
|
||||
z.ReplicationStats = new(replicationStats)
|
||||
}
|
||||
err = z.ReplicationStats.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
}
|
||||
z.Compacted, err = dc.ReadBool()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
err = msgp.WrapError(err, "Compacted")
|
||||
return
|
||||
}
|
||||
return
|
||||
@@ -1105,8 +1140,8 @@ func (z *dataUsageEntry) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
|
||||
// EncodeMsg implements msgp.Encodable
|
||||
func (z *dataUsageEntry) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// array header, size 5
|
||||
err = en.Append(0x95)
|
||||
// array header, size 7
|
||||
err = en.Append(0x97)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
@@ -1125,6 +1160,11 @@ func (z *dataUsageEntry) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.Versions)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Versions")
|
||||
return
|
||||
}
|
||||
err = en.WriteArrayHeader(uint32(dataUsageBucketLen))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes")
|
||||
@@ -1137,9 +1177,21 @@ func (z *dataUsageEntry) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
return
|
||||
}
|
||||
}
|
||||
err = z.ReplicationStats.EncodeMsg(en)
|
||||
if z.ReplicationStats == nil {
|
||||
err = en.WriteNil()
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
} else {
|
||||
err = z.ReplicationStats.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
}
|
||||
err = en.WriteBool(z.Compacted)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
err = msgp.WrapError(err, "Compacted")
|
||||
return
|
||||
}
|
||||
return
|
||||
@@ -1148,8 +1200,8 @@ func (z *dataUsageEntry) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// MarshalMsg implements msgp.Marshaler
|
||||
func (z *dataUsageEntry) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
o = msgp.Require(b, z.Msgsize())
|
||||
// array header, size 5
|
||||
o = append(o, 0x95)
|
||||
// array header, size 7
|
||||
o = append(o, 0x97)
|
||||
o, err = z.Children.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
@@ -1157,15 +1209,21 @@ func (z *dataUsageEntry) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
}
|
||||
o = msgp.AppendInt64(o, z.Size)
|
||||
o = msgp.AppendUint64(o, z.Objects)
|
||||
o = msgp.AppendUint64(o, z.Versions)
|
||||
o = msgp.AppendArrayHeader(o, uint32(dataUsageBucketLen))
|
||||
for za0001 := range z.ObjSizes {
|
||||
o = msgp.AppendUint64(o, z.ObjSizes[za0001])
|
||||
}
|
||||
o, err = z.ReplicationStats.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
if z.ReplicationStats == nil {
|
||||
o = msgp.AppendNil(o)
|
||||
} else {
|
||||
o, err = z.ReplicationStats.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
}
|
||||
o = msgp.AppendBool(o, z.Compacted)
|
||||
return
|
||||
}
|
||||
|
||||
@@ -1177,8 +1235,8 @@ func (z *dataUsageEntry) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0001 != 5 {
|
||||
err = msgp.ArrayError{Wanted: 5, Got: zb0001}
|
||||
if zb0001 != 7 {
|
||||
err = msgp.ArrayError{Wanted: 7, Got: zb0001}
|
||||
return
|
||||
}
|
||||
bts, err = z.Children.UnmarshalMsg(bts)
|
||||
@@ -1196,6 +1254,11 @@ func (z *dataUsageEntry) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
z.Versions, bts, err = msgp.ReadUint64Bytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Versions")
|
||||
return
|
||||
}
|
||||
var zb0002 uint32
|
||||
zb0002, bts, err = msgp.ReadArrayHeaderBytes(bts)
|
||||
if err != nil {
|
||||
@@ -1213,9 +1276,25 @@ func (z *dataUsageEntry) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
return
|
||||
}
|
||||
}
|
||||
bts, err = z.ReplicationStats.UnmarshalMsg(bts)
|
||||
if msgp.IsNil(bts) {
|
||||
bts, err = msgp.ReadNilBytes(bts)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
z.ReplicationStats = nil
|
||||
} else {
|
||||
if z.ReplicationStats == nil {
|
||||
z.ReplicationStats = new(replicationStats)
|
||||
}
|
||||
bts, err = z.ReplicationStats.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
}
|
||||
z.Compacted, bts, err = msgp.ReadBoolBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
err = msgp.WrapError(err, "Compacted")
|
||||
return
|
||||
}
|
||||
o = bts
|
||||
@@ -1224,7 +1303,13 @@ func (z *dataUsageEntry) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
|
||||
// Msgsize returns an upper bound estimate of the number of bytes occupied by the serialized message
|
||||
func (z *dataUsageEntry) Msgsize() (s int) {
|
||||
s = 1 + z.Children.Msgsize() + msgp.Int64Size + msgp.Uint64Size + msgp.ArrayHeaderSize + (dataUsageBucketLen * (msgp.Uint64Size)) + z.ReplicationStats.Msgsize()
|
||||
s = 1 + z.Children.Msgsize() + msgp.Int64Size + msgp.Uint64Size + msgp.Uint64Size + msgp.ArrayHeaderSize + (dataUsageBucketLen * (msgp.Uint64Size))
|
||||
if z.ReplicationStats == nil {
|
||||
s += msgp.NilSize
|
||||
} else {
|
||||
s += z.ReplicationStats.Msgsize()
|
||||
}
|
||||
s += msgp.BoolSize
|
||||
return
|
||||
}
|
||||
|
||||
@@ -1275,62 +1360,6 @@ func (z *dataUsageEntryV2) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
return
|
||||
}
|
||||
|
||||
// EncodeMsg implements msgp.Encodable
|
||||
func (z *dataUsageEntryV2) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// array header, size 4
|
||||
err = en.Append(0x94)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteInt64(z.Size)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Size")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.Objects)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
err = en.WriteArrayHeader(uint32(dataUsageBucketLen))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes")
|
||||
return
|
||||
}
|
||||
for za0001 := range z.ObjSizes {
|
||||
err = en.WriteUint64(z.ObjSizes[za0001])
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
err = z.Children.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// MarshalMsg implements msgp.Marshaler
|
||||
func (z *dataUsageEntryV2) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
o = msgp.Require(b, z.Msgsize())
|
||||
// array header, size 4
|
||||
o = append(o, 0x94)
|
||||
o = msgp.AppendInt64(o, z.Size)
|
||||
o = msgp.AppendUint64(o, z.Objects)
|
||||
o = msgp.AppendArrayHeader(o, uint32(dataUsageBucketLen))
|
||||
for za0001 := range z.ObjSizes {
|
||||
o = msgp.AppendUint64(o, z.ObjSizes[za0001])
|
||||
}
|
||||
o, err = z.Children.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageEntryV2) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var zb0001 uint32
|
||||
@@ -1452,86 +1481,6 @@ func (z *dataUsageEntryV3) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
return
|
||||
}
|
||||
|
||||
// EncodeMsg implements msgp.Encodable
|
||||
func (z *dataUsageEntryV3) EncodeMsg(en *msgp.Writer) (err error) {
|
||||
// array header, size 8
|
||||
err = en.Append(0x98)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
err = en.WriteInt64(z.Size)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Size")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.ReplicatedSize)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicatedSize")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.ReplicationPendingSize)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationPendingSize")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.ReplicationFailedSize)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationFailedSize")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.ReplicaSize)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicaSize")
|
||||
return
|
||||
}
|
||||
err = en.WriteUint64(z.Objects)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
err = en.WriteArrayHeader(uint32(dataUsageBucketLen))
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes")
|
||||
return
|
||||
}
|
||||
for za0001 := range z.ObjSizes {
|
||||
err = en.WriteUint64(z.ObjSizes[za0001])
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
err = z.Children.EncodeMsg(en)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// MarshalMsg implements msgp.Marshaler
|
||||
func (z *dataUsageEntryV3) MarshalMsg(b []byte) (o []byte, err error) {
|
||||
o = msgp.Require(b, z.Msgsize())
|
||||
// array header, size 8
|
||||
o = append(o, 0x98)
|
||||
o = msgp.AppendInt64(o, z.Size)
|
||||
o = msgp.AppendUint64(o, z.ReplicatedSize)
|
||||
o = msgp.AppendUint64(o, z.ReplicationPendingSize)
|
||||
o = msgp.AppendUint64(o, z.ReplicationFailedSize)
|
||||
o = msgp.AppendUint64(o, z.ReplicaSize)
|
||||
o = msgp.AppendUint64(o, z.Objects)
|
||||
o = msgp.AppendArrayHeader(o, uint32(dataUsageBucketLen))
|
||||
for za0001 := range z.ObjSizes {
|
||||
o = msgp.AppendUint64(o, z.ObjSizes[za0001])
|
||||
}
|
||||
o, err = z.Children.MarshalMsg(o)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageEntryV3) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var zb0001 uint32
|
||||
@@ -1606,6 +1555,117 @@ func (z *dataUsageEntryV3) Msgsize() (s int) {
|
||||
return
|
||||
}
|
||||
|
||||
// DecodeMsg implements msgp.Decodable
|
||||
func (z *dataUsageEntryV4) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
var zb0001 uint32
|
||||
zb0001, err = dc.ReadArrayHeader()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0001 != 5 {
|
||||
err = msgp.ArrayError{Wanted: 5, Got: zb0001}
|
||||
return
|
||||
}
|
||||
err = z.Children.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
z.Size, err = dc.ReadInt64()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Size")
|
||||
return
|
||||
}
|
||||
z.Objects, err = dc.ReadUint64()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
var zb0002 uint32
|
||||
zb0002, err = dc.ReadArrayHeader()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes")
|
||||
return
|
||||
}
|
||||
if zb0002 != uint32(dataUsageBucketLen) {
|
||||
err = msgp.ArrayError{Wanted: uint32(dataUsageBucketLen), Got: zb0002}
|
||||
return
|
||||
}
|
||||
for za0001 := range z.ObjSizes {
|
||||
z.ObjSizes[za0001], err = dc.ReadUint64()
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
err = z.ReplicationStats.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
// UnmarshalMsg implements msgp.Unmarshaler
|
||||
func (z *dataUsageEntryV4) UnmarshalMsg(bts []byte) (o []byte, err error) {
|
||||
var zb0001 uint32
|
||||
zb0001, bts, err = msgp.ReadArrayHeaderBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err)
|
||||
return
|
||||
}
|
||||
if zb0001 != 5 {
|
||||
err = msgp.ArrayError{Wanted: 5, Got: zb0001}
|
||||
return
|
||||
}
|
||||
bts, err = z.Children.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Children")
|
||||
return
|
||||
}
|
||||
z.Size, bts, err = msgp.ReadInt64Bytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Size")
|
||||
return
|
||||
}
|
||||
z.Objects, bts, err = msgp.ReadUint64Bytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "Objects")
|
||||
return
|
||||
}
|
||||
var zb0002 uint32
|
||||
zb0002, bts, err = msgp.ReadArrayHeaderBytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes")
|
||||
return
|
||||
}
|
||||
if zb0002 != uint32(dataUsageBucketLen) {
|
||||
err = msgp.ArrayError{Wanted: uint32(dataUsageBucketLen), Got: zb0002}
|
||||
return
|
||||
}
|
||||
for za0001 := range z.ObjSizes {
|
||||
z.ObjSizes[za0001], bts, err = msgp.ReadUint64Bytes(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ObjSizes", za0001)
|
||||
return
|
||||
}
|
||||
}
|
||||
bts, err = z.ReplicationStats.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
err = msgp.WrapError(err, "ReplicationStats")
|
||||
return
|
||||
}
|
||||
o = bts
|
||||
return
|
||||
}
|
||||
|
||||
// Msgsize returns an upper bound estimate of the number of bytes occupied by the serialized message
|
||||
func (z *dataUsageEntryV4) Msgsize() (s int) {
|
||||
s = 1 + z.Children.Msgsize() + msgp.Int64Size + msgp.Uint64Size + msgp.ArrayHeaderSize + (dataUsageBucketLen * (msgp.Uint64Size)) + z.ReplicationStats.Msgsize()
|
||||
return
|
||||
}
|
||||
|
||||
// DecodeMsg implements msgp.Decodable
|
||||
func (z *dataUsageHash) DecodeMsg(dc *msgp.Reader) (err error) {
|
||||
{
|
||||
|
||||
@@ -235,232 +235,6 @@ func BenchmarkDecodedataUsageCacheInfo(b *testing.B) {
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshaldataUsageCacheV2(t *testing.T) {
|
||||
v := dataUsageCacheV2{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
left, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after UnmarshalMsg(): %q", len(left), left)
|
||||
}
|
||||
|
||||
left, err = msgp.Skip(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after Skip(): %q", len(left), left)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkMarshalMsgdataUsageCacheV2(b *testing.B) {
|
||||
v := dataUsageCacheV2{}
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.MarshalMsg(nil)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkAppendMsgdataUsageCacheV2(b *testing.B) {
|
||||
v := dataUsageCacheV2{}
|
||||
bts := make([]byte, 0, v.Msgsize())
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkUnmarshaldataUsageCacheV2(b *testing.B) {
|
||||
v := dataUsageCacheV2{}
|
||||
bts, _ := v.MarshalMsg(nil)
|
||||
b.ReportAllocs()
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
_, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestEncodeDecodedataUsageCacheV2(t *testing.T) {
|
||||
v := dataUsageCacheV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
|
||||
m := v.Msgsize()
|
||||
if buf.Len() > m {
|
||||
t.Log("WARNING: TestEncodeDecodedataUsageCacheV2 Msgsize() is inaccurate")
|
||||
}
|
||||
|
||||
vn := dataUsageCacheV2{}
|
||||
err := msgp.Decode(&buf, &vn)
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
|
||||
buf.Reset()
|
||||
msgp.Encode(&buf, &v)
|
||||
err = msgp.NewReader(&buf).Skip()
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkEncodedataUsageCacheV2(b *testing.B) {
|
||||
v := dataUsageCacheV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
en := msgp.NewWriter(msgp.Nowhere)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.EncodeMsg(en)
|
||||
}
|
||||
en.Flush()
|
||||
}
|
||||
|
||||
func BenchmarkDecodedataUsageCacheV2(b *testing.B) {
|
||||
v := dataUsageCacheV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
rd := msgp.NewEndlessReader(buf.Bytes(), b)
|
||||
dc := msgp.NewReader(rd)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
err := v.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshaldataUsageCacheV3(t *testing.T) {
|
||||
v := dataUsageCacheV3{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
left, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after UnmarshalMsg(): %q", len(left), left)
|
||||
}
|
||||
|
||||
left, err = msgp.Skip(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after Skip(): %q", len(left), left)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkMarshalMsgdataUsageCacheV3(b *testing.B) {
|
||||
v := dataUsageCacheV3{}
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.MarshalMsg(nil)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkAppendMsgdataUsageCacheV3(b *testing.B) {
|
||||
v := dataUsageCacheV3{}
|
||||
bts := make([]byte, 0, v.Msgsize())
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkUnmarshaldataUsageCacheV3(b *testing.B) {
|
||||
v := dataUsageCacheV3{}
|
||||
bts, _ := v.MarshalMsg(nil)
|
||||
b.ReportAllocs()
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
_, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestEncodeDecodedataUsageCacheV3(t *testing.T) {
|
||||
v := dataUsageCacheV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
|
||||
m := v.Msgsize()
|
||||
if buf.Len() > m {
|
||||
t.Log("WARNING: TestEncodeDecodedataUsageCacheV3 Msgsize() is inaccurate")
|
||||
}
|
||||
|
||||
vn := dataUsageCacheV3{}
|
||||
err := msgp.Decode(&buf, &vn)
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
|
||||
buf.Reset()
|
||||
msgp.Encode(&buf, &v)
|
||||
err = msgp.NewReader(&buf).Skip()
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkEncodedataUsageCacheV3(b *testing.B) {
|
||||
v := dataUsageCacheV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
en := msgp.NewWriter(msgp.Nowhere)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.EncodeMsg(en)
|
||||
}
|
||||
en.Flush()
|
||||
}
|
||||
|
||||
func BenchmarkDecodedataUsageCacheV3(b *testing.B) {
|
||||
v := dataUsageCacheV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
rd := msgp.NewEndlessReader(buf.Bytes(), b)
|
||||
dc := msgp.NewReader(rd)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
err := v.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshaldataUsageEntry(t *testing.T) {
|
||||
v := dataUsageEntry{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
@@ -574,232 +348,6 @@ func BenchmarkDecodedataUsageEntry(b *testing.B) {
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshaldataUsageEntryV2(t *testing.T) {
|
||||
v := dataUsageEntryV2{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
left, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after UnmarshalMsg(): %q", len(left), left)
|
||||
}
|
||||
|
||||
left, err = msgp.Skip(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after Skip(): %q", len(left), left)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkMarshalMsgdataUsageEntryV2(b *testing.B) {
|
||||
v := dataUsageEntryV2{}
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.MarshalMsg(nil)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkAppendMsgdataUsageEntryV2(b *testing.B) {
|
||||
v := dataUsageEntryV2{}
|
||||
bts := make([]byte, 0, v.Msgsize())
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkUnmarshaldataUsageEntryV2(b *testing.B) {
|
||||
v := dataUsageEntryV2{}
|
||||
bts, _ := v.MarshalMsg(nil)
|
||||
b.ReportAllocs()
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
_, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestEncodeDecodedataUsageEntryV2(t *testing.T) {
|
||||
v := dataUsageEntryV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
|
||||
m := v.Msgsize()
|
||||
if buf.Len() > m {
|
||||
t.Log("WARNING: TestEncodeDecodedataUsageEntryV2 Msgsize() is inaccurate")
|
||||
}
|
||||
|
||||
vn := dataUsageEntryV2{}
|
||||
err := msgp.Decode(&buf, &vn)
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
|
||||
buf.Reset()
|
||||
msgp.Encode(&buf, &v)
|
||||
err = msgp.NewReader(&buf).Skip()
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkEncodedataUsageEntryV2(b *testing.B) {
|
||||
v := dataUsageEntryV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
en := msgp.NewWriter(msgp.Nowhere)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.EncodeMsg(en)
|
||||
}
|
||||
en.Flush()
|
||||
}
|
||||
|
||||
func BenchmarkDecodedataUsageEntryV2(b *testing.B) {
|
||||
v := dataUsageEntryV2{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
rd := msgp.NewEndlessReader(buf.Bytes(), b)
|
||||
dc := msgp.NewReader(rd)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
err := v.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshaldataUsageEntryV3(t *testing.T) {
|
||||
v := dataUsageEntryV3{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
left, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after UnmarshalMsg(): %q", len(left), left)
|
||||
}
|
||||
|
||||
left, err = msgp.Skip(bts)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(left) > 0 {
|
||||
t.Errorf("%d bytes left over after Skip(): %q", len(left), left)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkMarshalMsgdataUsageEntryV3(b *testing.B) {
|
||||
v := dataUsageEntryV3{}
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.MarshalMsg(nil)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkAppendMsgdataUsageEntryV3(b *testing.B) {
|
||||
v := dataUsageEntryV3{}
|
||||
bts := make([]byte, 0, v.Msgsize())
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
bts, _ = v.MarshalMsg(bts[0:0])
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkUnmarshaldataUsageEntryV3(b *testing.B) {
|
||||
v := dataUsageEntryV3{}
|
||||
bts, _ := v.MarshalMsg(nil)
|
||||
b.ReportAllocs()
|
||||
b.SetBytes(int64(len(bts)))
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
_, err := v.UnmarshalMsg(bts)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestEncodeDecodedataUsageEntryV3(t *testing.T) {
|
||||
v := dataUsageEntryV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
|
||||
m := v.Msgsize()
|
||||
if buf.Len() > m {
|
||||
t.Log("WARNING: TestEncodeDecodedataUsageEntryV3 Msgsize() is inaccurate")
|
||||
}
|
||||
|
||||
vn := dataUsageEntryV3{}
|
||||
err := msgp.Decode(&buf, &vn)
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
|
||||
buf.Reset()
|
||||
msgp.Encode(&buf, &v)
|
||||
err = msgp.NewReader(&buf).Skip()
|
||||
if err != nil {
|
||||
t.Error(err)
|
||||
}
|
||||
}
|
||||
|
||||
func BenchmarkEncodedataUsageEntryV3(b *testing.B) {
|
||||
v := dataUsageEntryV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
en := msgp.NewWriter(msgp.Nowhere)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
v.EncodeMsg(en)
|
||||
}
|
||||
en.Flush()
|
||||
}
|
||||
|
||||
func BenchmarkDecodedataUsageEntryV3(b *testing.B) {
|
||||
v := dataUsageEntryV3{}
|
||||
var buf bytes.Buffer
|
||||
msgp.Encode(&buf, &v)
|
||||
b.SetBytes(int64(buf.Len()))
|
||||
rd := msgp.NewEndlessReader(buf.Bytes(), b)
|
||||
dc := msgp.NewReader(rd)
|
||||
b.ReportAllocs()
|
||||
b.ResetTimer()
|
||||
for i := 0; i < b.N; i++ {
|
||||
err := v.DecodeMsg(dc)
|
||||
if err != nil {
|
||||
b.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestMarshalUnmarshalreplicationStats(t *testing.T) {
|
||||
v := replicationStats{}
|
||||
bts, err := v.MarshalMsg(nil)
|
||||
|
||||
+146
-206
@@ -20,6 +20,7 @@ package cmd
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"encoding/json"
|
||||
"fmt"
|
||||
"io/ioutil"
|
||||
"os"
|
||||
@@ -60,6 +61,7 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
return
|
||||
}
|
||||
sizeS.totalSize = s.Size()
|
||||
sizeS.versions++
|
||||
return sizeS, nil
|
||||
}
|
||||
return
|
||||
@@ -93,36 +95,13 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
},
|
||||
{
|
||||
path: "/dir1",
|
||||
size: 2000,
|
||||
objs: 1,
|
||||
oSizes: sizeHistogram{1: 1},
|
||||
size: 1302010,
|
||||
objs: 5,
|
||||
oSizes: sizeHistogram{0: 1, 1: 4},
|
||||
},
|
||||
{
|
||||
path: "/dir1/dira",
|
||||
flatten: true,
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
},
|
||||
{
|
||||
path: "/dir1/dira/",
|
||||
flatten: true,
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
},
|
||||
{
|
||||
path: "/dir1",
|
||||
size: 2000,
|
||||
objs: 1,
|
||||
oSizes: sizeHistogram{0: 0, 1: 1},
|
||||
},
|
||||
{
|
||||
// Children are flattened
|
||||
path: "/dir1/dira/",
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
path: "/dir1/dira",
|
||||
isNil: true,
|
||||
},
|
||||
{
|
||||
path: "/nonexistying",
|
||||
@@ -143,7 +122,6 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
if e == nil {
|
||||
t.Fatal("got nil result")
|
||||
}
|
||||
t.Log(e.Children)
|
||||
if w.flatten {
|
||||
*e = got.flatten(*e)
|
||||
}
|
||||
@@ -153,6 +131,9 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.Versions != uint64(w.objs) {
|
||||
t.Error("got versions", e.Versions, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
@@ -184,80 +165,6 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
name: "rootfile3",
|
||||
size: 1000,
|
||||
},
|
||||
}
|
||||
createUsageTestFiles(t, base, bucket, files)
|
||||
got, err = scanDataFolder(context.Background(), base, got, getSize)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
want = []struct {
|
||||
path string
|
||||
isNil bool
|
||||
size, objs int
|
||||
flatten bool
|
||||
oSizes sizeHistogram
|
||||
}{
|
||||
{
|
||||
path: "/",
|
||||
size: 1363315,
|
||||
flatten: true,
|
||||
objs: 14,
|
||||
oSizes: sizeHistogram{0: 6, 1: 8},
|
||||
},
|
||||
{
|
||||
path: "/",
|
||||
size: 21000,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 1, 1: 2},
|
||||
},
|
||||
{
|
||||
path: "/newfolder",
|
||||
size: 5,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 3},
|
||||
},
|
||||
{
|
||||
path: "/dir1/dira",
|
||||
size: 1300010,
|
||||
flatten: true,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
},
|
||||
{
|
||||
path: "/nonexistying",
|
||||
isNil: true,
|
||||
},
|
||||
}
|
||||
|
||||
for _, w := range want {
|
||||
t.Run(w.path, func(t *testing.T) {
|
||||
e := got.find(path.Join(bucket, w.path))
|
||||
if w.isNil {
|
||||
if e != nil {
|
||||
t.Error("want nil, got", e)
|
||||
}
|
||||
return
|
||||
}
|
||||
if e == nil {
|
||||
t.Fatal("got nil result")
|
||||
}
|
||||
if w.flatten {
|
||||
*e = got.flatten(*e)
|
||||
}
|
||||
if e.Size != int64(w.size) {
|
||||
t.Error("got size", e.Size, "want", w.size)
|
||||
}
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
})
|
||||
}
|
||||
|
||||
files = []usageTestFile{
|
||||
{
|
||||
name: "dir1/dira/dirasub/fileindira2",
|
||||
size: 200,
|
||||
@@ -292,11 +199,21 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
oSizes: sizeHistogram{0: 7, 1: 7},
|
||||
},
|
||||
{
|
||||
path: "/dir1/dira",
|
||||
size: 300210,
|
||||
objs: 4,
|
||||
flatten: true,
|
||||
oSizes: sizeHistogram{0: 2, 1: 2},
|
||||
path: "/dir1",
|
||||
size: 342210,
|
||||
objs: 7,
|
||||
flatten: false,
|
||||
oSizes: sizeHistogram{0: 2, 1: 5},
|
||||
},
|
||||
{
|
||||
path: "/newfolder",
|
||||
size: 5,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 3},
|
||||
},
|
||||
{
|
||||
path: "/nonexistying",
|
||||
isNil: true,
|
||||
},
|
||||
}
|
||||
|
||||
@@ -322,6 +239,9 @@ func TestDataUsageUpdate(t *testing.T) {
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.Versions != uint64(w.objs) {
|
||||
t.Error("got versions", e.Versions, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
@@ -334,7 +254,7 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
if err != nil {
|
||||
t.Skip(err)
|
||||
}
|
||||
base = filepath.Join(base, "bucket")
|
||||
scannerSleeper.Update(0, 0)
|
||||
defer os.RemoveAll(base)
|
||||
var files = []usageTestFile{
|
||||
{name: "bucket/rootfile", size: 10000},
|
||||
@@ -347,6 +267,13 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
{name: "bucket/dir1/dira/dirasub/sublevel3/dccccfile", size: 10},
|
||||
}
|
||||
createUsageTestFiles(t, base, "", files)
|
||||
const foldersBelow = 3
|
||||
const filesBelowT = dataScannerCompactLeastObject / 2
|
||||
const filesAboveT = dataScannerCompactAtFolders + 1
|
||||
const expectSize = foldersBelow*filesBelowT + filesAboveT
|
||||
|
||||
generateUsageTestFiles(t, base, "bucket/dirwithalot", foldersBelow, filesBelowT, 1)
|
||||
generateUsageTestFiles(t, base, "bucket/dirwithevenmore", filesAboveT, 1, 1)
|
||||
|
||||
getSize := func(item scannerItem) (sizeS sizeSummary, err error) {
|
||||
if item.Typ&os.ModeDir == 0 {
|
||||
@@ -356,6 +283,7 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
return
|
||||
}
|
||||
sizeS.totalSize = s.Size()
|
||||
sizeS.versions++
|
||||
return
|
||||
}
|
||||
return
|
||||
@@ -381,9 +309,9 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
}{
|
||||
{
|
||||
path: "flat",
|
||||
size: 1322310,
|
||||
objs: 8,
|
||||
oSizes: sizeHistogram{0: 2, 1: 6},
|
||||
size: 1322310 + expectSize,
|
||||
objs: 8 + expectSize,
|
||||
oSizes: sizeHistogram{0: 2 + expectSize, 1: 6},
|
||||
},
|
||||
{
|
||||
path: "bucket/",
|
||||
@@ -392,22 +320,32 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
oSizes: sizeHistogram{1: 2},
|
||||
},
|
||||
{
|
||||
// Gets compacted...
|
||||
path: "bucket/dir1",
|
||||
size: 2000,
|
||||
objs: 1,
|
||||
oSizes: sizeHistogram{1: 1},
|
||||
size: 1302010,
|
||||
objs: 5,
|
||||
oSizes: sizeHistogram{0: 1, 1: 4},
|
||||
},
|
||||
{
|
||||
path: "bucket/dir1/dira",
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
// Gets compacted at this level...
|
||||
path: "bucket/dirwithalot/0",
|
||||
size: filesBelowT,
|
||||
objs: filesBelowT,
|
||||
oSizes: sizeHistogram{0: filesBelowT},
|
||||
},
|
||||
{
|
||||
path: "bucket/dir1/dira/",
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
// Gets compacted at this level (below obj threshold)...
|
||||
path: "bucket/dirwithalot/0",
|
||||
size: filesBelowT,
|
||||
objs: filesBelowT,
|
||||
oSizes: sizeHistogram{0: filesBelowT},
|
||||
},
|
||||
{
|
||||
// Gets compacted at this level...
|
||||
path: "bucket/dirwithevenmore",
|
||||
size: filesAboveT,
|
||||
objs: filesAboveT,
|
||||
oSizes: sizeHistogram{0: filesAboveT},
|
||||
},
|
||||
{
|
||||
path: "bucket/nonexistying",
|
||||
@@ -437,6 +375,9 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.Versions != uint64(w.objs) {
|
||||
t.Error("got versions", e.Versions, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
@@ -468,78 +409,6 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
name: "bucket/rootfile3",
|
||||
size: 1000,
|
||||
},
|
||||
}
|
||||
createUsageTestFiles(t, base, "", files)
|
||||
got, err = scanDataFolder(context.Background(), base, got, getSize)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
want = []struct {
|
||||
path string
|
||||
isNil bool
|
||||
size, objs int
|
||||
oSizes sizeHistogram
|
||||
}{
|
||||
{
|
||||
path: "flat",
|
||||
size: 1363315,
|
||||
objs: 14,
|
||||
oSizes: sizeHistogram{0: 6, 1: 8},
|
||||
},
|
||||
{
|
||||
path: "bucket/",
|
||||
size: 21000,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 1, 1: 2},
|
||||
},
|
||||
{
|
||||
path: "bucket/newfolder",
|
||||
size: 5,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 3},
|
||||
},
|
||||
{
|
||||
path: "bucket/dir1/dira",
|
||||
size: 1300010,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 1, 1: 3},
|
||||
},
|
||||
{
|
||||
path: "bucket/nonexistying",
|
||||
isNil: true,
|
||||
},
|
||||
}
|
||||
|
||||
for _, w := range want {
|
||||
t.Run(w.path, func(t *testing.T) {
|
||||
e := got.find(w.path)
|
||||
if w.path == "flat" {
|
||||
f := got.flatten(*got.root())
|
||||
e = &f
|
||||
}
|
||||
if w.isNil {
|
||||
if e != nil {
|
||||
t.Error("want nil, got", e)
|
||||
}
|
||||
return
|
||||
}
|
||||
if e == nil {
|
||||
t.Fatal("got nil result")
|
||||
}
|
||||
if e.Size != int64(w.size) {
|
||||
t.Error("got size", e.Size, "want", w.size)
|
||||
}
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
})
|
||||
}
|
||||
|
||||
files = []usageTestFile{
|
||||
{
|
||||
name: "bucket/dir1/dira/dirasub/fileindira2",
|
||||
size: 200,
|
||||
@@ -567,15 +436,36 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
}{
|
||||
{
|
||||
path: "flat",
|
||||
size: 363515,
|
||||
objs: 14,
|
||||
oSizes: sizeHistogram{0: 7, 1: 7},
|
||||
size: 363515 + expectSize,
|
||||
objs: 14 + expectSize,
|
||||
oSizes: sizeHistogram{0: 7 + expectSize, 1: 7},
|
||||
},
|
||||
{
|
||||
path: "bucket/dir1/dira",
|
||||
size: 300210,
|
||||
objs: 4,
|
||||
oSizes: sizeHistogram{0: 2, 1: 2},
|
||||
path: "bucket/dir1",
|
||||
size: 342210,
|
||||
objs: 7,
|
||||
oSizes: sizeHistogram{0: 2, 1: 5},
|
||||
},
|
||||
{
|
||||
path: "bucket/",
|
||||
size: 21000,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 1, 1: 2},
|
||||
},
|
||||
{
|
||||
path: "bucket/newfolder",
|
||||
size: 5,
|
||||
objs: 3,
|
||||
oSizes: sizeHistogram{0: 3},
|
||||
},
|
||||
{
|
||||
// Compacted into bucket/dir1
|
||||
path: "bucket/dir1/dira",
|
||||
isNil: true,
|
||||
},
|
||||
{
|
||||
path: "bucket/nonexistying",
|
||||
isNil: true,
|
||||
},
|
||||
}
|
||||
|
||||
@@ -593,7 +483,8 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
return
|
||||
}
|
||||
if e == nil {
|
||||
t.Fatal("got nil result")
|
||||
t.Error("got nil result")
|
||||
return
|
||||
}
|
||||
if e.Size != int64(w.size) {
|
||||
t.Error("got size", e.Size, "want", w.size)
|
||||
@@ -601,6 +492,9 @@ func TestDataUsageUpdatePrefix(t *testing.T) {
|
||||
if e.Objects != uint64(w.objs) {
|
||||
t.Error("got objects", e.Objects, "want", w.objs)
|
||||
}
|
||||
if e.Versions != uint64(w.objs) {
|
||||
t.Error("got versions", e.Versions, "want", w.objs)
|
||||
}
|
||||
if e.ObjSizes != w.oSizes {
|
||||
t.Error("got histogram", e.ObjSizes, "want", w.oSizes)
|
||||
}
|
||||
@@ -621,6 +515,25 @@ func createUsageTestFiles(t *testing.T, base, bucket string, files []usageTestFi
|
||||
}
|
||||
}
|
||||
|
||||
// generateUsageTestFiles create nFolders * nFiles files of size bytes each.
|
||||
func generateUsageTestFiles(t *testing.T, base, bucket string, nFolders, nFiles, size int) {
|
||||
pl := make([]byte, size)
|
||||
for i := 0; i < nFolders; i++ {
|
||||
name := filepath.Join(base, bucket, fmt.Sprint(i), "0.txt")
|
||||
err := os.MkdirAll(filepath.Dir(name), os.ModePerm)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
for j := 0; j < nFiles; j++ {
|
||||
name := filepath.Join(base, bucket, fmt.Sprint(i), fmt.Sprint(j)+".txt")
|
||||
err = ioutil.WriteFile(name, pl, os.ModePerm)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestDataUsageCacheSerialize(t *testing.T) {
|
||||
base, err := ioutil.TempDir("", "TestDataUsageCacheSerialize")
|
||||
if err != nil {
|
||||
@@ -654,6 +567,7 @@ func TestDataUsageCacheSerialize(t *testing.T) {
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
sizeS.versions++
|
||||
sizeS.totalSize = s.Size()
|
||||
return
|
||||
}
|
||||
@@ -663,6 +577,20 @@ func TestDataUsageCacheSerialize(t *testing.T) {
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
e := want.find("abucket/dir2")
|
||||
e.ReplicationStats = &replicationStats{
|
||||
PendingSize: 1,
|
||||
ReplicatedSize: 2,
|
||||
FailedSize: 3,
|
||||
ReplicaSize: 4,
|
||||
FailedCount: 5,
|
||||
PendingCount: 6,
|
||||
MissedThresholdSize: 7,
|
||||
AfterThresholdSize: 8,
|
||||
MissedThresholdCount: 9,
|
||||
AfterThresholdCount: 10,
|
||||
}
|
||||
want.replace("abucket/dir2", "", *e)
|
||||
var buf bytes.Buffer
|
||||
err = want.serializeTo(&buf)
|
||||
if err != nil {
|
||||
@@ -686,9 +614,21 @@ func TestDataUsageCacheSerialize(t *testing.T) {
|
||||
}
|
||||
for wkey, wval := range want.Cache {
|
||||
gotv := got.Cache[wkey]
|
||||
if fmt.Sprint(gotv) != fmt.Sprint(wval) {
|
||||
t.Errorf("deserialize mismatch, key %v\nwant: %+v\ngot: %+v", wkey, wval, gotv)
|
||||
if !equalAsJSON(gotv, wval) {
|
||||
t.Errorf("deserialize mismatch, key %v\nwant: %#v\ngot: %#v", wkey, wval, gotv)
|
||||
}
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
// equalAsJSON returns whether the values are equal when encoded as JSON.
|
||||
func equalAsJSON(a, b interface{}) bool {
|
||||
aj, err := json.Marshal(a)
|
||||
if err != nil {
|
||||
panic(err)
|
||||
}
|
||||
bj, err := json.Marshal(b)
|
||||
if err != nil {
|
||||
panic(err)
|
||||
}
|
||||
return bytes.Equal(aj, bj)
|
||||
}
|
||||
|
||||
@@ -71,14 +71,14 @@ const (
|
||||
// isEncryptedMultipart returns true if the current object is
|
||||
// uploaded by the user using multipart mechanism:
|
||||
// initiate new multipart, upload part, complete upload
|
||||
func isEncryptedMultipart(objInfo ObjectInfo) bool {
|
||||
if len(objInfo.Parts) == 0 {
|
||||
func (o *ObjectInfo) isEncryptedMultipart() bool {
|
||||
if len(o.Parts) == 0 {
|
||||
return false
|
||||
}
|
||||
if !crypto.IsMultiPart(objInfo.UserDefined) {
|
||||
if !crypto.IsMultiPart(o.UserDefined) {
|
||||
return false
|
||||
}
|
||||
for _, part := range objInfo.Parts {
|
||||
for _, part := range o.Parts {
|
||||
_, err := sio.DecryptedSize(uint64(part.Size))
|
||||
if err != nil {
|
||||
return false
|
||||
@@ -87,7 +87,7 @@ func isEncryptedMultipart(objInfo ObjectInfo) bool {
|
||||
// Further check if this object is uploaded using multipart mechanism
|
||||
// by the user and it is not about Erasure internally splitting the
|
||||
// object into parts in PutObject()
|
||||
return !(objInfo.backendType == BackendErasure && len(objInfo.ETag) == 32)
|
||||
return !(o.backendType == BackendErasure && len(o.ETag) == 32)
|
||||
}
|
||||
|
||||
// ParseSSECopyCustomerRequest parses the SSE-C header fields of the provided request.
|
||||
@@ -427,7 +427,7 @@ func DecryptBlocksRequestR(inputReader io.Reader, h http.Header, seqNumber uint3
|
||||
|
||||
bucket, object := oi.Bucket, oi.Name
|
||||
// Single part case
|
||||
if !isEncryptedMultipart(oi) {
|
||||
if !oi.isEncryptedMultipart() {
|
||||
var reader io.Reader
|
||||
var err error
|
||||
if copySource {
|
||||
@@ -589,7 +589,7 @@ func (o *ObjectInfo) DecryptedSize() (int64, error) {
|
||||
if _, ok := crypto.IsEncrypted(o.UserDefined); !ok {
|
||||
return 0, errors.New("Cannot compute decrypted size of an unencrypted object")
|
||||
}
|
||||
if !isEncryptedMultipart(*o) {
|
||||
if !o.isEncryptedMultipart() {
|
||||
size, err := sio.DecryptedSize(uint64(o.Size))
|
||||
if err != nil {
|
||||
err = errObjectTampered // assign correct error type
|
||||
@@ -732,7 +732,7 @@ func (o *ObjectInfo) GetDecryptedRange(rs *HTTPRangeSpec) (encOff, encLength, sk
|
||||
// Assemble slice of (decrypted) part sizes in `sizes`
|
||||
var sizes []int64
|
||||
var decObjSize int64 // decrypted total object size
|
||||
if isEncryptedMultipart(*o) {
|
||||
if o.isEncryptedMultipart() {
|
||||
sizes = make([]int64, len(o.Parts))
|
||||
for i, part := range o.Parts {
|
||||
var partSize uint64
|
||||
|
||||
@@ -36,6 +36,8 @@ var bucketMetadataOpIgnoredErrs = append(bucketOpIgnoredErrs, errVolumeNotFound)
|
||||
|
||||
// MakeBucket - make a bucket.
|
||||
func (er erasureObjects) MakeBucketWithLocation(ctx context.Context, bucket string, opts BucketOptions) error {
|
||||
defer NSUpdated(bucket, slashSeparator)
|
||||
|
||||
// Verify if bucket is valid.
|
||||
if err := s3utils.CheckValidBucketNameStrict(bucket); err != nil {
|
||||
return BucketNameInvalid{Bucket: bucket}
|
||||
@@ -159,7 +161,8 @@ func deleteDanglingBucket(ctx context.Context, storageDisks []StorageAPI, dErrs
|
||||
// DeleteBucket - deletes a bucket.
|
||||
func (er erasureObjects) DeleteBucket(ctx context.Context, bucket string, forceDelete bool) error {
|
||||
// Collect if all disks report volume not found.
|
||||
defer ObjectPathUpdated(bucket + slashSeparator)
|
||||
defer NSUpdated(bucket, slashSeparator)
|
||||
|
||||
storageDisks := er.getDisks()
|
||||
|
||||
g := errgroup.WithNErrs(len(storageDisks))
|
||||
|
||||
+2
-16
@@ -32,7 +32,6 @@ type parallelReader struct {
|
||||
readers []io.ReaderAt
|
||||
orgReaders []io.ReaderAt
|
||||
dataBlocks int
|
||||
errs []error
|
||||
offset int64
|
||||
shardSize int64
|
||||
shardFileSize int64
|
||||
@@ -49,7 +48,6 @@ func newParallelReader(readers []io.ReaderAt, e Erasure, offset, totalLength int
|
||||
return ¶llelReader{
|
||||
readers: readers,
|
||||
orgReaders: readers,
|
||||
errs: make([]error, len(readers)),
|
||||
dataBlocks: e.dataBlocks,
|
||||
offset: (offset / e.blockSize) * e.ShardSize(),
|
||||
shardSize: e.ShardSize(),
|
||||
@@ -173,7 +171,6 @@ func (p *parallelReader) Read(dst [][]byte) ([][]byte, error) {
|
||||
// This will be communicated upstream.
|
||||
p.orgReaders[bufIdx] = nil
|
||||
p.readers[i] = nil
|
||||
p.errs[i] = err
|
||||
|
||||
// Since ReadAt returned error, trigger another read.
|
||||
readTriggerCh <- true
|
||||
@@ -198,19 +195,8 @@ func (p *parallelReader) Read(dst [][]byte) ([][]byte, error) {
|
||||
return newBuf, nil
|
||||
}
|
||||
|
||||
if countErrs(p.errs, nil) == len(p.errs) {
|
||||
// We have success from all drives this can mean that
|
||||
// all local drives succeeded, but all remote drives
|
||||
// failed to read since p.readers[i] was already nil
|
||||
// for such remote servers - this condition was missed
|
||||
// we would return instead `nil, nil` from this
|
||||
// function - it is safer to simply return Quorum error
|
||||
// when all errs are nil but erasure coding cannot decode
|
||||
// the content.
|
||||
return nil, errErasureReadQuorum
|
||||
}
|
||||
|
||||
return nil, reduceReadQuorumErrs(context.Background(), p.errs, objectOpIgnoredErrs, p.dataBlocks)
|
||||
// If we cannot decode, just return read quorum error.
|
||||
return nil, errErasureReadQuorum
|
||||
}
|
||||
|
||||
// Decode reads from readers, reconstructs data if needed and writes the data to the writer.
|
||||
|
||||
@@ -20,13 +20,12 @@ package cmd
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
crand "crypto/rand"
|
||||
"io"
|
||||
"math/rand"
|
||||
"testing"
|
||||
|
||||
crand "crypto/rand"
|
||||
|
||||
humanize "github.com/dustin/go-humanize"
|
||||
"github.com/dustin/go-humanize"
|
||||
)
|
||||
|
||||
func (a badDisk) ReadFile(ctx context.Context, volume string, path string, offset int64, buf []byte, verifier *BitrotVerifier) (n int64, err error) {
|
||||
@@ -109,8 +108,7 @@ func TestErasureDecode(t *testing.T) {
|
||||
buffer := make([]byte, test.blocksize, 2*test.blocksize)
|
||||
writers := make([]io.Writer, len(disks))
|
||||
for i, disk := range disks {
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object",
|
||||
erasure.ShardFileSize(test.data), writeAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(test.data), writeAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
n, err := erasure.Encode(context.Background(), bytes.NewReader(data[:]), writers, buffer, erasure.dataBlocks+1)
|
||||
closeBitrotWriters(writers)
|
||||
@@ -236,8 +234,7 @@ func TestErasureDecodeRandomOffsetLength(t *testing.T) {
|
||||
if disk == nil {
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object",
|
||||
erasure.ShardFileSize(length), DefaultBitrotAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(length), DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
|
||||
// 10000 iterations with random offsets and lengths.
|
||||
@@ -307,8 +304,7 @@ func benchmarkErasureDecode(data, parity, dataDown, parityDown int, size int64,
|
||||
if disk == nil {
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object",
|
||||
erasure.ShardFileSize(size), DefaultBitrotAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(size), DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
|
||||
content := make([]byte, size)
|
||||
|
||||
@@ -20,7 +20,6 @@ package cmd
|
||||
import (
|
||||
"context"
|
||||
"io"
|
||||
|
||||
"sync"
|
||||
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
|
||||
@@ -109,7 +109,7 @@ func TestErasureEncode(t *testing.T) {
|
||||
if disk == OfflineDisk {
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(int64(len(data[test.offset:]))), test.algorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(int64(len(data[test.offset:]))), test.algorithm, erasure.ShardSize())
|
||||
}
|
||||
n, err := erasure.Encode(context.Background(), bytes.NewReader(data[test.offset:]), writers, buffer, erasure.dataBlocks+1)
|
||||
closeBitrotWriters(writers)
|
||||
@@ -133,7 +133,7 @@ func TestErasureEncode(t *testing.T) {
|
||||
if disk == nil {
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object2", erasure.ShardFileSize(int64(len(data[test.offset:]))), test.algorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object2", erasure.ShardFileSize(int64(len(data[test.offset:]))), test.algorithm, erasure.ShardSize())
|
||||
}
|
||||
for j := range disks[:test.offDisks] {
|
||||
switch w := writers[j].(type) {
|
||||
@@ -197,8 +197,7 @@ func benchmarkErasureEncode(data, parity, dataDown, parityDown int, size int64,
|
||||
continue
|
||||
}
|
||||
disk.Delete(context.Background(), "testbucket", "object", false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object",
|
||||
erasure.ShardFileSize(size), DefaultBitrotAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "object", erasure.ShardFileSize(size), DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
_, err := erasure.Encode(context.Background(), bytes.NewReader(content), writers, buffer, erasure.dataBlocks+1)
|
||||
closeBitrotWriters(writers)
|
||||
|
||||
@@ -91,8 +91,7 @@ func TestErasureHeal(t *testing.T) {
|
||||
buffer := make([]byte, test.blocksize, 2*test.blocksize)
|
||||
writers := make([]io.Writer, len(disks))
|
||||
for i, disk := range disks {
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "testobject",
|
||||
erasure.ShardFileSize(test.size), test.algorithm, erasure.ShardSize(), true)
|
||||
writers[i] = newBitrotWriter(disk, "testbucket", "testobject", erasure.ShardFileSize(test.size), test.algorithm, erasure.ShardSize())
|
||||
}
|
||||
_, err = erasure.Encode(context.Background(), bytes.NewReader(data), writers, buffer, erasure.dataBlocks+1)
|
||||
closeBitrotWriters(writers)
|
||||
@@ -135,8 +134,7 @@ func TestErasureHeal(t *testing.T) {
|
||||
continue
|
||||
}
|
||||
os.Remove(pathJoin(disk.String(), "testbucket", "testobject"))
|
||||
staleWriters[i] = newBitrotWriter(disk, "testbucket", "testobject",
|
||||
erasure.ShardFileSize(test.size), test.algorithm, erasure.ShardSize(), true)
|
||||
staleWriters[i] = newBitrotWriter(disk, "testbucket", "testobject", erasure.ShardFileSize(test.size), test.algorithm, erasure.ShardSize())
|
||||
}
|
||||
|
||||
// Number of buffers, max 2GB
|
||||
|
||||
@@ -198,9 +198,11 @@ func getLatestFileInfo(ctx context.Context, partsMetadata []FileInfo, errs []err
|
||||
// a not-found error or a hash-mismatch error.
|
||||
func disksWithAllParts(ctx context.Context, onlineDisks []StorageAPI, partsMetadata []FileInfo, errs []error, bucket,
|
||||
object string, scanMode madmin.HealScanMode) ([]StorageAPI, []error) {
|
||||
// List of disks having latest version of the object er.meta (by modtime)
|
||||
_, modTime, dataDir := listOnlineDisks(onlineDisks, partsMetadata, errs)
|
||||
|
||||
availableDisks := make([]StorageAPI, len(onlineDisks))
|
||||
dataErrs := make([]error, len(onlineDisks))
|
||||
|
||||
inconsistent := 0
|
||||
for i, meta := range partsMetadata {
|
||||
if !meta.IsValid() {
|
||||
@@ -237,6 +239,13 @@ func disksWithAllParts(ctx context.Context, onlineDisks []StorageAPI, partsMetad
|
||||
continue
|
||||
}
|
||||
meta := partsMetadata[i]
|
||||
|
||||
if !meta.ModTime.Equal(modTime) || meta.DataDir != dataDir {
|
||||
dataErrs[i] = errFileCorrupt
|
||||
partsMetadata[i] = FileInfo{}
|
||||
continue
|
||||
}
|
||||
|
||||
if erasureDistributionReliable {
|
||||
if !meta.IsValid() {
|
||||
continue
|
||||
@@ -262,7 +271,7 @@ func disksWithAllParts(ctx context.Context, onlineDisks []StorageAPI, partsMetad
|
||||
// Always check data, if we got it.
|
||||
if (len(meta.Data) > 0 || meta.Size == 0) && len(meta.Parts) > 0 {
|
||||
checksumInfo := meta.Erasure.GetChecksumInfo(meta.Parts[0].Number)
|
||||
dataErrs[i] = bitrotVerify(bytes.NewBuffer(meta.Data),
|
||||
dataErrs[i] = bitrotVerify(bytes.NewReader(meta.Data),
|
||||
int64(len(meta.Data)),
|
||||
meta.Erasure.ShardFileSize(meta.Size),
|
||||
checksumInfo.Algorithm,
|
||||
@@ -270,6 +279,9 @@ func disksWithAllParts(ctx context.Context, onlineDisks []StorageAPI, partsMetad
|
||||
if dataErrs[i] == nil {
|
||||
// All parts verified, mark it as all data available.
|
||||
availableDisks[i] = onlineDisk
|
||||
} else {
|
||||
// upon errors just make that disk's fileinfo invalid
|
||||
partsMetadata[i] = FileInfo{}
|
||||
}
|
||||
continue
|
||||
}
|
||||
@@ -291,6 +303,9 @@ func disksWithAllParts(ctx context.Context, onlineDisks []StorageAPI, partsMetad
|
||||
if dataErrs[i] == nil {
|
||||
// All parts verified, mark it as all data available.
|
||||
availableDisks[i] = onlineDisk
|
||||
} else {
|
||||
// upon errors just make that disk's fileinfo invalid
|
||||
partsMetadata[i] = FileInfo{}
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
@@ -484,13 +484,15 @@ func TestDisksWithAllParts(t *testing.T) {
|
||||
t.Fatalf("Failed to read xl meta data %v", reducedErr)
|
||||
}
|
||||
|
||||
// Test that all disks are returned without any failures with
|
||||
// Test 1: Test that all disks are returned without any failures with
|
||||
// unmodified meta data
|
||||
partsMetadata, errs := readAllFileInfo(ctx, erasureDisks, bucket, object, "", false)
|
||||
if err != nil {
|
||||
t.Fatalf("Failed to read xl meta data %v", err)
|
||||
}
|
||||
|
||||
erasureDisks, _, _ = listOnlineDisks(erasureDisks, partsMetadata, errs)
|
||||
|
||||
filteredDisks, errs := disksWithAllParts(ctx, erasureDisks, partsMetadata, errs, bucket, object, madmin.HealDeepScan)
|
||||
|
||||
if len(filteredDisks) != len(erasureDisks) {
|
||||
@@ -507,8 +509,48 @@ func TestDisksWithAllParts(t *testing.T) {
|
||||
}
|
||||
}
|
||||
|
||||
// Test 2: Not synchronized modtime
|
||||
partsMetadataBackup := partsMetadata[0]
|
||||
partsMetadata[0].ModTime = partsMetadata[0].ModTime.Add(-1 * time.Hour)
|
||||
|
||||
errs = make([]error, len(erasureDisks))
|
||||
filteredDisks, _ = disksWithAllParts(ctx, erasureDisks, partsMetadata, errs, bucket, object, madmin.HealDeepScan)
|
||||
|
||||
if len(filteredDisks) != len(erasureDisks) {
|
||||
t.Errorf("Unexpected number of disks: %d", len(filteredDisks))
|
||||
}
|
||||
for diskIndex, disk := range filteredDisks {
|
||||
if diskIndex == 0 && disk != nil {
|
||||
t.Errorf("Disk not filtered as expected, disk: %d", diskIndex)
|
||||
}
|
||||
if diskIndex != 0 && disk == nil {
|
||||
t.Errorf("Disk erroneously filtered, diskIndex: %d", diskIndex)
|
||||
}
|
||||
}
|
||||
partsMetadata[0] = partsMetadataBackup // Revert before going to the next test
|
||||
|
||||
// Test 3: Not synchronized DataDir
|
||||
partsMetadataBackup = partsMetadata[1]
|
||||
partsMetadata[1].DataDir = "foo-random"
|
||||
|
||||
errs = make([]error, len(erasureDisks))
|
||||
filteredDisks, _ = disksWithAllParts(ctx, erasureDisks, partsMetadata, errs, bucket, object, madmin.HealDeepScan)
|
||||
|
||||
if len(filteredDisks) != len(erasureDisks) {
|
||||
t.Errorf("Unexpected number of disks: %d", len(filteredDisks))
|
||||
}
|
||||
for diskIndex, disk := range filteredDisks {
|
||||
if diskIndex == 1 && disk != nil {
|
||||
t.Errorf("Disk not filtered as expected, disk: %d", diskIndex)
|
||||
}
|
||||
if diskIndex != 1 && disk == nil {
|
||||
t.Errorf("Disk erroneously filtered, diskIndex: %d", diskIndex)
|
||||
}
|
||||
}
|
||||
partsMetadata[1] = partsMetadataBackup // Revert before going to the next test
|
||||
|
||||
// Test 4: key = disk index, value = part name with hash mismatch
|
||||
diskFailures := make(map[int]string)
|
||||
// key = disk index, value = part name with hash mismatch
|
||||
diskFailures[0] = "part.1"
|
||||
diskFailures[3] = "part.1"
|
||||
diskFailures[15] = "part.1"
|
||||
|
||||
+29
-10
@@ -28,7 +28,6 @@ import (
|
||||
|
||||
"github.com/minio/madmin-go"
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
"github.com/minio/minio/pkg/bucket/lifecycle"
|
||||
"github.com/minio/minio/pkg/sync/errgroup"
|
||||
)
|
||||
|
||||
@@ -38,7 +37,7 @@ import (
|
||||
func (er erasureObjects) HealBucket(ctx context.Context, bucket string, opts madmin.HealOpts) (
|
||||
result madmin.HealResultItem, err error) {
|
||||
if !opts.DryRun {
|
||||
defer ObjectPathUpdated(bucket)
|
||||
defer NSUpdated(bucket, slashSeparator)
|
||||
}
|
||||
|
||||
storageDisks := er.getDisks()
|
||||
@@ -235,6 +234,9 @@ func shouldHealObjectOnDisk(erErr, dataErr error, meta FileInfo, quorumModTime t
|
||||
|
||||
// Heals an object by re-writing corrupt/missing erasure blocks.
|
||||
func (er erasureObjects) healObject(ctx context.Context, bucket string, object string, versionID string, opts madmin.HealOpts) (result madmin.HealResultItem, err error) {
|
||||
if !opts.DryRun {
|
||||
defer NSUpdated(bucket, object)
|
||||
}
|
||||
|
||||
dryRun := opts.DryRun
|
||||
scanMode := opts.ScanMode
|
||||
@@ -267,10 +269,27 @@ func (er erasureObjects) healObject(ctx context.Context, bucket string, object s
|
||||
|
||||
// List of disks having latest version of the object er.meta
|
||||
// (by modtime).
|
||||
latestDisks, modTime, dataDir := listOnlineDisks(storageDisks, partsMetadata, errs)
|
||||
_, modTime, dataDir := listOnlineDisks(storageDisks, partsMetadata, errs)
|
||||
|
||||
// make sure all parts metadata dataDir is same as returned by listOnlineDisks()
|
||||
// the reason is its possible that some of the disks might have stale data, for those
|
||||
// we simply override them with maximally occurring 'dataDir' - this ensures that
|
||||
// disksWithAllParts() verifies same dataDir across all drives.
|
||||
for i := range partsMetadata {
|
||||
partsMetadata[i].DataDir = dataDir
|
||||
}
|
||||
|
||||
// List of disks having all parts as per latest metadata.
|
||||
// NOTE: do not pass in latestDisks to diskWithAllParts since
|
||||
// the diskWithAllParts needs to reach the drive to ensure
|
||||
// validity of the metadata content, we should make sure that
|
||||
// we pass in disks as is for it to be verified. Once verified
|
||||
// the disksWithAllParts() returns the actual disks that can be
|
||||
// used here for reconstruction. This is done to ensure that
|
||||
// we do not skip drives that have inconsistent metadata to be
|
||||
// skipped from purging when they are stale.
|
||||
availableDisks, dataErrs := disksWithAllParts(ctx, storageDisks, partsMetadata, errs, bucket, object, scanMode)
|
||||
|
||||
// List of disks having all parts as per latest er.meta.
|
||||
availableDisks, dataErrs := disksWithAllParts(ctx, latestDisks, partsMetadata, errs, bucket, object, scanMode)
|
||||
// Loop to find number of disks with valid data, per-drive
|
||||
// data state and a list of outdated disks on which data needs
|
||||
// to be healed.
|
||||
@@ -336,6 +355,7 @@ func (er erasureObjects) healObject(ctx context.Context, bucket string, object s
|
||||
// File is fully gone, fileInfo is empty.
|
||||
return defaultHealResult(FileInfo{}, storageDisks, storageEndpoints, errs, bucket, object, versionID, er.defaultParityCount), err
|
||||
}
|
||||
|
||||
// If less than read quorum number of disks have all the parts
|
||||
// of the data, we can't reconstruct the erasure-coded data.
|
||||
if numAvailableDisks < result.DataBlocks {
|
||||
@@ -359,7 +379,6 @@ func (er erasureObjects) healObject(ctx context.Context, bucket string, object s
|
||||
if err != nil {
|
||||
return result, toObjectErr(err, bucket, object, versionID)
|
||||
}
|
||||
defer ObjectPathUpdated(pathJoin(bucket, object))
|
||||
|
||||
cleanFileInfo := func(fi FileInfo) FileInfo {
|
||||
// Returns a copy of the 'fi' with checksums and parts nil'ed.
|
||||
@@ -405,7 +424,7 @@ func (er erasureObjects) healObject(ctx context.Context, bucket string, object s
|
||||
result.ParityBlocks = latestMeta.Erasure.ParityBlocks
|
||||
|
||||
// Reorder so that we have data disks first and parity disks next.
|
||||
latestDisks = shuffleDisks(availableDisks, latestMeta.Erasure.Distribution)
|
||||
latestDisks := shuffleDisks(availableDisks, latestMeta.Erasure.Distribution)
|
||||
outDatedDisks = shuffleDisks(outDatedDisks, latestMeta.Erasure.Distribution)
|
||||
partsMetadata = shufflePartsMetadata(partsMetadata, latestMeta.Erasure.Distribution)
|
||||
copyPartsMetadata = shufflePartsMetadata(copyPartsMetadata, latestMeta.Erasure.Distribution)
|
||||
@@ -447,7 +466,7 @@ func (er erasureObjects) healObject(ctx context.Context, bucket string, object s
|
||||
writers[i] = newStreamingBitrotWriterBuffer(inlineBuffers[i], DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
} else {
|
||||
writers[i] = newBitrotWriter(disk, minioMetaTmpBucket, partPath,
|
||||
tillOffset, DefaultBitrotAlgorithm, erasure.ShardSize(), true)
|
||||
tillOffset, DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
}
|
||||
err = erasure.Heal(ctx, readers, writers, partSize, er.bp)
|
||||
@@ -567,7 +586,7 @@ func (er erasureObjects) healObjectDir(ctx context.Context, bucket, object strin
|
||||
}(index, disk)
|
||||
}
|
||||
wg.Wait()
|
||||
ObjectPathUpdated(pathJoin(bucket, object))
|
||||
NSUpdated(bucket, object)
|
||||
}
|
||||
}
|
||||
|
||||
@@ -823,7 +842,7 @@ func isObjectDangling(metaArr []FileInfo, errs []error, dataErrs []error) (valid
|
||||
break
|
||||
}
|
||||
|
||||
if validMeta.Deleted || validMeta.TransitionStatus == lifecycle.TransitionComplete {
|
||||
if validMeta.Deleted || validMeta.IsRemote() {
|
||||
// notFoundParts is ignored since a
|
||||
// - delete marker does not have any parts
|
||||
// - transition status of complete has no parts
|
||||
|
||||
@@ -482,8 +482,7 @@ func (er erasureObjects) PutObjectPart(ctx context.Context, bucket, object, uplo
|
||||
if disk == nil {
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, minioMetaTmpBucket, tmpPartPath,
|
||||
erasure.ShardFileSize(data.Size()), DefaultBitrotAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, minioMetaTmpBucket, tmpPartPath, erasure.ShardFileSize(data.Size()), DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
|
||||
n, err := erasure.Encode(rctx, data, writers, buffer, writeQuorum)
|
||||
@@ -756,8 +755,6 @@ func (er erasureObjects) CompleteMultipartUpload(ctx context.Context, bucket str
|
||||
return oi, toObjectErr(errFileParentIsFile, bucket, object)
|
||||
}
|
||||
|
||||
defer ObjectPathUpdated(pathJoin(bucket, object))
|
||||
|
||||
// Calculate s3 compatible md5sum for complete multipart.
|
||||
s3MD5 := getCompleteMultipartMD5(parts)
|
||||
|
||||
|
||||
+24
-48
@@ -64,7 +64,8 @@ func (er erasureObjects) CopyObject(ctx context.Context, srcBucket, srcObject, d
|
||||
return oi, NotImplemented{}
|
||||
}
|
||||
|
||||
defer ObjectPathUpdated(pathJoin(dstBucket, dstObject))
|
||||
defer NSUpdated(dstBucket, dstObject)
|
||||
|
||||
if !dstOpts.NoLock {
|
||||
lk := er.NewNSLock(dstBucket, dstObject)
|
||||
lkctx, err := lk.GetLock(ctx, globalOperationTimeout)
|
||||
@@ -285,6 +286,11 @@ func (er erasureObjects) getObjectWithFileInfo(ctx context.Context, bucket, obje
|
||||
}
|
||||
var healOnce sync.Once
|
||||
|
||||
// once we have obtained a common FileInfo i.e latest, we should stick
|
||||
// to single dataDir to read the content to avoid reading from some other
|
||||
// dataDir that has stale FileInfo{} to ensure that we fail appropriately
|
||||
// during reads and expect the same dataDir everywhere.
|
||||
dataDir := fi.DataDir
|
||||
for ; partIndex <= lastPartIndex; partIndex++ {
|
||||
if length == totalBytesRead {
|
||||
break
|
||||
@@ -313,9 +319,8 @@ func (er erasureObjects) getObjectWithFileInfo(ctx context.Context, bucket, obje
|
||||
continue
|
||||
}
|
||||
checksumInfo := metaArr[index].Erasure.GetChecksumInfo(partNumber)
|
||||
partPath := pathJoin(object, metaArr[index].DataDir, fmt.Sprintf("part.%d", partNumber))
|
||||
data := metaArr[index].Data
|
||||
readers[index] = newBitrotReader(disk, data, bucket, partPath, tillOffset,
|
||||
partPath := pathJoin(object, dataDir, fmt.Sprintf("part.%d", partNumber))
|
||||
readers[index] = newBitrotReader(disk, metaArr[index].Data, bucket, partPath, tillOffset,
|
||||
checksumInfo.Algorithm, checksumInfo.Hash, erasure.ShardSize())
|
||||
|
||||
// Prefer local disks
|
||||
@@ -336,10 +341,12 @@ func (er erasureObjects) getObjectWithFileInfo(ctx context.Context, bucket, obje
|
||||
var scan madmin.HealScanMode
|
||||
if errors.Is(err, errFileNotFound) {
|
||||
scan = madmin.HealNormalScan
|
||||
logger.Info("Healing required, attempting to heal missing shards for %s", pathJoin(bucket, object, fi.VersionID))
|
||||
} else if errors.Is(err, errFileCorrupt) {
|
||||
scan = madmin.HealDeepScan
|
||||
logger.Info("Healing required, attempting to heal bitrot for %s", pathJoin(bucket, object, fi.VersionID))
|
||||
}
|
||||
if scan != madmin.HealUnknownScan {
|
||||
if scan == madmin.HealNormalScan || scan == madmin.HealDeepScan {
|
||||
healOnce.Do(func() {
|
||||
if _, healing := er.getOnlineDisksWithHealing(); !healing {
|
||||
go healObject(bucket, object, fi.VersionID, scan)
|
||||
@@ -520,8 +527,7 @@ func undoRename(disks []StorageAPI, srcBucket, srcEntry, dstBucket, dstEntry str
|
||||
|
||||
// Similar to rename but renames data from srcEntry to dstEntry at dataDir
|
||||
func renameData(ctx context.Context, disks []StorageAPI, srcBucket, srcEntry string, metadata []FileInfo, dstBucket, dstEntry string, writeQuorum int) ([]StorageAPI, error) {
|
||||
defer ObjectPathUpdated(pathJoin(srcBucket, srcEntry))
|
||||
defer ObjectPathUpdated(pathJoin(dstBucket, dstEntry))
|
||||
defer NSUpdated(dstBucket, dstEntry)
|
||||
|
||||
g := errgroup.WithNErrs(len(disks))
|
||||
|
||||
@@ -561,8 +567,7 @@ func rename(ctx context.Context, disks []StorageAPI, srcBucket, srcEntry, dstBuc
|
||||
dstEntry = retainSlash(dstEntry)
|
||||
srcEntry = retainSlash(srcEntry)
|
||||
}
|
||||
defer ObjectPathUpdated(pathJoin(srcBucket, srcEntry))
|
||||
defer ObjectPathUpdated(pathJoin(dstBucket, dstEntry))
|
||||
defer NSUpdated(dstBucket, dstEntry)
|
||||
|
||||
g := errgroup.WithNErrs(len(disks))
|
||||
|
||||
@@ -605,14 +610,8 @@ func (er erasureObjects) PutObject(ctx context.Context, bucket string, object st
|
||||
|
||||
// putObject wrapper for erasureObjects PutObject
|
||||
func (er erasureObjects) putObject(ctx context.Context, bucket string, object string, r *PutObjReader, opts ObjectOptions) (objInfo ObjectInfo, err error) {
|
||||
defer func() {
|
||||
ObjectPathUpdated(pathJoin(bucket, object))
|
||||
}()
|
||||
|
||||
data := r.Reader
|
||||
|
||||
uniqueID := mustGetUUID()
|
||||
tempObj := uniqueID
|
||||
// No metadata is set, allocate a new one.
|
||||
if opts.UserDefined == nil {
|
||||
opts.UserDefined = make(map[string]string)
|
||||
@@ -658,7 +657,10 @@ func (er erasureObjects) putObject(ctx context.Context, bucket string, object st
|
||||
if opts.Versioned && fi.VersionID == "" {
|
||||
fi.VersionID = mustGetUUID()
|
||||
}
|
||||
|
||||
fi.DataDir = mustGetUUID()
|
||||
uniqueID := mustGetUUID()
|
||||
tempObj := uniqueID
|
||||
|
||||
// Initialize erasure metadata.
|
||||
for index := range partsMetadata {
|
||||
@@ -731,8 +733,7 @@ func (er erasureObjects) putObject(ctx context.Context, bucket string, object st
|
||||
writers[i] = newStreamingBitrotWriterBuffer(inlineBuffers[i], DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
continue
|
||||
}
|
||||
writers[i] = newBitrotWriter(disk, minioMetaTmpBucket, tempErasureObj,
|
||||
shardFileSize, DefaultBitrotAlgorithm, erasure.ShardSize(), false)
|
||||
writers[i] = newBitrotWriter(disk, minioMetaTmpBucket, tempErasureObj, shardFileSize, DefaultBitrotAlgorithm, erasure.ShardSize())
|
||||
}
|
||||
|
||||
n, erasureErr := erasure.Encode(ctx, data, writers, buffer, writeQuorum)
|
||||
@@ -826,7 +827,6 @@ func (er erasureObjects) putObject(ctx context.Context, bucket string, object st
|
||||
}
|
||||
|
||||
func (er erasureObjects) deleteObjectVersion(ctx context.Context, bucket, object string, writeQuorum int, fi FileInfo, forceDelMarker bool) error {
|
||||
defer ObjectPathUpdated(pathJoin(bucket, object))
|
||||
disks := er.getDisks()
|
||||
g := errgroup.WithNErrs(len(disks))
|
||||
for index := range disks {
|
||||
@@ -842,37 +842,11 @@ func (er erasureObjects) deleteObjectVersion(ctx context.Context, bucket, object
|
||||
return reduceWriteQuorumErrs(ctx, g.Wait(), objectOpIgnoredErrs, writeQuorum)
|
||||
}
|
||||
|
||||
// deleteEmptyDir knows only how to remove an empty directory (not the empty object with a
|
||||
// trailing slash), this is called for the healing code to remove such directories.
|
||||
func (er erasureObjects) deleteEmptyDir(ctx context.Context, bucket, object string) error {
|
||||
defer ObjectPathUpdated(pathJoin(bucket, object))
|
||||
|
||||
if bucket == minioMetaTmpBucket {
|
||||
return nil
|
||||
}
|
||||
|
||||
disks := er.getDisks()
|
||||
g := errgroup.WithNErrs(len(disks))
|
||||
for index := range disks {
|
||||
index := index
|
||||
g.Go(func() error {
|
||||
if disks[index] == nil {
|
||||
return errDiskNotFound
|
||||
}
|
||||
return disks[index].Delete(ctx, bucket, object, false)
|
||||
}, index)
|
||||
}
|
||||
|
||||
// return errors if any during deletion
|
||||
return reduceWriteQuorumErrs(ctx, g.Wait(), objectOpIgnoredErrs, len(disks)/2+1)
|
||||
}
|
||||
|
||||
// deleteObject - wrapper for delete object, deletes an object from
|
||||
// all the disks in parallel, including `xl.meta` associated with the
|
||||
// object.
|
||||
func (er erasureObjects) deleteObject(ctx context.Context, bucket, object string, writeQuorum int) error {
|
||||
var err error
|
||||
defer ObjectPathUpdated(pathJoin(bucket, object))
|
||||
|
||||
disks := er.getDisks()
|
||||
tmpObj := mustGetUUID()
|
||||
@@ -998,7 +972,7 @@ func (er erasureObjects) DeleteObjects(ctx context.Context, bucket string, objec
|
||||
}
|
||||
|
||||
if errs[objIndex] == nil {
|
||||
ObjectPathUpdated(pathJoin(bucket, objects[objIndex].ObjectName))
|
||||
NSUpdated(bucket, objects[objIndex].ObjectName)
|
||||
}
|
||||
|
||||
if versions[objIndex].Deleted {
|
||||
@@ -1058,6 +1032,9 @@ func (er erasureObjects) DeleteObject(ctx context.Context, bucket, object string
|
||||
return objInfo, gerr
|
||||
}
|
||||
}
|
||||
|
||||
defer NSUpdated(bucket, object)
|
||||
|
||||
// Acquire a write lock before deleting the object.
|
||||
lk := er.NewNSLock(bucket, object)
|
||||
lkctx, err := lk.GetLock(ctx, globalDeleteOperationTimeout)
|
||||
@@ -1318,6 +1295,8 @@ func (er erasureObjects) TransitionObject(ctx context.Context, bucket, object st
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
defer NSUpdated(bucket, object)
|
||||
|
||||
// Acquire write lock before starting to transition the object.
|
||||
lk := er.NewNSLock(bucket, object)
|
||||
lkctx, err := lk.GetLock(ctx, globalDeleteOperationTimeout)
|
||||
@@ -1438,9 +1417,6 @@ func (er erasureObjects) updateRestoreMetadata(ctx context.Context, bucket, obje
|
||||
// restoreTransitionedObject for multipart object chunks the file stream from remote tier into the same number of parts
|
||||
// as in the xl.meta for this version and rehydrates the part.n into the fi.DataDir for this version as in the xl.meta
|
||||
func (er erasureObjects) restoreTransitionedObject(ctx context.Context, bucket string, object string, opts ObjectOptions) error {
|
||||
defer func() {
|
||||
ObjectPathUpdated(pathJoin(bucket, object))
|
||||
}()
|
||||
setRestoreHeaderFn := func(oi ObjectInfo, rerr error) error {
|
||||
er.updateRestoreMetadata(ctx, bucket, object, oi, opts, rerr)
|
||||
return rerr
|
||||
|
||||
@@ -324,8 +324,8 @@ func TestGetObjectNoQuorum(t *testing.T) {
|
||||
}
|
||||
|
||||
err = xl.GetObject(ctx, bucket, object, 0, int64(len(buf)), ioutil.Discard, "", opts)
|
||||
if err != toObjectErr(errFileNotFound, bucket, object) {
|
||||
t.Errorf("Expected GetObject to fail with %v, but failed with %v", toObjectErr(errErasureWriteQuorum, bucket, object), err)
|
||||
if err != toObjectErr(errErasureReadQuorum, bucket, object) {
|
||||
t.Errorf("Expected GetObject to fail with %v, but failed with %v", toObjectErr(errErasureReadQuorum, bucket, object), err)
|
||||
}
|
||||
|
||||
// Test use case 2: Make 9 disks offline, which leaves less than quorum number of disks
|
||||
|
||||
@@ -408,6 +408,9 @@ func (z *erasureServerPools) StorageInfo(ctx context.Context) (StorageInfo, []er
|
||||
}
|
||||
|
||||
func (z *erasureServerPools) NSScanner(ctx context.Context, bf *bloomFilter, updates chan<- madmin.DataUsageInfo) error {
|
||||
// Updates must be closed before we return.
|
||||
defer close(updates)
|
||||
|
||||
ctx, cancel := context.WithCancel(ctx)
|
||||
defer cancel()
|
||||
|
||||
|
||||
@@ -84,7 +84,9 @@ func writeDataBlocks(ctx context.Context, dst io.Writer, enBlocks [][]byte, data
|
||||
if write < int64(len(block)) {
|
||||
n, err := io.Copy(dst, bytes.NewReader(block[:write]))
|
||||
if err != nil {
|
||||
if err != io.ErrClosedPipe {
|
||||
// The writer will be closed incase of range queries, which will emit ErrClosedPipe.
|
||||
// The reader pipe might be closed at ListObjects io.EOF ignore it.
|
||||
if err != io.ErrClosedPipe && err != io.EOF {
|
||||
logger.LogIf(ctx, err)
|
||||
}
|
||||
return 0, err
|
||||
@@ -97,7 +99,8 @@ func writeDataBlocks(ctx context.Context, dst io.Writer, enBlocks [][]byte, data
|
||||
n, err := io.Copy(dst, bytes.NewReader(block))
|
||||
if err != nil {
|
||||
// The writer will be closed incase of range queries, which will emit ErrClosedPipe.
|
||||
if err != io.ErrClosedPipe {
|
||||
// The reader pipe might be closed at ListObjects io.EOF ignore it.
|
||||
if err != io.ErrClosedPipe && err != io.EOF {
|
||||
logger.LogIf(ctx, err)
|
||||
}
|
||||
return 0, err
|
||||
|
||||
+20
-1
@@ -31,6 +31,7 @@ import (
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
"github.com/minio/minio/pkg/bpool"
|
||||
"github.com/minio/minio/pkg/color"
|
||||
"github.com/minio/minio/pkg/console"
|
||||
"github.com/minio/minio/pkg/dsync"
|
||||
"github.com/minio/minio/pkg/sync/errgroup"
|
||||
)
|
||||
@@ -475,11 +476,28 @@ func (er erasureObjects) nsScanner(ctx context.Context, buckets []BucketInfo, bf
|
||||
NextCycle: 0,
|
||||
}
|
||||
}
|
||||
// Collect updates.
|
||||
updates := make(chan dataUsageEntry, 1)
|
||||
var wg sync.WaitGroup
|
||||
wg.Add(1)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
for update := range updates {
|
||||
bucketResults <- dataUsageEntryInfo{
|
||||
Name: cache.Info.Name,
|
||||
Parent: dataUsageRoot,
|
||||
Entry: update,
|
||||
}
|
||||
if intDataUpdateTracker.debug {
|
||||
console.Debugln("bucket", bucket.Name, "got update", update)
|
||||
}
|
||||
}
|
||||
}()
|
||||
|
||||
// Calc usage
|
||||
before := cache.Info.LastUpdate
|
||||
var err error
|
||||
cache, err = disk.NSScanner(ctx, cache)
|
||||
cache, err = disk.NSScanner(ctx, cache, updates)
|
||||
cache.Info.BloomFilter = nil
|
||||
if err != nil {
|
||||
if !cache.Info.LastUpdate.IsZero() && cache.Info.LastUpdate.After(before) {
|
||||
@@ -490,6 +508,7 @@ func (er erasureObjects) nsScanner(ctx context.Context, buckets []BucketInfo, bf
|
||||
continue
|
||||
}
|
||||
|
||||
wg.Wait()
|
||||
var root dataUsageEntry
|
||||
if r := cache.root(); r != nil {
|
||||
root = cache.flatten(*r)
|
||||
|
||||
@@ -558,7 +558,7 @@ func (fs *FSObjects) CompleteMultipartUpload(ctx context.Context, bucket string,
|
||||
if _, err := fs.statBucketDir(ctx, bucket); err != nil {
|
||||
return oi, toObjectErr(err, bucket)
|
||||
}
|
||||
defer ObjectPathUpdated(pathutil.Join(bucket, object))
|
||||
defer NSUpdated(bucket, object)
|
||||
|
||||
uploadIDDir := fs.getUploadIDDir(bucket, object, uploadID)
|
||||
// Just check if the uploadID exists to avoid copy if it doesn't.
|
||||
|
||||
+28
-8
@@ -239,6 +239,7 @@ func (fs *FSObjects) StorageInfo(ctx context.Context) (StorageInfo, []error) {
|
||||
|
||||
// NSScanner returns data usage stats of the current FS deployment
|
||||
func (fs *FSObjects) NSScanner(ctx context.Context, bf *bloomFilter, updates chan<- madmin.DataUsageInfo) error {
|
||||
defer close(updates)
|
||||
// Load bucket totals
|
||||
var totalCache dataUsageCache
|
||||
err := totalCache.load(ctx, fs, dataUsageCacheName)
|
||||
@@ -273,7 +274,21 @@ func (fs *FSObjects) NSScanner(ctx context.Context, bf *bloomFilter, updates cha
|
||||
bCache.Info.Name = b.Name
|
||||
}
|
||||
bCache.Info.BloomFilter = totalCache.Info.BloomFilter
|
||||
|
||||
upds := make(chan dataUsageEntry, 1)
|
||||
var wg sync.WaitGroup
|
||||
wg.Add(1)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
for update := range upds {
|
||||
totalCache.replace(b.Name, dataUsageRoot, update)
|
||||
if intDataUpdateTracker.debug {
|
||||
logger.Info(color.Green("NSScanner:")+" Got update:", len(totalCache.Cache))
|
||||
}
|
||||
cloned := totalCache.clone()
|
||||
updates <- cloned.dui(dataUsageRoot, buckets)
|
||||
}
|
||||
}()
|
||||
bCache.Info.updates = upds
|
||||
cache, err := fs.scanBucket(ctx, b.Name, bCache)
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
@@ -282,6 +297,7 @@ func (fs *FSObjects) NSScanner(ctx context.Context, bf *bloomFilter, updates cha
|
||||
}
|
||||
logger.LogIf(ctx, err)
|
||||
cache.Info.BloomFilter = nil
|
||||
wg.Wait()
|
||||
|
||||
if cache.root() == nil {
|
||||
if intDataUpdateTracker.debug {
|
||||
@@ -362,10 +378,10 @@ func (fs *FSObjects) scanBucket(ctx context.Context, bucket string, cache dataUs
|
||||
oi := fsMeta.ToObjectInfo(bucket, object, fi)
|
||||
sz := item.applyActions(ctx, fs, actionMeta{oi: oi}, &sizeSummary{})
|
||||
if sz >= 0 {
|
||||
return sizeSummary{totalSize: sz}, nil
|
||||
return sizeSummary{totalSize: sz, versions: 1}, nil
|
||||
}
|
||||
|
||||
return sizeSummary{totalSize: fi.Size()}, nil
|
||||
return sizeSummary{totalSize: fi.Size(), versions: 1}, nil
|
||||
})
|
||||
|
||||
return cache, err
|
||||
@@ -407,7 +423,8 @@ func (fs *FSObjects) MakeBucketWithLocation(ctx context.Context, bucket string,
|
||||
return BucketNameInvalid{Bucket: bucket}
|
||||
}
|
||||
|
||||
defer ObjectPathUpdated(bucket + slashSeparator)
|
||||
defer NSUpdated(bucket, slashSeparator)
|
||||
|
||||
atomic.AddInt64(&fs.activeIOCount, 1)
|
||||
defer func() {
|
||||
atomic.AddInt64(&fs.activeIOCount, -1)
|
||||
@@ -553,6 +570,8 @@ func (fs *FSObjects) ListBuckets(ctx context.Context) ([]BucketInfo, error) {
|
||||
// DeleteBucket - delete a bucket and all the metadata associated
|
||||
// with the bucket including pending multipart, object metadata.
|
||||
func (fs *FSObjects) DeleteBucket(ctx context.Context, bucket string, forceDelete bool) error {
|
||||
defer NSUpdated(bucket, slashSeparator)
|
||||
|
||||
atomic.AddInt64(&fs.activeIOCount, 1)
|
||||
defer func() {
|
||||
atomic.AddInt64(&fs.activeIOCount, -1)
|
||||
@@ -606,7 +625,7 @@ func (fs *FSObjects) CopyObject(ctx context.Context, srcBucket, srcObject, dstBu
|
||||
}
|
||||
|
||||
cpSrcDstSame := isStringEqual(pathJoin(srcBucket, srcObject), pathJoin(dstBucket, dstObject))
|
||||
defer ObjectPathUpdated(path.Join(dstBucket, dstObject))
|
||||
defer NSUpdated(dstBucket, dstObject)
|
||||
|
||||
if !cpSrcDstSame {
|
||||
objectDWLock := fs.NewNSLock(dstBucket, dstObject)
|
||||
@@ -1079,6 +1098,8 @@ func (fs *FSObjects) PutObject(ctx context.Context, bucket string, object string
|
||||
return ObjectInfo{}, err
|
||||
}
|
||||
|
||||
defer NSUpdated(bucket, object)
|
||||
|
||||
// Lock the object.
|
||||
lk := fs.NewNSLock(bucket, object)
|
||||
lkctx, err := lk.GetLock(ctx, globalOperationTimeout)
|
||||
@@ -1088,7 +1109,6 @@ func (fs *FSObjects) PutObject(ctx context.Context, bucket string, object string
|
||||
}
|
||||
ctx = lkctx.Context()
|
||||
defer lk.Unlock(lkctx.Cancel)
|
||||
defer ObjectPathUpdated(path.Join(bucket, object))
|
||||
|
||||
atomic.AddInt64(&fs.activeIOCount, 1)
|
||||
defer func() {
|
||||
@@ -1256,6 +1276,8 @@ func (fs *FSObjects) DeleteObject(ctx context.Context, bucket, object string, op
|
||||
}
|
||||
}
|
||||
|
||||
defer NSUpdated(bucket, object)
|
||||
|
||||
// Acquire a write lock before deleting the object.
|
||||
lk := fs.NewNSLock(bucket, object)
|
||||
lkctx, err := lk.GetLock(ctx, globalOperationTimeout)
|
||||
@@ -1269,8 +1291,6 @@ func (fs *FSObjects) DeleteObject(ctx context.Context, bucket, object string, op
|
||||
return objInfo, err
|
||||
}
|
||||
|
||||
defer ObjectPathUpdated(path.Join(bucket, object))
|
||||
|
||||
atomic.AddInt64(&fs.activeIOCount, 1)
|
||||
defer func() {
|
||||
atomic.AddInt64(&fs.activeIOCount, -1)
|
||||
|
||||
+6
-18
@@ -18,7 +18,6 @@
|
||||
package cmd
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"encoding/json"
|
||||
"errors"
|
||||
@@ -30,7 +29,6 @@ import (
|
||||
|
||||
jwtgo "github.com/dgrijalva/jwt-go"
|
||||
jsoniter "github.com/json-iterator/go"
|
||||
"github.com/minio/madmin-go"
|
||||
"github.com/minio/minio-go/v7/pkg/set"
|
||||
"github.com/minio/minio/cmd/config"
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
@@ -107,22 +105,12 @@ func (ies *IAMEtcdStore) saveIAMConfig(ctx context.Context, item interface{}, it
|
||||
|
||||
func getIAMConfig(item interface{}, data []byte, itemPath string) error {
|
||||
var err error
|
||||
if !utf8.Valid(data) {
|
||||
if GlobalKMS != nil {
|
||||
data, err = config.DecryptBytes(GlobalKMS, data, kms.Context{
|
||||
minioMetaBucket: path.Join(minioMetaBucket, itemPath),
|
||||
})
|
||||
if err != nil {
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
} else {
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
if !utf8.Valid(data) && GlobalKMS != nil {
|
||||
data, err = config.DecryptBytes(GlobalKMS, data, kms.Context{
|
||||
minioMetaBucket: path.Join(minioMetaBucket, itemPath),
|
||||
})
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
var json = jsoniter.ConfigCompatibleWithStandardLibrary
|
||||
|
||||
+20
-49
@@ -18,10 +18,7 @@
|
||||
package cmd
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"encoding/json"
|
||||
"errors"
|
||||
"path"
|
||||
"strings"
|
||||
"sync"
|
||||
@@ -29,7 +26,6 @@ import (
|
||||
"unicode/utf8"
|
||||
|
||||
jsoniter "github.com/json-iterator/go"
|
||||
"github.com/minio/madmin-go"
|
||||
"github.com/minio/minio/cmd/config"
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
"github.com/minio/minio/pkg/auth"
|
||||
@@ -79,12 +75,8 @@ func (iamOS *IAMObjectStore) runlock() {
|
||||
// location.
|
||||
//
|
||||
// 3. Migrate user identity json file to include version info.
|
||||
func (iamOS *IAMObjectStore) migrateUsersConfigToV1(ctx context.Context, isSTS bool) error {
|
||||
func (iamOS *IAMObjectStore) migrateUsersConfigToV1(ctx context.Context) error {
|
||||
basePrefix := iamConfigUsersPrefix
|
||||
if isSTS {
|
||||
basePrefix = iamConfigSTSPrefix
|
||||
}
|
||||
|
||||
for item := range listIAMConfigItems(ctx, iamOS.objAPI, basePrefix) {
|
||||
if item.Err != nil {
|
||||
return item.Err
|
||||
@@ -113,9 +105,6 @@ func (iamOS *IAMObjectStore) migrateUsersConfigToV1(ctx context.Context, isSTS b
|
||||
// 2. copy policy file to new location.
|
||||
mp := newMappedPolicy(policyName)
|
||||
userType := regularUser
|
||||
if isSTS {
|
||||
userType = stsUser
|
||||
}
|
||||
if err := iamOS.saveMappedPolicy(ctx, user, userType, false, mp); err != nil {
|
||||
return err
|
||||
}
|
||||
@@ -127,7 +116,9 @@ func (iamOS *IAMObjectStore) migrateUsersConfigToV1(ctx context.Context, isSTS b
|
||||
next:
|
||||
// 4. check if user identity has old format.
|
||||
identityPath := pathJoin(basePrefix, user, iamIdentityFile)
|
||||
var cred auth.Credentials
|
||||
var cred = auth.Credentials{
|
||||
AccessKey: user,
|
||||
}
|
||||
if err := iamOS.loadIAMConfig(ctx, &cred, identityPath); err != nil {
|
||||
switch err {
|
||||
case errConfigNotFound:
|
||||
@@ -141,15 +132,11 @@ func (iamOS *IAMObjectStore) migrateUsersConfigToV1(ctx context.Context, isSTS b
|
||||
// If the file is already in the new format,
|
||||
// then the parsed auth.Credentials will have
|
||||
// the zero value for the struct.
|
||||
var zeroCred auth.Credentials
|
||||
if cred.Equal(zeroCred) {
|
||||
if !cred.IsValid() {
|
||||
// nothing to do
|
||||
continue
|
||||
}
|
||||
|
||||
// Found a id file in old format. Copy value
|
||||
// into new format and save it.
|
||||
cred.AccessKey = user
|
||||
u := newUserIdentity(cred)
|
||||
if err := iamOS.saveIAMConfig(ctx, u, identityPath); err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
@@ -171,28 +158,21 @@ func (iamOS *IAMObjectStore) migrateToV1(ctx context.Context) error {
|
||||
case errConfigNotFound:
|
||||
// Need to migrate to V1.
|
||||
default:
|
||||
// if IAM format
|
||||
return err
|
||||
}
|
||||
} else {
|
||||
if iamFmt.Version >= iamFormatVersion1 {
|
||||
// Nothing to do.
|
||||
return nil
|
||||
}
|
||||
// This case should not happen
|
||||
// (i.e. Version is 0 or negative.)
|
||||
return errors.New("got an invalid IAM format version")
|
||||
}
|
||||
|
||||
// Migrate long-term users
|
||||
if err := iamOS.migrateUsersConfigToV1(ctx, false); err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
return err
|
||||
}
|
||||
// Migrate STS users
|
||||
if err := iamOS.migrateUsersConfigToV1(ctx, true); err != nil {
|
||||
if iamFmt.Version >= iamFormatVersion1 {
|
||||
// Nothing to do.
|
||||
return nil
|
||||
}
|
||||
|
||||
if err := iamOS.migrateUsersConfigToV1(ctx); err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
return err
|
||||
}
|
||||
|
||||
// Save iam format to version 1.
|
||||
if err := iamOS.saveIAMConfig(ctx, newIAMFormatVersion1(), path); err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
@@ -207,6 +187,7 @@ func (iamOS *IAMObjectStore) migrateBackendFormat(ctx context.Context) error {
|
||||
}
|
||||
|
||||
func (iamOS *IAMObjectStore) saveIAMConfig(ctx context.Context, item interface{}, objPath string, opts ...options) error {
|
||||
var json = jsoniter.ConfigCompatibleWithStandardLibrary
|
||||
data, err := json.Marshal(item)
|
||||
if err != nil {
|
||||
return err
|
||||
@@ -227,22 +208,12 @@ func (iamOS *IAMObjectStore) loadIAMConfig(ctx context.Context, item interface{}
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
if !utf8.Valid(data) {
|
||||
if GlobalKMS != nil {
|
||||
data, err = config.DecryptBytes(GlobalKMS, data, kms.Context{
|
||||
minioMetaBucket: path.Join(minioMetaBucket, objPath),
|
||||
})
|
||||
if err != nil {
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
} else {
|
||||
data, err = madmin.DecryptData(globalActiveCred.String(), bytes.NewReader(data))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
if !utf8.Valid(data) && GlobalKMS != nil {
|
||||
data, err = config.DecryptBytes(GlobalKMS, data, kms.Context{
|
||||
minioMetaBucket: path.Join(minioMetaBucket, objPath),
|
||||
})
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
var json = jsoniter.ConfigCompatibleWithStandardLibrary
|
||||
|
||||
+68
-70
@@ -401,6 +401,22 @@ func (sys *IAMSys) LoadUser(objAPI ObjectLayer, accessKey string, userType IAMUs
|
||||
if err != nil && err != errNoSuchPolicy {
|
||||
return err
|
||||
}
|
||||
// We are on purpose not persisting the policy map for parent
|
||||
// user, although this is a hack, it is a good enough hack
|
||||
// at this point in time - we need to overhaul our OIDC
|
||||
// usage with service accounts with a more cleaner implementation
|
||||
//
|
||||
// This mapping is necessary to ensure that valid credentials
|
||||
// have necessary ParentUser present - this is mainly for only
|
||||
// webIdentity based STS tokens.
|
||||
cred, ok := sys.iamUsersMap[accessKey]
|
||||
if ok {
|
||||
if cred.IsTemp() && cred.ParentUser != "" && cred.ParentUser != globalActiveCred.AccessKey {
|
||||
if _, ok := sys.iamUserPolicyMap[cred.ParentUser]; !ok {
|
||||
sys.iamUserPolicyMap[cred.ParentUser] = sys.iamUserPolicyMap[accessKey]
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
// When etcd is set, we use watch APIs so this code is not needed.
|
||||
return nil
|
||||
@@ -608,7 +624,7 @@ func (sys *IAMSys) Init(ctx context.Context, objAPI ObjectLayer) {
|
||||
// **** WARNING ****
|
||||
// Migrating to encrypted backend on etcd should happen before initialization of
|
||||
// IAM sub-system, make sure that we do not move the above codeblock elsewhere.
|
||||
if err := migrateIAMConfigsEtcdToEncrypted(lkctx.Context(), globalEtcdClient); err != nil {
|
||||
if err := migrateIAMConfigsEtcdToEncrypted(retryCtx, globalEtcdClient); err != nil {
|
||||
txnLk.Unlock(lkctx.Cancel)
|
||||
logger.LogIf(ctx, fmt.Errorf("Unable to decrypt an encrypted ETCD backend for IAM users and policies: %w", err))
|
||||
logger.LogIf(ctx, errors.New("IAM sub-system is partially initialized, some users may not be available"))
|
||||
@@ -622,7 +638,7 @@ func (sys *IAMSys) Init(ctx context.Context, objAPI ObjectLayer) {
|
||||
}
|
||||
|
||||
// Migrate IAM configuration, if necessary.
|
||||
if err := sys.doIAMConfigMigration(lkctx.Context()); err != nil {
|
||||
if err := sys.doIAMConfigMigration(retryCtx); err != nil {
|
||||
txnLk.Unlock(lkctx.Cancel)
|
||||
if configRetriableErrors(err) {
|
||||
logger.Info("Waiting for all MinIO IAM sub-system to be initialized.. possible cause (%v)", err)
|
||||
@@ -639,7 +655,7 @@ func (sys *IAMSys) Init(ctx context.Context, objAPI ObjectLayer) {
|
||||
}
|
||||
|
||||
for {
|
||||
if err := sys.store.loadAll(ctx, sys); err != nil {
|
||||
if err := sys.store.loadAll(retryCtx, sys); err != nil {
|
||||
if configRetriableErrors(err) {
|
||||
logger.Info("Waiting for all MinIO IAM sub-system to be initialized.. possible cause (%v)", err)
|
||||
time.Sleep(time.Duration(r.Float64() * float64(5*time.Second)))
|
||||
@@ -872,8 +888,14 @@ func (sys *IAMSys) SetTempUser(accessKey string, cred auth.Credentials, policyNa
|
||||
sys.store.lock()
|
||||
defer sys.store.unlock()
|
||||
|
||||
if err := sys.store.saveMappedPolicy(context.Background(), accessKey, stsUser, false, mp, options{ttl: ttl}); err != nil {
|
||||
return err
|
||||
}
|
||||
|
||||
sys.iamUserPolicyMap[accessKey] = mp
|
||||
|
||||
// We are on purpose not persisting the policy map for parent
|
||||
// user, although this is a hack, it is a good enoug hack
|
||||
// user, although this is a hack, it is a good enough hack
|
||||
// at this point in time - we need to overhaul our OIDC
|
||||
// usage with service accounts with a more cleaner implementation
|
||||
//
|
||||
@@ -882,20 +904,9 @@ func (sys *IAMSys) SetTempUser(accessKey string, cred auth.Credentials, policyNa
|
||||
// webIdentity based STS tokens.
|
||||
if cred.IsTemp() && cred.ParentUser != "" && cred.ParentUser != globalActiveCred.AccessKey {
|
||||
if _, ok := sys.iamUserPolicyMap[cred.ParentUser]; !ok {
|
||||
if err := sys.store.saveMappedPolicy(context.Background(), accessKey, stsUser, false, mp, options{ttl: ttl}); err != nil {
|
||||
sys.store.unlock()
|
||||
return err
|
||||
}
|
||||
sys.iamUserPolicyMap[cred.ParentUser] = mp
|
||||
}
|
||||
}
|
||||
|
||||
if err := sys.store.saveMappedPolicy(context.Background(), accessKey, stsUser, false, mp, options{ttl: ttl}); err != nil {
|
||||
sys.store.unlock()
|
||||
return err
|
||||
}
|
||||
|
||||
sys.iamUserPolicyMap[accessKey] = mp
|
||||
} else {
|
||||
sys.store.lock()
|
||||
defer sys.store.unlock()
|
||||
@@ -1115,33 +1126,23 @@ func (sys *IAMSys) NewServiceAccount(ctx context.Context, parentUser string, gro
|
||||
defer sys.store.unlock()
|
||||
|
||||
cr, found := sys.iamUsersMap[parentUser]
|
||||
switch {
|
||||
// User found
|
||||
case found:
|
||||
// Disallow service accounts to further create more service accounts.
|
||||
if cr.IsServiceAccount() {
|
||||
return auth.Credentials{}, errIAMActionNotAllowed
|
||||
// Disallow service accounts to further create more service accounts.
|
||||
if found && cr.IsServiceAccount() {
|
||||
return auth.Credentials{}, errIAMActionNotAllowed
|
||||
}
|
||||
|
||||
policies, err := sys.policyDBGet(parentUser, false)
|
||||
if err != nil {
|
||||
return auth.Credentials{}, err
|
||||
}
|
||||
for _, group := range groups {
|
||||
gpolicies, err := sys.policyDBGet(group, true)
|
||||
if err != nil && err != errNoSuchGroup {
|
||||
return auth.Credentials{}, err
|
||||
}
|
||||
// Allow creating service accounts for root user
|
||||
case parentUser == globalActiveCred.AccessKey:
|
||||
// For LDAP/OpenID users we would need this fallback
|
||||
case sys.usersSysType != MinIOUsersSysType:
|
||||
_, ok := sys.iamUserPolicyMap[parentUser]
|
||||
if !ok {
|
||||
var groupHasPolicy bool
|
||||
for _, group := range groups {
|
||||
_, ok = sys.iamGroupPolicyMap[group]
|
||||
if !ok {
|
||||
continue
|
||||
}
|
||||
groupHasPolicy = true
|
||||
break
|
||||
}
|
||||
if !groupHasPolicy {
|
||||
return auth.Credentials{}, errNoSuchUser
|
||||
}
|
||||
}
|
||||
default:
|
||||
policies = append(policies, gpolicies...)
|
||||
}
|
||||
if len(policies) == 0 {
|
||||
return auth.Credentials{}, errNoSuchUser
|
||||
}
|
||||
|
||||
@@ -1157,7 +1158,6 @@ func (sys *IAMSys) NewServiceAccount(ctx context.Context, parentUser string, gro
|
||||
|
||||
var (
|
||||
cred auth.Credentials
|
||||
err error
|
||||
)
|
||||
|
||||
if len(opts.accessKey) > 0 {
|
||||
@@ -1502,21 +1502,23 @@ func (sys *IAMSys) GetUser(accessKey string) (cred auth.Credentials, ok bool) {
|
||||
|
||||
if ok && cred.IsValid() {
|
||||
if cred.IsServiceAccount() || cred.IsTemp() {
|
||||
// temporary credentials or service accounts
|
||||
// must have their parent in UsersMap
|
||||
if cred.ParentUser == globalActiveCred.AccessKey {
|
||||
// parent exists, so allow temporary and service accounts.
|
||||
ok = true
|
||||
} else {
|
||||
_, ok = sys.iamUserPolicyMap[cred.ParentUser]
|
||||
policies, err := sys.policyDBGet(cred.ParentUser, false)
|
||||
if err != nil {
|
||||
// Reject if the policy map for user doesn't exist anymore.
|
||||
logger.LogIf(context.Background(), fmt.Errorf("'%s' user does not have a policy present", cred.ParentUser))
|
||||
return auth.Credentials{}, false
|
||||
}
|
||||
for _, group := range cred.Groups {
|
||||
ps, err := sys.policyDBGet(group, true)
|
||||
if err != nil {
|
||||
// Reject if the policy map for group doesn't exist anymore.
|
||||
logger.LogIf(context.Background(), fmt.Errorf("'%s' group does not have a policy present", group))
|
||||
return auth.Credentials{}, false
|
||||
}
|
||||
policies = append(policies, ps...)
|
||||
}
|
||||
ok = len(policies) > 0
|
||||
}
|
||||
// for LDAP service accounts with ParentUser set
|
||||
// we have no way to validate, either because user
|
||||
// doesn't need an explicit policy as it can come
|
||||
// automatically from a group. We are safe to ignore
|
||||
// this and continue as policies would fail eventually
|
||||
// the policies are missing or not configured.
|
||||
}
|
||||
return cred, ok && cred.IsValid()
|
||||
}
|
||||
@@ -1892,29 +1894,25 @@ func (sys *IAMSys) policyDBGet(name string, isGroup bool) (policies []string, er
|
||||
return sys.iamGroupPolicyMap[name].toSlice(), nil
|
||||
}
|
||||
|
||||
var u auth.Credentials
|
||||
var ok bool
|
||||
if sys.usersSysType == MinIOUsersSysType {
|
||||
if name == globalActiveCred.AccessKey {
|
||||
return []string{"consoleAdmin"}, nil
|
||||
}
|
||||
|
||||
// When looking for a user's policies, we also check if the user
|
||||
// and the groups they are member of are enabled.
|
||||
u, ok = sys.iamUsersMap[name]
|
||||
if !ok {
|
||||
return nil, errNoSuchUser
|
||||
}
|
||||
if name == globalActiveCred.AccessKey {
|
||||
return []string{"consoleAdmin"}, nil
|
||||
}
|
||||
|
||||
// When looking for a user's policies, we also check if the user
|
||||
// and the groups they are member of are enabled.
|
||||
var parentName string
|
||||
u, ok := sys.iamUsersMap[name]
|
||||
if ok {
|
||||
if !u.IsValid() {
|
||||
return nil, nil
|
||||
}
|
||||
parentName = u.ParentUser
|
||||
}
|
||||
|
||||
mp, ok := sys.iamUserPolicyMap[name]
|
||||
if !ok {
|
||||
if u.ParentUser != "" {
|
||||
mp = sys.iamUserPolicyMap[u.ParentUser]
|
||||
if parentName != "" {
|
||||
mp = sys.iamUserPolicyMap[parentName]
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
@@ -189,11 +189,16 @@ func (z *erasureServerPools) listPath(ctx context.Context, o listPathOptions) (e
|
||||
if err != nil {
|
||||
return true
|
||||
}
|
||||
oFIV, err := existing.fileInfo(o.Bucket)
|
||||
oFIV, err := other.fileInfo(o.Bucket)
|
||||
if err != nil {
|
||||
return false
|
||||
}
|
||||
return oFIV.ModTime.After(eFIV.ModTime)
|
||||
// Replace if modtime is newer
|
||||
if !oFIV.ModTime.Equal(eFIV.ModTime) {
|
||||
return oFIV.ModTime.After(eFIV.ModTime)
|
||||
}
|
||||
// Use NumVersions as a final tiebreaker.
|
||||
return oFIV.NumVersions > eFIV.NumVersions
|
||||
})
|
||||
if entries.len() > o.Limit {
|
||||
allAtEOF = false
|
||||
|
||||
+22
-36
@@ -157,21 +157,16 @@ func (o *listPathOptions) gatherResults(in <-chan metaCacheEntry) func() (metaCa
|
||||
if !o.IncludeDirectories && entry.isDir() {
|
||||
continue
|
||||
}
|
||||
o.debugln("gather got:", entry.name)
|
||||
if o.Marker != "" && entry.name < o.Marker {
|
||||
o.debugln("pre marker")
|
||||
continue
|
||||
}
|
||||
if !strings.HasPrefix(entry.name, o.Prefix) {
|
||||
o.debugln("not in prefix")
|
||||
continue
|
||||
}
|
||||
if !o.Recursive && !entry.isInDir(o.Prefix, o.Separator) {
|
||||
o.debugln("not in dir", o.Prefix, o.Separator)
|
||||
continue
|
||||
}
|
||||
if !o.InclDeleted && entry.isObject() && entry.isLatestDeletemarker() {
|
||||
o.debugln("latest is delete marker")
|
||||
continue
|
||||
}
|
||||
if o.Limit > 0 && results.len() >= o.Limit {
|
||||
@@ -184,7 +179,6 @@ func (o *listPathOptions) gatherResults(in <-chan metaCacheEntry) func() (metaCa
|
||||
}
|
||||
continue
|
||||
}
|
||||
o.debugln("adding...")
|
||||
results.o = append(results.o, entry)
|
||||
}
|
||||
if resCh != nil {
|
||||
@@ -424,11 +418,6 @@ func (er *erasureObjects) streamMetadataParts(ctx context.Context, o listPathOpt
|
||||
|
||||
// We got a stream to start at.
|
||||
loadedPart := 0
|
||||
buf := bufferPool.Get().(*bytes.Buffer)
|
||||
defer func() {
|
||||
buf.Reset()
|
||||
bufferPool.Put(buf)
|
||||
}()
|
||||
for {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
@@ -477,9 +466,27 @@ func (er *erasureObjects) streamMetadataParts(ctx context.Context, o listPathOpt
|
||||
}
|
||||
}
|
||||
}
|
||||
buf.Reset()
|
||||
err := er.getObjectWithFileInfo(ctx, minioMetaBucket, o.objectPath(partN), 0, fi.Size, buf, fi, metaArr, onlineDisks)
|
||||
if err != nil {
|
||||
|
||||
pr, pw := io.Pipe()
|
||||
go func() {
|
||||
werr := er.getObjectWithFileInfo(ctx, minioMetaBucket, o.objectPath(partN), 0,
|
||||
fi.Size, pw, fi, metaArr, onlineDisks)
|
||||
pw.CloseWithError(werr)
|
||||
}()
|
||||
|
||||
tmp := newMetacacheReader(pr)
|
||||
e, err := tmp.filter(o)
|
||||
pr.CloseWithError(err)
|
||||
entries.o = append(entries.o, e.o...)
|
||||
if o.Limit > 0 && entries.len() > o.Limit {
|
||||
entries.truncate(o.Limit)
|
||||
return entries, nil
|
||||
}
|
||||
if err == nil {
|
||||
// We stopped within the listing, we are done for now...
|
||||
return entries, nil
|
||||
}
|
||||
if err != nil && err.Error() != io.EOF.Error() {
|
||||
switch toObjectErr(err, minioMetaBucket, o.objectPath(partN)).(type) {
|
||||
case ObjectNotFound:
|
||||
retries++
|
||||
@@ -494,24 +501,6 @@ func (er *erasureObjects) streamMetadataParts(ctx context.Context, o listPathOpt
|
||||
return entries, err
|
||||
}
|
||||
}
|
||||
tmp, err := newMetacacheReader(buf)
|
||||
if err != nil {
|
||||
return entries, err
|
||||
}
|
||||
e, err := tmp.filter(o)
|
||||
entries.o = append(entries.o, e.o...)
|
||||
if o.Limit > 0 && entries.len() > o.Limit {
|
||||
entries.truncate(o.Limit)
|
||||
return entries, nil
|
||||
}
|
||||
if err == nil {
|
||||
// We stopped within the listing, we are done for now...
|
||||
return entries, nil
|
||||
}
|
||||
if !errors.Is(err, io.EOF) {
|
||||
logger.LogIf(ctx, err)
|
||||
return entries, err
|
||||
}
|
||||
|
||||
// We finished at the end of the block.
|
||||
// And should not expect any more results.
|
||||
@@ -830,10 +819,7 @@ func listPathRaw(ctx context.Context, opts listPathRawOptions) (err error) {
|
||||
// Make sure we close the pipe so blocked writes doesn't stay around.
|
||||
defer r.CloseWithError(context.Canceled)
|
||||
|
||||
readers[i], err = newMetacacheReader(r)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
readers[i] = newMetacacheReader(r)
|
||||
d := disks[i]
|
||||
|
||||
// Send request to each disk.
|
||||
|
||||
+7
-12
@@ -18,7 +18,6 @@
|
||||
package cmd
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"errors"
|
||||
"fmt"
|
||||
@@ -30,6 +29,7 @@ import (
|
||||
"github.com/klauspost/compress/s2"
|
||||
"github.com/minio/minio/cmd/logger"
|
||||
"github.com/tinylib/msgp/msgp"
|
||||
"github.com/valyala/bytebufferpool"
|
||||
)
|
||||
|
||||
// metadata stream format:
|
||||
@@ -246,11 +246,11 @@ type metacacheReader struct {
|
||||
|
||||
// newMetacacheReader creates a new cache reader.
|
||||
// Nothing will be read from the stream yet.
|
||||
func newMetacacheReader(r io.Reader) (*metacacheReader, error) {
|
||||
func newMetacacheReader(r io.Reader) *metacacheReader {
|
||||
dec := s2DecPool.Get().(*s2.Reader)
|
||||
dec.Reset(r)
|
||||
mr := msgp.NewReader(dec)
|
||||
m := metacacheReader{
|
||||
return &metacacheReader{
|
||||
mr: mr,
|
||||
closer: func() {
|
||||
dec.Reset(nil)
|
||||
@@ -269,7 +269,6 @@ func newMetacacheReader(r io.Reader) (*metacacheReader, error) {
|
||||
return nil
|
||||
},
|
||||
}
|
||||
return &m, nil
|
||||
}
|
||||
|
||||
func (r *metacacheReader) checkInit() {
|
||||
@@ -747,12 +746,6 @@ type metacacheBlockWriter struct {
|
||||
blockEntries int
|
||||
}
|
||||
|
||||
var bufferPool = sync.Pool{
|
||||
New: func() interface{} {
|
||||
return new(bytes.Buffer)
|
||||
},
|
||||
}
|
||||
|
||||
// newMetacacheBlockWriter provides a streaming block writer.
|
||||
// Each block is the size of the capacity of the input channel.
|
||||
// The caller should close to indicate the stream has ended.
|
||||
@@ -763,11 +756,13 @@ func newMetacacheBlockWriter(in <-chan metaCacheEntry, nextBlock func(b *metacac
|
||||
defer w.wg.Done()
|
||||
var current metacacheBlock
|
||||
var n int
|
||||
buf := bufferPool.Get().(*bytes.Buffer)
|
||||
|
||||
buf := bytebufferpool.Get()
|
||||
defer func() {
|
||||
buf.Reset()
|
||||
bufferPool.Put(buf)
|
||||
bytebufferpool.Put(buf)
|
||||
}()
|
||||
|
||||
block := newMetacacheWriter(buf, 1<<20)
|
||||
defer block.Close()
|
||||
finishBlock := func() {
|
||||
|
||||
@@ -34,11 +34,7 @@ func loadMetacacheSample(t testing.TB) *metacacheReader {
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
r, err := newMetacacheReader(bytes.NewReader(b))
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
return r
|
||||
return newMetacacheReader(bytes.NewReader(b))
|
||||
}
|
||||
|
||||
func loadMetacacheSampleEntries(t testing.TB) metaCacheEntriesSorted {
|
||||
@@ -388,10 +384,7 @@ func Test_newMetacacheStream(t *testing.T) {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
r, err = newMetacacheReader(&buf)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
r = newMetacacheReader(&buf)
|
||||
defer r.Close()
|
||||
names, err := r.readNames(-1)
|
||||
if err != io.EOF {
|
||||
|
||||
@@ -88,7 +88,7 @@ func (s *xlStorage) WalkDir(ctx context.Context, opts WalkDirOptions, wr io.Writ
|
||||
// Fast exit track to check if we are listing an object with
|
||||
// a trailing slash, this will avoid to list the object content.
|
||||
if HasSuffix(opts.BaseDir, SlashSeparator) {
|
||||
metadata, err := xioutil.ReadFile(pathJoin(volumeDir,
|
||||
metadata, err := s.readMetadata(pathJoin(volumeDir,
|
||||
opts.BaseDir[:len(opts.BaseDir)-1]+globalDirSuffix,
|
||||
xlStorageFormatFile))
|
||||
if err == nil {
|
||||
@@ -97,7 +97,7 @@ func (s *xlStorage) WalkDir(ctx context.Context, opts WalkDirOptions, wr io.Writ
|
||||
// behavior.
|
||||
out <- metaCacheEntry{
|
||||
name: opts.BaseDir,
|
||||
metadata: xlMetaV2TrimData(metadata),
|
||||
metadata: metadata,
|
||||
}
|
||||
} else {
|
||||
if st, err := os.Lstat(pathJoin(volumeDir, opts.BaseDir, xlStorageFormatFile)); err == nil && st.Mode().IsRegular() {
|
||||
@@ -154,12 +154,11 @@ func (s *xlStorage) WalkDir(ctx context.Context, opts WalkDirOptions, wr io.Writ
|
||||
// If root was an object return it as such.
|
||||
if HasSuffix(entry, xlStorageFormatFile) {
|
||||
var meta metaCacheEntry
|
||||
meta.metadata, err = xioutil.ReadFile(pathJoin(volumeDir, current, entry))
|
||||
meta.metadata, err = s.readMetadata(pathJoin(volumeDir, current, entry))
|
||||
if err != nil {
|
||||
logger.LogIf(ctx, err)
|
||||
continue
|
||||
}
|
||||
meta.metadata = xlMetaV2TrimData(meta.metadata)
|
||||
meta.name = strings.TrimSuffix(entry, xlStorageFormatFile)
|
||||
meta.name = strings.TrimSuffix(meta.name, SlashSeparator)
|
||||
meta.name = pathJoin(current, meta.name)
|
||||
@@ -220,7 +219,7 @@ func (s *xlStorage) WalkDir(ctx context.Context, opts WalkDirOptions, wr io.Writ
|
||||
meta.name = meta.name[:len(meta.name)-1] + globalDirSuffixWithSlash
|
||||
}
|
||||
|
||||
meta.metadata, err = xioutil.ReadFile(pathJoin(volumeDir, meta.name, xlStorageFormatFile))
|
||||
meta.metadata, err = s.readMetadata(pathJoin(volumeDir, meta.name, xlStorageFormatFile))
|
||||
switch {
|
||||
case err == nil:
|
||||
// It was an object
|
||||
|
||||
@@ -110,8 +110,8 @@ func (d *naughtyDisk) SetDiskID(id string) {
|
||||
d.disk.SetDiskID(id)
|
||||
}
|
||||
|
||||
func (d *naughtyDisk) NSScanner(ctx context.Context, cache dataUsageCache) (info dataUsageCache, err error) {
|
||||
return d.disk.NSScanner(ctx, cache)
|
||||
func (d *naughtyDisk) NSScanner(ctx context.Context, cache dataUsageCache, updates chan<- dataUsageEntry) (info dataUsageCache, err error) {
|
||||
return d.disk.NSScanner(ctx, cache, updates)
|
||||
}
|
||||
|
||||
func (d *naughtyDisk) DiskInfo(ctx context.Context) (info DiskInfo, err error) {
|
||||
|
||||
+24
-21
@@ -29,30 +29,33 @@ import (
|
||||
// handle all cases where we have known types of errors returned by
|
||||
// underlying storage layer.
|
||||
func toObjectErr(err error, params ...string) error {
|
||||
switch err {
|
||||
case errVolumeNotFound:
|
||||
if err == nil {
|
||||
return nil
|
||||
}
|
||||
switch err.Error() {
|
||||
case errVolumeNotFound.Error():
|
||||
apiErr := BucketNotFound{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
}
|
||||
return apiErr
|
||||
case errVolumeNotEmpty:
|
||||
case errVolumeNotEmpty.Error():
|
||||
apiErr := BucketNotEmpty{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
}
|
||||
return apiErr
|
||||
case errVolumeExists:
|
||||
case errVolumeExists.Error():
|
||||
apiErr := BucketExists{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
}
|
||||
return apiErr
|
||||
case errDiskFull:
|
||||
case errDiskFull.Error():
|
||||
return StorageFull{}
|
||||
case errTooManyOpenFiles:
|
||||
case errTooManyOpenFiles.Error():
|
||||
return SlowDown{}
|
||||
case errFileAccessDenied:
|
||||
case errFileAccessDenied.Error():
|
||||
apiErr := PrefixAccessDenied{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -61,7 +64,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errFileParentIsFile:
|
||||
case errFileParentIsFile.Error():
|
||||
apiErr := ParentIsObject{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -70,7 +73,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errIsNotRegular:
|
||||
case errIsNotRegular.Error():
|
||||
apiErr := ObjectExistsAsDirectory{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -79,7 +82,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errFileVersionNotFound:
|
||||
case errFileVersionNotFound.Error():
|
||||
apiErr := VersionNotFound{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -91,7 +94,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.VersionID = params[2]
|
||||
}
|
||||
return apiErr
|
||||
case errMethodNotAllowed:
|
||||
case errMethodNotAllowed.Error():
|
||||
apiErr := MethodNotAllowed{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -100,7 +103,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errFileNotFound:
|
||||
case errFileNotFound.Error():
|
||||
apiErr := ObjectNotFound{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -109,7 +112,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errUploadIDNotFound:
|
||||
case errUploadIDNotFound.Error():
|
||||
apiErr := InvalidUploadID{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -121,7 +124,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.UploadID = params[2]
|
||||
}
|
||||
return apiErr
|
||||
case errFileNameTooLong:
|
||||
case errFileNameTooLong.Error():
|
||||
apiErr := ObjectNameInvalid{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -130,7 +133,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errDataTooLarge:
|
||||
case errDataTooLarge.Error():
|
||||
apiErr := ObjectTooLarge{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -139,7 +142,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errDataTooSmall:
|
||||
case errDataTooSmall.Error():
|
||||
apiErr := ObjectTooSmall{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -148,7 +151,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errErasureReadQuorum:
|
||||
case errErasureReadQuorum.Error():
|
||||
apiErr := InsufficientReadQuorum{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -157,7 +160,7 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case errErasureWriteQuorum:
|
||||
case errErasureWriteQuorum.Error():
|
||||
apiErr := InsufficientWriteQuorum{}
|
||||
if len(params) >= 1 {
|
||||
apiErr.Bucket = params[0]
|
||||
@@ -166,9 +169,9 @@ func toObjectErr(err error, params ...string) error {
|
||||
apiErr.Object = decodeDirObject(params[1])
|
||||
}
|
||||
return apiErr
|
||||
case io.ErrUnexpectedEOF, io.ErrShortWrite:
|
||||
case io.ErrUnexpectedEOF.Error(), io.ErrShortWrite.Error():
|
||||
return IncompleteBody{}
|
||||
case context.Canceled, context.DeadlineExceeded:
|
||||
case context.Canceled.Error(), context.DeadlineExceeded.Error():
|
||||
return IncompleteBody{}
|
||||
}
|
||||
return err
|
||||
@@ -558,7 +561,7 @@ type InvalidRange struct {
|
||||
}
|
||||
|
||||
func (e InvalidRange) Error() string {
|
||||
return fmt.Sprintf("The requested range \"bytes %d-%d/%d\" is not satisfiable.", e.OffsetBegin, e.OffsetEnd, e.ResourceSize)
|
||||
return fmt.Sprintf("The requested range \"bytes %d -> %d of %d\" is not satisfiable.", e.OffsetBegin, e.OffsetEnd, e.ResourceSize)
|
||||
}
|
||||
|
||||
// ObjectTooLarge error returned when the size of the object > max object size allowed (5G) per request.
|
||||
|
||||
@@ -543,11 +543,6 @@ func getCompressedOffsets(objectInfo ObjectInfo, offset int64) (compressedOffset
|
||||
}
|
||||
}
|
||||
|
||||
if isEncryptedMultipart(objectInfo) && firstPartIdx > 0 {
|
||||
off, _, _, _, _, err := objectInfo.GetDecryptedRange(partNumberToRangeSpec(objectInfo, firstPartIdx))
|
||||
logger.LogIf(context.Background(), err)
|
||||
compressedOffset += off
|
||||
}
|
||||
return compressedOffset, offset - skipLength, firstPartIdx
|
||||
}
|
||||
|
||||
@@ -632,6 +627,7 @@ func NewGetObjectReader(rs *HTTPRangeSpec, oi ObjectInfo, opts ObjectOptions) (
|
||||
if err != nil {
|
||||
return nil, 0, 0, err
|
||||
}
|
||||
|
||||
off, length = int64(0), oi.Size
|
||||
decOff, decLength := int64(0), actualSize
|
||||
if rs != nil {
|
||||
@@ -639,8 +635,10 @@ func NewGetObjectReader(rs *HTTPRangeSpec, oi ObjectInfo, opts ObjectOptions) (
|
||||
if err != nil {
|
||||
return nil, 0, 0, err
|
||||
}
|
||||
|
||||
// In case of range based queries on multiparts, the offset and length are reduced.
|
||||
off, decOff, firstPart = getCompressedOffsets(oi, off)
|
||||
|
||||
decLength = length
|
||||
length = oi.Size - off
|
||||
// For negative length we read everything.
|
||||
|
||||
+36
-33
@@ -278,6 +278,12 @@ func (api objectAPIHandlers) SelectObjectContentHandler(w http.ResponseWriter, r
|
||||
switch kind, _ := crypto.IsEncrypted(objInfo.UserDefined); kind {
|
||||
case crypto.S3:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
case crypto.S3KMS:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsID, objInfo.UserDefined[crypto.MetaKeyID])
|
||||
if kmsCtx, ok := objInfo.UserDefined[crypto.MetaContext]; ok {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsContext, kmsCtx)
|
||||
}
|
||||
case crypto.SSEC:
|
||||
// Validate the SSE-C Key set in the header.
|
||||
if _, err = crypto.SSEC.UnsealObjectKey(r.Header, objInfo.UserDefined, bucket, object); err != nil {
|
||||
@@ -484,6 +490,7 @@ func (api objectAPIHandlers) GetObjectHandler(w http.ResponseWriter, r *http.Req
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
case crypto.S3KMS:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsID, objInfo.UserDefined[crypto.MetaKeyID])
|
||||
if kmsCtx, ok := objInfo.UserDefined[crypto.MetaContext]; ok {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsContext, kmsCtx)
|
||||
}
|
||||
@@ -713,6 +720,7 @@ func (api objectAPIHandlers) HeadObjectHandler(w http.ResponseWriter, r *http.Re
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
case crypto.S3KMS:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsID, objInfo.UserDefined[crypto.MetaKeyID])
|
||||
if kmsCtx, ok := objInfo.UserDefined[crypto.MetaContext]; ok {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsContext, kmsCtx)
|
||||
}
|
||||
@@ -960,11 +968,8 @@ func (api objectAPIHandlers) CopyObjectHandler(w http.ResponseWriter, r *http.Re
|
||||
}
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
_, err = globalBucketSSEConfigSys.Get(dstBucket)
|
||||
// This request header needs to be set prior to setting ObjectOptions
|
||||
if (globalAutoEncryption || err == nil) && !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(dstBucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
var srcOpts, dstOpts ObjectOptions
|
||||
srcOpts, err = copySrcOpts(ctx, r, srcBucket, srcObject)
|
||||
@@ -1285,7 +1290,7 @@ func (api objectAPIHandlers) CopyObjectHandler(w http.ResponseWriter, r *http.Re
|
||||
if rs := r.Header.Get(xhttp.AmzBucketReplicationStatus); rs != "" {
|
||||
srcInfo.UserDefined[xhttp.AmzBucketReplicationStatus] = rs
|
||||
}
|
||||
if ok, _ := mustReplicate(ctx, r, dstBucket, dstObject, srcInfo.UserDefined, srcInfo.ReplicationStatus.String()); ok {
|
||||
if ok, _ := mustReplicate(ctx, r, dstBucket, dstObject, srcInfo.UserDefined, srcInfo.ReplicationStatus.String(), srcInfo.metadataOnly); ok {
|
||||
srcInfo.UserDefined[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
// Store the preserved compression metadata.
|
||||
@@ -1387,7 +1392,7 @@ func (api objectAPIHandlers) CopyObjectHandler(w http.ResponseWriter, r *http.Re
|
||||
objInfo.ETag = getDecryptedETag(r.Header, objInfo, false)
|
||||
response := generateCopyObjectResponse(objInfo.ETag, objInfo.ModTime)
|
||||
encodedSuccessResponse := encodeResponse(response)
|
||||
if replicate, sync := mustReplicate(ctx, r, dstBucket, dstObject, objInfo.UserDefined, objInfo.ReplicationStatus.String()); replicate {
|
||||
if replicate, sync := mustReplicate(ctx, r, dstBucket, dstObject, objInfo.UserDefined, objInfo.ReplicationStatus.String(), objInfo.metadataOnly); replicate {
|
||||
scheduleReplication(ctx, objInfo.Clone(), objectAPI, sync, replication.ObjectReplicationType)
|
||||
}
|
||||
|
||||
@@ -1566,11 +1571,8 @@ func (api objectAPIHandlers) PutObjectHandler(w http.ResponseWriter, r *http.Req
|
||||
}
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
_, err = globalBucketSSEConfigSys.Get(bucket)
|
||||
// This request header needs to be set prior to setting ObjectOptions
|
||||
if (globalAutoEncryption || err == nil) && !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(bucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
actualSize := size
|
||||
if objectAPI.IsCompressionSupported() && isCompressible(r.Header, object) && size > 0 {
|
||||
@@ -1634,7 +1636,7 @@ func (api objectAPIHandlers) PutObjectHandler(w http.ResponseWriter, r *http.Req
|
||||
writeErrorResponse(ctx, w, errorCodes.ToAPIErr(s3Err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, ""); ok {
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, "", false); ok {
|
||||
metadata[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
if r.Header.Get(xhttp.AmzBucketReplicationStatus) == replication.Replica.String() {
|
||||
@@ -1702,6 +1704,7 @@ func (api objectAPIHandlers) PutObjectHandler(w http.ResponseWriter, r *http.Req
|
||||
objInfo.ETag, _ = DecryptETag(objectEncryptionKey, ObjectInfo{ETag: objInfo.ETag})
|
||||
case crypto.S3KMS:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsID, objInfo.UserDefined[crypto.MetaKeyID])
|
||||
if kmsCtx, ok := objInfo.UserDefined[crypto.MetaContext]; ok {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsContext, kmsCtx)
|
||||
}
|
||||
@@ -1721,7 +1724,7 @@ func (api objectAPIHandlers) PutObjectHandler(w http.ResponseWriter, r *http.Req
|
||||
objInfo.ETag = objInfo.ETag + "-1"
|
||||
}
|
||||
}
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, metadata, ""); replicate {
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, metadata, "", false); replicate {
|
||||
scheduleReplication(ctx, objInfo.Clone(), objectAPI, sync, replication.ObjectReplicationType)
|
||||
}
|
||||
|
||||
@@ -1885,11 +1888,8 @@ func (api objectAPIHandlers) PutObjectExtractHandler(w http.ResponseWriter, r *h
|
||||
}
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
_, err = globalBucketSSEConfigSys.Get(bucket)
|
||||
// This request header needs to be set prior to setting ObjectOptions
|
||||
if (globalAutoEncryption || err == nil) && !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(bucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
retPerms := isPutActionAllowed(ctx, getRequestAuthType(r), bucket, object, r, iampolicy.PutObjectRetentionAction)
|
||||
holdPerms := isPutActionAllowed(ctx, getRequestAuthType(r), bucket, object, r, iampolicy.PutObjectLegalHoldAction)
|
||||
@@ -1960,7 +1960,7 @@ func (api objectAPIHandlers) PutObjectExtractHandler(w http.ResponseWriter, r *h
|
||||
return
|
||||
}
|
||||
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, ""); ok {
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, "", false); ok {
|
||||
metadata[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
|
||||
@@ -2016,8 +2016,9 @@ func (api objectAPIHandlers) PutObjectExtractHandler(w http.ResponseWriter, r *h
|
||||
return
|
||||
}
|
||||
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, metadata, ""); replicate {
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, metadata, "", false); replicate {
|
||||
scheduleReplication(ctx, objInfo.Clone(), objectAPI, sync, replication.ObjectReplicationType)
|
||||
|
||||
}
|
||||
|
||||
}
|
||||
@@ -2075,11 +2076,8 @@ func (api objectAPIHandlers) NewMultipartUploadHandler(w http.ResponseWriter, r
|
||||
}
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
_, err = globalBucketSSEConfigSys.Get(bucket)
|
||||
// This request header needs to be set prior to setting ObjectOptions
|
||||
if (globalAutoEncryption || err == nil) && !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(bucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
// Validate storage class metadata if present
|
||||
if sc := r.Header.Get(xhttp.AmzStorageClass); sc != "" {
|
||||
@@ -2130,7 +2128,7 @@ func (api objectAPIHandlers) NewMultipartUploadHandler(w http.ResponseWriter, r
|
||||
writeErrorResponse(ctx, w, errorCodes.ToAPIErr(s3Err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, ""); ok {
|
||||
if ok, _ := mustReplicate(ctx, r, bucket, object, metadata, "", false); ok {
|
||||
metadata[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
// We need to preserve the encryption headers set in EncryptRequest,
|
||||
@@ -3120,7 +3118,7 @@ func (api objectAPIHandlers) CompleteMultipartUploadHandler(w http.ResponseWrite
|
||||
}
|
||||
|
||||
setPutObjHeaders(w, objInfo, false)
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, objInfo.ReplicationStatus.String()); replicate {
|
||||
if replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, objInfo.ReplicationStatus.String(), false); replicate {
|
||||
scheduleReplication(ctx, objInfo.Clone(), objectAPI, sync, replication.ObjectReplicationType)
|
||||
}
|
||||
|
||||
@@ -3381,7 +3379,7 @@ func (api objectAPIHandlers) PutObjectLegalHoldHandler(w http.ResponseWriter, r
|
||||
return
|
||||
}
|
||||
objInfo.UserDefined[strings.ToLower(xhttp.AmzObjectLockLegalHold)] = strings.ToUpper(string(legalHold.Status))
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, "")
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, objInfo.ReplicationStatus.String(), true)
|
||||
if replicate {
|
||||
objInfo.UserDefined[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
@@ -3560,7 +3558,7 @@ func (api objectAPIHandlers) PutObjectRetentionHandler(w http.ResponseWriter, r
|
||||
objInfo.UserDefined[strings.ToLower(xhttp.AmzObjectLockMode)] = ""
|
||||
objInfo.UserDefined[strings.ToLower(xhttp.AmzObjectLockRetainUntilDate)] = ""
|
||||
}
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, "")
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, objInfo.UserDefined, objInfo.ReplicationStatus.String(), true)
|
||||
if replicate {
|
||||
objInfo.UserDefined[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
}
|
||||
@@ -3752,7 +3750,12 @@ func (api objectAPIHandlers) PutObjectTaggingHandler(w http.ResponseWriter, r *h
|
||||
return
|
||||
}
|
||||
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, map[string]string{xhttp.AmzObjectTagging: tags.String()}, "")
|
||||
objInfo, err := objAPI.GetObjectInfo(ctx, bucket, object, opts)
|
||||
if err != nil {
|
||||
writeErrorResponse(ctx, w, toAPIError(ctx, err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, map[string]string{xhttp.AmzObjectTagging: tags.String()}, objInfo.ReplicationStatus.String(), true)
|
||||
if replicate {
|
||||
opts.UserDefined = make(map[string]string)
|
||||
opts.UserDefined[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
@@ -3761,7 +3764,7 @@ func (api objectAPIHandlers) PutObjectTaggingHandler(w http.ResponseWriter, r *h
|
||||
tagsStr := tags.String()
|
||||
|
||||
// Put object tags
|
||||
objInfo, err := objAPI.PutObjectTags(ctx, bucket, object, tagsStr, opts)
|
||||
objInfo, err = objAPI.PutObjectTags(ctx, bucket, object, tagsStr, opts)
|
||||
if err != nil {
|
||||
writeErrorResponse(ctx, w, toAPIError(ctx, err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
@@ -3829,7 +3832,7 @@ func (api objectAPIHandlers) DeleteObjectTaggingHandler(w http.ResponseWriter, r
|
||||
writeErrorResponse(ctx, w, toAPIError(ctx, err), r.URL, guessIsBrowserReq(r))
|
||||
return
|
||||
}
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, map[string]string{xhttp.AmzObjectTagging: oi.UserTags}, "")
|
||||
replicate, sync := mustReplicate(ctx, r, bucket, object, map[string]string{xhttp.AmzObjectTagging: oi.UserTags}, oi.ReplicationStatus.String(), true)
|
||||
if replicate {
|
||||
opts.UserDefined = make(map[string]string)
|
||||
opts.UserDefined[xhttp.AmzBucketReplicationStatus] = replication.Pending.String()
|
||||
|
||||
+24
-11
@@ -42,12 +42,21 @@ func access(name string) error {
|
||||
const blockSize = 8 << 10 // 8192
|
||||
|
||||
// By default atleast 128 entries in single getdents call (1MiB buffer)
|
||||
var direntPool = sync.Pool{
|
||||
New: func() interface{} {
|
||||
buf := make([]byte, blockSize*128)
|
||||
return &buf
|
||||
},
|
||||
}
|
||||
var (
|
||||
direntPool = sync.Pool{
|
||||
New: func() interface{} {
|
||||
buf := make([]byte, blockSize*128)
|
||||
return &buf
|
||||
},
|
||||
}
|
||||
|
||||
direntNamePool = sync.Pool{
|
||||
New: func() interface{} {
|
||||
buf := make([]byte, blockSize)
|
||||
return &buf
|
||||
},
|
||||
}
|
||||
)
|
||||
|
||||
// unexpectedFileMode is a sentinel (and bogus) os.FileMode
|
||||
// value used to represent a syscall.DT_UNKNOWN Dirent.Type.
|
||||
@@ -107,7 +116,10 @@ func readDirFn(dirPath string, fn func(name string, typ os.FileMode) error) erro
|
||||
}
|
||||
defer f.Close()
|
||||
|
||||
buf := make([]byte, blockSize)
|
||||
bufp := direntPool.Get().(*[]byte)
|
||||
defer direntPool.Put(bufp)
|
||||
buf := *bufp
|
||||
|
||||
boff := 0 // starting read position in buf
|
||||
nbuf := 0 // end valid data in buf
|
||||
|
||||
@@ -181,9 +193,10 @@ func readDirN(dirPath string, count int) (entries []string, err error) {
|
||||
|
||||
bufp := direntPool.Get().(*[]byte)
|
||||
defer direntPool.Put(bufp)
|
||||
buf := *bufp
|
||||
|
||||
nameTmp := direntPool.Get().(*[]byte)
|
||||
defer direntPool.Put(nameTmp)
|
||||
nameTmp := direntNamePool.Get().(*[]byte)
|
||||
defer direntNamePool.Put(nameTmp)
|
||||
tmp := *nameTmp
|
||||
|
||||
boff := 0 // starting read position in buf
|
||||
@@ -192,7 +205,7 @@ func readDirN(dirPath string, count int) (entries []string, err error) {
|
||||
for count != 0 {
|
||||
if boff >= nbuf {
|
||||
boff = 0
|
||||
nbuf, err = syscall.ReadDirent(int(f.Fd()), *bufp)
|
||||
nbuf, err = syscall.ReadDirent(int(f.Fd()), buf)
|
||||
if err != nil {
|
||||
if isSysErrNotDir(err) {
|
||||
return nil, errFileNotFound
|
||||
@@ -203,7 +216,7 @@ func readDirN(dirPath string, count int) (entries []string, err error) {
|
||||
break
|
||||
}
|
||||
}
|
||||
consumed, name, typ, err := parseDirEnt((*bufp)[boff:nbuf])
|
||||
consumed, name, typ, err := parseDirEnt(buf[boff:nbuf])
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
|
||||
+3
-1
@@ -92,8 +92,10 @@ func mkdirAll(dirPath string, mode os.FileMode) (err error) {
|
||||
// directory" error message. Handle this specifically here.
|
||||
return errFileAccessDenied
|
||||
}
|
||||
return osErrToFileErr(err)
|
||||
}
|
||||
return err
|
||||
|
||||
return nil
|
||||
}
|
||||
|
||||
// Reliably retries os.MkdirAll if for some reason os.MkdirAll returns
|
||||
|
||||
+12
-9
@@ -120,10 +120,10 @@ func formatErasureCleanupTmpLocalEndpoints(endpoints Endpoints) error {
|
||||
tmpOld := pathJoin(epPath, minioMetaTmpBucket+"-old", mustGetUUID())
|
||||
if err := renameAll(pathJoin(epPath, minioMetaTmpBucket),
|
||||
tmpOld); err != nil && err != errFileNotFound {
|
||||
return fmt.Errorf("unable to rename (%s -> %s) %w",
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("unable to rename (%s -> %s) %w, drive may be faulty please investigate",
|
||||
pathJoin(epPath, minioMetaTmpBucket),
|
||||
tmpOld,
|
||||
osErrToFileErr(err))
|
||||
osErrToFileErr(err)))
|
||||
}
|
||||
|
||||
// Renames and schedules for puring all bucket metacache.
|
||||
@@ -133,9 +133,9 @@ func formatErasureCleanupTmpLocalEndpoints(endpoints Endpoints) error {
|
||||
go removeAll(pathJoin(epPath, minioMetaTmpBucket+"-old"))
|
||||
|
||||
if err := mkdirAll(pathJoin(epPath, minioMetaTmpBucket), 0777); err != nil {
|
||||
return fmt.Errorf("unable to create (%s) %w",
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("unable to create (%s) %w, drive may be faulty please investigate",
|
||||
pathJoin(epPath, minioMetaTmpBucket),
|
||||
err)
|
||||
err))
|
||||
}
|
||||
return nil
|
||||
}, index)
|
||||
@@ -224,11 +224,10 @@ func connectLoadInitFormats(retryCount int, firstDisk bool, endpoints Endpoints,
|
||||
|
||||
for i, err := range errs {
|
||||
if err != nil {
|
||||
if err != errDiskNotFound {
|
||||
return nil, nil, fmt.Errorf("Disk %s: %w", endpoints[i], err)
|
||||
}
|
||||
if retryCount >= 5 {
|
||||
logger.Info("Unable to connect to %s: %v\n", endpoints[i], isServerResolvable(endpoints[i], time.Second))
|
||||
if err == errDiskNotFound && retryCount >= 5 {
|
||||
logger.Info("Unable to connect to %s: %v", endpoints[i], isServerResolvable(endpoints[i], time.Second))
|
||||
} else {
|
||||
logger.Info("Unable to use the drive %s: %v", endpoints[i], err)
|
||||
}
|
||||
}
|
||||
}
|
||||
@@ -292,6 +291,7 @@ func connectLoadInitFormats(retryCount int, firstDisk bool, endpoints Endpoints,
|
||||
// the disk UUID association. Below function is called to handle and fix
|
||||
// this regression, for more info refer https://github.com/minio/minio/issues/5667
|
||||
if err = fixFormatErasureV3(storageDisks, endpoints, formatConfigs); err != nil {
|
||||
logger.LogIf(GlobalContext, err)
|
||||
return nil, nil, err
|
||||
}
|
||||
|
||||
@@ -302,6 +302,7 @@ func connectLoadInitFormats(retryCount int, firstDisk bool, endpoints Endpoints,
|
||||
|
||||
format, err = getFormatErasureInQuorum(formatConfigs)
|
||||
if err != nil {
|
||||
logger.LogIf(GlobalContext, err)
|
||||
return nil, nil, err
|
||||
}
|
||||
|
||||
@@ -311,6 +312,7 @@ func connectLoadInitFormats(retryCount int, firstDisk bool, endpoints Endpoints,
|
||||
return nil, nil, errNotFirstDisk
|
||||
}
|
||||
if err = formatErasureFixDeploymentID(endpoints, storageDisks, format); err != nil {
|
||||
logger.LogIf(GlobalContext, err)
|
||||
return nil, nil, err
|
||||
}
|
||||
}
|
||||
@@ -318,6 +320,7 @@ func connectLoadInitFormats(retryCount int, firstDisk bool, endpoints Endpoints,
|
||||
globalDeploymentID = format.ID
|
||||
|
||||
if err = formatErasureFixLocalDeploymentID(endpoints, storageDisks, format); err != nil {
|
||||
logger.LogIf(GlobalContext, err)
|
||||
return nil, nil, err
|
||||
}
|
||||
|
||||
|
||||
+6
-3
@@ -22,6 +22,7 @@ import (
|
||||
"crypto/tls"
|
||||
"errors"
|
||||
"fmt"
|
||||
"io"
|
||||
"math/rand"
|
||||
"net"
|
||||
"os"
|
||||
@@ -264,6 +265,7 @@ func configRetriableErrors(err error) bool {
|
||||
errors.Is(err, context.DeadlineExceeded) ||
|
||||
errors.Is(err, errErasureWriteQuorum) ||
|
||||
errors.Is(err, errErasureReadQuorum) ||
|
||||
errors.Is(err, io.ErrUnexpectedEOF) ||
|
||||
errors.As(err, &rquorum) ||
|
||||
errors.As(err, &wquorum) ||
|
||||
isErrBucketNotFound(err) ||
|
||||
@@ -473,8 +475,7 @@ func serverMain(ctx *cli.Context) {
|
||||
}
|
||||
|
||||
if !globalActiveCred.IsValid() && globalIsDistErasure {
|
||||
logger.Fatal(config.ErrEnvCredentialsMissingDistributed(nil),
|
||||
"Unable to initialize the server in distributed mode")
|
||||
globalActiveCred = auth.DefaultCredentials
|
||||
}
|
||||
|
||||
// Set system resources to maximum.
|
||||
@@ -544,6 +545,8 @@ func serverMain(ctx *cli.Context) {
|
||||
if errors.Is(err, context.Canceled) {
|
||||
logger.FatalIf(err, "Server startup canceled upon user request")
|
||||
}
|
||||
|
||||
logger.LogIf(GlobalContext, err)
|
||||
}
|
||||
|
||||
if globalIsErasure { // to be done after config init
|
||||
@@ -570,7 +573,7 @@ func serverMain(ctx *cli.Context) {
|
||||
printStartupMessage(getAPIEndpoints(), err)
|
||||
|
||||
if globalActiveCred.Equal(auth.DefaultCredentials) {
|
||||
msg := fmt.Sprintf("Detected default credentials '%s', please change the credentials immediately using 'MINIO_ROOT_USER' and 'MINIO_ROOT_PASSWORD'", globalActiveCred)
|
||||
msg := fmt.Sprintf("Detected default credentials '%s', please change the credentials immediately by setting 'MINIO_ROOT_USER' and 'MINIO_ROOT_PASSWORD' environment values", globalActiveCred)
|
||||
logger.StartupMessage(color.RedBold(msg))
|
||||
}
|
||||
|
||||
|
||||
@@ -43,7 +43,7 @@ type StorageAPI interface {
|
||||
Healing() *healingTracker // Returns nil if disk is not healing.
|
||||
|
||||
DiskInfo(ctx context.Context) (info DiskInfo, err error)
|
||||
NSScanner(ctx context.Context, cache dataUsageCache) (dataUsageCache, error)
|
||||
NSScanner(ctx context.Context, cache dataUsageCache, updates chan<- dataUsageEntry) (dataUsageCache, error)
|
||||
|
||||
// Volume operations.
|
||||
MakeVol(ctx context.Context, volume string) (err error)
|
||||
|
||||
@@ -206,7 +206,8 @@ func (client *storageRESTClient) Healing() *healingTracker {
|
||||
return val.(*healingTracker)
|
||||
}
|
||||
|
||||
func (client *storageRESTClient) NSScanner(ctx context.Context, cache dataUsageCache) (dataUsageCache, error) {
|
||||
func (client *storageRESTClient) NSScanner(ctx context.Context, cache dataUsageCache, updates chan<- dataUsageEntry) (dataUsageCache, error) {
|
||||
defer close(updates)
|
||||
pr, pw := io.Pipe()
|
||||
go func() {
|
||||
pw.CloseWithError(cache.serializeTo(pw))
|
||||
@@ -218,14 +219,38 @@ func (client *storageRESTClient) NSScanner(ctx context.Context, cache dataUsageC
|
||||
return cache, err
|
||||
}
|
||||
|
||||
var newCache dataUsageCache
|
||||
pr, pw = io.Pipe()
|
||||
rr, rw := io.Pipe()
|
||||
go func() {
|
||||
pw.CloseWithError(waitForHTTPStream(respBody, pw))
|
||||
rw.CloseWithError(waitForHTTPStream(respBody, rw))
|
||||
}()
|
||||
err = newCache.deserialize(pr)
|
||||
pr.CloseWithError(err)
|
||||
return newCache, err
|
||||
|
||||
ms := msgp.NewReader(rr)
|
||||
for {
|
||||
// Read whether it is an update.
|
||||
upd, err := ms.ReadBool()
|
||||
if err != nil {
|
||||
rr.CloseWithError(err)
|
||||
return cache, err
|
||||
}
|
||||
if !upd {
|
||||
// No more updates... New cache follows.
|
||||
break
|
||||
}
|
||||
var update dataUsageEntry
|
||||
err = update.DecodeMsg(ms)
|
||||
if err != nil || err == io.EOF {
|
||||
rr.CloseWithError(err)
|
||||
return cache, err
|
||||
}
|
||||
updates <- update
|
||||
}
|
||||
var newCache dataUsageCache
|
||||
err = newCache.DecodeMsg(ms)
|
||||
rr.CloseWithError(err)
|
||||
if err == io.EOF {
|
||||
err = nil
|
||||
}
|
||||
return cache, err
|
||||
}
|
||||
|
||||
func (client *storageRESTClient) GetDiskID() (string, error) {
|
||||
|
||||
@@ -18,7 +18,7 @@
|
||||
package cmd
|
||||
|
||||
const (
|
||||
storageRESTVersion = "v33" // Added transition related information to FileInfo
|
||||
storageRESTVersion = "v34" // Streaming Usage Updates
|
||||
storageRESTVersionPrefix = SlashSeparator + storageRESTVersion
|
||||
storageRESTPrefix = minioReservedBucketPath + "/storage"
|
||||
)
|
||||
|
||||
+76
-18
@@ -19,6 +19,7 @@ package cmd
|
||||
|
||||
import (
|
||||
"bufio"
|
||||
"context"
|
||||
"encoding/binary"
|
||||
"encoding/gob"
|
||||
"encoding/hex"
|
||||
@@ -31,6 +32,7 @@ import (
|
||||
"path"
|
||||
"strconv"
|
||||
"strings"
|
||||
"sync"
|
||||
"time"
|
||||
|
||||
"github.com/tinylib/msgp/msgp"
|
||||
@@ -173,13 +175,43 @@ func (s *storageRESTServer) NSScannerHandler(w http.ResponseWriter, r *http.Requ
|
||||
return
|
||||
}
|
||||
|
||||
ctx, cancel := context.WithCancel(r.Context())
|
||||
defer cancel()
|
||||
resp := streamHTTPResponse(w)
|
||||
usageInfo, err := s.storage.NSScanner(r.Context(), cache)
|
||||
respW := msgp.NewWriter(resp)
|
||||
|
||||
// Collect updates, stream them before the full cache is sent.
|
||||
updates := make(chan dataUsageEntry, 1)
|
||||
var wg sync.WaitGroup
|
||||
wg.Add(1)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
for update := range updates {
|
||||
// Write true bool to indicate update.
|
||||
if err = respW.WriteBool(true); err == nil {
|
||||
err = update.EncodeMsg(respW)
|
||||
}
|
||||
respW.Flush()
|
||||
if err != nil {
|
||||
cancel()
|
||||
resp.CloseWithError(err)
|
||||
return
|
||||
}
|
||||
}
|
||||
}()
|
||||
usageInfo, err := s.storage.NSScanner(ctx, cache, updates)
|
||||
if err != nil {
|
||||
respW.Flush()
|
||||
resp.CloseWithError(err)
|
||||
return
|
||||
}
|
||||
resp.CloseWithError(usageInfo.serializeTo(resp))
|
||||
|
||||
// Write false bool to indicate we finished.
|
||||
wg.Wait()
|
||||
if err = respW.WriteBool(false); err == nil {
|
||||
err = usageInfo.EncodeMsg(respW)
|
||||
}
|
||||
resp.CloseWithError(respW.Flush())
|
||||
}
|
||||
|
||||
// MakeVolHandler - make a volume.
|
||||
@@ -941,9 +973,10 @@ func (s *storageRESTServer) VerifyFileHandler(w http.ResponseWriter, r *http.Req
|
||||
// now, need to revist the overall erroring structure here.
|
||||
// Do not like it :-(
|
||||
func logFatalErrs(err error, endpoint Endpoint, exit bool) {
|
||||
if errors.Is(err, errMinDiskSize) {
|
||||
switch {
|
||||
case errors.Is(err, errMinDiskSize):
|
||||
logger.Fatal(config.ErrUnableToWriteInBackend(err).Hint(err.Error()), "Unable to initialize backend")
|
||||
} else if errors.Is(err, errUnsupportedDisk) {
|
||||
case errors.Is(err, errUnsupportedDisk):
|
||||
var hint string
|
||||
if endpoint.URL != nil {
|
||||
hint = fmt.Sprintf("Disk '%s' does not support O_DIRECT flags, MinIO erasure coding requires filesystems with O_DIRECT support", endpoint.Path)
|
||||
@@ -951,7 +984,7 @@ func logFatalErrs(err error, endpoint Endpoint, exit bool) {
|
||||
hint = "Disks do not support O_DIRECT flags, MinIO erasure coding requires filesystems with O_DIRECT support"
|
||||
}
|
||||
logger.Fatal(config.ErrUnsupportedBackend(err).Hint(hint), "Unable to initialize backend")
|
||||
} else if errors.Is(err, errDiskNotDir) {
|
||||
case errors.Is(err, errDiskNotDir):
|
||||
var hint string
|
||||
if endpoint.URL != nil {
|
||||
hint = fmt.Sprintf("Disk '%s' is not a directory, MinIO erasure coding needs a directory", endpoint.Path)
|
||||
@@ -959,7 +992,7 @@ func logFatalErrs(err error, endpoint Endpoint, exit bool) {
|
||||
hint = "Disks are not directories, MinIO erasure coding needs directories"
|
||||
}
|
||||
logger.Fatal(config.ErrUnableToWriteInBackend(err).Hint(hint), "Unable to initialize backend")
|
||||
} else if errors.Is(err, errFileAccessDenied) {
|
||||
case errors.Is(err, errFileAccessDenied):
|
||||
// Show a descriptive error with a hint about how to fix it.
|
||||
var username string
|
||||
if u, err := user.Current(); err == nil {
|
||||
@@ -974,22 +1007,26 @@ func logFatalErrs(err error, endpoint Endpoint, exit bool) {
|
||||
} else {
|
||||
hint = fmt.Sprintf("Run the following command to add write permissions: `sudo chown -R %s. <path> && sudo chmod u+rxw <path>`", username)
|
||||
}
|
||||
logger.Fatal(config.ErrUnableToWriteInBackend(err).Hint(hint), "Unable to initialize backend")
|
||||
} else if errors.Is(err, errFaultyDisk) {
|
||||
if !exit {
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("disk is not writable %s, %s", endpoint, hint))
|
||||
} else {
|
||||
logger.Fatal(config.ErrUnableToWriteInBackend(err).Hint(hint), "Unable to initialize backend")
|
||||
}
|
||||
case errors.Is(err, errFaultyDisk):
|
||||
if !exit {
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("disk is faulty at %s, please replace the drive - disk will be offline", endpoint))
|
||||
} else {
|
||||
logger.Fatal(err, "Unable to initialize backend")
|
||||
}
|
||||
} else if errors.Is(err, errDiskFull) {
|
||||
case errors.Is(err, errDiskFull):
|
||||
if !exit {
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("disk is already full at %s, incoming I/O will fail - disk will be offline", endpoint))
|
||||
} else {
|
||||
logger.Fatal(err, "Unable to initialize backend")
|
||||
}
|
||||
} else {
|
||||
default:
|
||||
if !exit {
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("disk returned an unexpected error at %s, please investigate - disk will be offline", endpoint))
|
||||
logger.LogIf(GlobalContext, fmt.Errorf("disk returned an unexpected error at %s, please investigate - disk will be offline (%w)", endpoint, err))
|
||||
} else {
|
||||
logger.Fatal(err, "Unable to initialize backend")
|
||||
}
|
||||
@@ -998,18 +1035,39 @@ func logFatalErrs(err error, endpoint Endpoint, exit bool) {
|
||||
|
||||
// registerStorageRPCRouter - register storage rpc router.
|
||||
func registerStorageRESTHandlers(router *mux.Router, endpointServerPools EndpointServerPools) {
|
||||
for _, ep := range endpointServerPools {
|
||||
for _, endpoint := range ep.Endpoints {
|
||||
storageDisks := make([][]*xlStorage, len(endpointServerPools))
|
||||
for poolIdx, ep := range endpointServerPools {
|
||||
storageDisks[poolIdx] = make([]*xlStorage, len(ep.Endpoints))
|
||||
}
|
||||
var wg sync.WaitGroup
|
||||
for poolIdx, ep := range endpointServerPools {
|
||||
for setIdx, endpoint := range ep.Endpoints {
|
||||
if !endpoint.IsLocal {
|
||||
continue
|
||||
}
|
||||
storage, err := newXLStorage(endpoint)
|
||||
if err != nil {
|
||||
// if supported errors don't fail, we proceed to
|
||||
// printing message and moving forward.
|
||||
logFatalErrs(err, endpoint, false)
|
||||
wg.Add(1)
|
||||
go func(poolIdx, setIdx int, endpoint Endpoint) {
|
||||
defer wg.Done()
|
||||
var err error
|
||||
storageDisks[poolIdx][setIdx], err = newXLStorage(endpoint)
|
||||
if err != nil {
|
||||
// if supported errors don't fail, we proceed to
|
||||
// printing message and moving forward.
|
||||
logFatalErrs(err, endpoint, false)
|
||||
}
|
||||
}(poolIdx, setIdx, endpoint)
|
||||
}
|
||||
}
|
||||
wg.Wait()
|
||||
|
||||
for _, setDisks := range storageDisks {
|
||||
for _, storage := range setDisks {
|
||||
if storage == nil {
|
||||
continue
|
||||
}
|
||||
|
||||
endpoint := storage.Endpoint()
|
||||
|
||||
server := &storageRESTServer{storage: storage}
|
||||
|
||||
subrouter := router.PathPrefix(path.Join(storageRESTPrefix, endpoint.Path)).Subrouter()
|
||||
|
||||
+3
-4
@@ -1201,10 +1201,8 @@ func (web *webAPIHandlers) Upload(w http.ResponseWriter, r *http.Request) {
|
||||
}
|
||||
|
||||
// Check if bucket encryption is enabled
|
||||
_, err = globalBucketSSEConfigSys.Get(bucket)
|
||||
if (globalAutoEncryption || err == nil) && !crypto.SSEC.IsRequested(r.Header) {
|
||||
r.Header.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
}
|
||||
sseConfig, _ := globalBucketSSEConfigSys.Get(bucket)
|
||||
sseConfig.Apply(r.Header, globalAutoEncryption)
|
||||
|
||||
// Require Content-Length to be set in the request
|
||||
size := r.ContentLength
|
||||
@@ -1501,6 +1499,7 @@ func (web *webAPIHandlers) Download(w http.ResponseWriter, r *http.Request) {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
case crypto.S3KMS:
|
||||
w.Header().Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsID, objInfo.UserDefined[crypto.MetaKeyID])
|
||||
if kmsCtx, ok := objInfo.UserDefined[crypto.MetaContext]; ok {
|
||||
w.Header().Set(xhttp.AmzServerSideEncryptionKmsContext, kmsCtx)
|
||||
}
|
||||
|
||||
@@ -25,7 +25,7 @@ import (
|
||||
"sync/atomic"
|
||||
"time"
|
||||
|
||||
ewma "github.com/VividCortex/ewma"
|
||||
"github.com/VividCortex/ewma"
|
||||
"github.com/minio/madmin-go"
|
||||
)
|
||||
|
||||
@@ -158,7 +158,7 @@ func (p *xlStorageDiskIDCheck) Healing() *healingTracker {
|
||||
return p.storage.Healing()
|
||||
}
|
||||
|
||||
func (p *xlStorageDiskIDCheck) NSScanner(ctx context.Context, cache dataUsageCache) (dataUsageCache, error) {
|
||||
func (p *xlStorageDiskIDCheck) NSScanner(ctx context.Context, cache dataUsageCache, updates chan<- dataUsageEntry) (dataUsageCache, error) {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
return dataUsageCache{}, ctx.Err()
|
||||
@@ -168,7 +168,7 @@ func (p *xlStorageDiskIDCheck) NSScanner(ctx context.Context, cache dataUsageCac
|
||||
if err := p.checkDiskStale(); err != nil {
|
||||
return dataUsageCache{}, err
|
||||
}
|
||||
return p.storage.NSScanner(ctx, cache)
|
||||
return p.storage.NSScanner(ctx, cache, updates)
|
||||
}
|
||||
|
||||
func (p *xlStorageDiskIDCheck) GetDiskLoc() (poolIdx, setIdx, diskIdx int) {
|
||||
|
||||
@@ -22,6 +22,7 @@ import (
|
||||
"encoding/binary"
|
||||
"errors"
|
||||
"fmt"
|
||||
"io"
|
||||
"sort"
|
||||
"strings"
|
||||
"time"
|
||||
@@ -1368,3 +1369,93 @@ func (z xlMetaV2) ToFileInfo(volume, path, versionID string) (fi FileInfo, err e
|
||||
|
||||
return FileInfo{}, errFileVersionNotFound
|
||||
}
|
||||
|
||||
// readXLMetaNoData will load the metadata, but skip data segments.
|
||||
// This should only be used when data is never interesting.
|
||||
// If data is not xlv2, it is returned in full.
|
||||
func readXLMetaNoData(r io.Reader, size int64) ([]byte, error) {
|
||||
// Read at most this much on initial read.
|
||||
const readDefault = 4 << 10
|
||||
initial := size
|
||||
hasFull := true
|
||||
if initial > readDefault {
|
||||
initial = readDefault
|
||||
hasFull = false
|
||||
}
|
||||
|
||||
buf := make([]byte, initial)
|
||||
_, err := io.ReadFull(r, buf)
|
||||
if err != nil {
|
||||
return nil, fmt.Errorf("readXLMetaNoData.ReadFull: %w", err)
|
||||
}
|
||||
readMore := func(n int64) error {
|
||||
has := int64(len(buf))
|
||||
if has >= n {
|
||||
return nil
|
||||
}
|
||||
if hasFull || n > size {
|
||||
return io.ErrUnexpectedEOF
|
||||
}
|
||||
extra := n - has
|
||||
buf = append(buf, make([]byte, extra)...)
|
||||
_, err := io.ReadFull(r, buf[has:])
|
||||
if err != nil {
|
||||
if err == io.EOF {
|
||||
// Returned if we read nothing.
|
||||
return io.ErrUnexpectedEOF
|
||||
}
|
||||
return fmt.Errorf("readXLMetaNoData.readMore: %w", err)
|
||||
}
|
||||
return nil
|
||||
}
|
||||
tmp, major, minor, err := checkXL2V1(buf)
|
||||
if err != nil {
|
||||
err = readMore(size)
|
||||
return buf, err
|
||||
}
|
||||
switch major {
|
||||
case 1:
|
||||
switch minor {
|
||||
case 0:
|
||||
err = readMore(size)
|
||||
return buf, err
|
||||
case 1, 2:
|
||||
sz, tmp, err := msgp.ReadBytesHeader(tmp)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
want := int64(sz) + int64(len(buf)-len(tmp))
|
||||
|
||||
// v1.1 does not have CRC.
|
||||
if minor < 2 {
|
||||
if err := readMore(want); err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return buf[:want], nil
|
||||
}
|
||||
|
||||
// CRC is variable length, so we need to truncate exactly that.
|
||||
wantMax := want + msgp.Uint32Size
|
||||
if wantMax > size {
|
||||
wantMax = size
|
||||
}
|
||||
if err := readMore(wantMax); err != nil {
|
||||
return nil, err
|
||||
}
|
||||
|
||||
tmp = buf[want:]
|
||||
_, after, err := msgp.ReadUint32Bytes(tmp)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
want += int64(len(tmp) - len(after))
|
||||
|
||||
return buf[:want], err
|
||||
|
||||
default:
|
||||
return nil, errors.New("unknown minor metadata version")
|
||||
}
|
||||
default:
|
||||
return nil, errors.New("unknown major metadata version")
|
||||
}
|
||||
}
|
||||
|
||||
+73
-39
@@ -52,9 +52,10 @@ import (
|
||||
)
|
||||
|
||||
const (
|
||||
nullVersionID = "null"
|
||||
blockSizeLarge = 2 * humanize.MiByte // Default r/w block size for larger objects.
|
||||
blockSizeSmall = 128 * humanize.KiByte // Default r/w block size for smaller objects.
|
||||
nullVersionID = "null"
|
||||
blockSizeSmall = 128 * humanize.KiByte // Default r/w block size for smaller objects.
|
||||
blockSizeLarge = 2 * humanize.MiByte // Default r/w block size for larger objects.
|
||||
blockSizeReallyLarge = 4 * humanize.MiByte // Default write block size for objects per shard >= 64MiB
|
||||
|
||||
// On regular files bigger than this;
|
||||
readAheadSize = 16 << 20
|
||||
@@ -63,6 +64,9 @@ const (
|
||||
// Size of each buffer.
|
||||
readAheadBufSize = 1 << 20
|
||||
|
||||
// Really large streams threshold per shard.
|
||||
reallyLargeFileThreshold = 64 * humanize.MiByte // Optimized for HDDs
|
||||
|
||||
// Small file threshold below which data accompanies metadata from storage layer.
|
||||
smallFileThreshold = 128 * humanize.KiByte // Optimized for NVMe/SSDs
|
||||
// For hardrives it is possible to set this to a lower value to avoid any
|
||||
@@ -94,6 +98,27 @@ func isValidVolname(volname string) bool {
|
||||
return true
|
||||
}
|
||||
|
||||
var (
|
||||
xlPoolReallyLarge = sync.Pool{
|
||||
New: func() interface{} {
|
||||
b := disk.AlignedBlock(blockSizeReallyLarge)
|
||||
return &b
|
||||
},
|
||||
}
|
||||
xlPoolLarge = sync.Pool{
|
||||
New: func() interface{} {
|
||||
b := disk.AlignedBlock(blockSizeLarge)
|
||||
return &b
|
||||
},
|
||||
}
|
||||
xlPoolSmall = sync.Pool{
|
||||
New: func() interface{} {
|
||||
b := disk.AlignedBlock(blockSizeSmall)
|
||||
return &b
|
||||
},
|
||||
}
|
||||
)
|
||||
|
||||
// xlStorage - implements StorageAPI interface.
|
||||
type xlStorage struct {
|
||||
diskPath string
|
||||
@@ -101,9 +126,6 @@ type xlStorage struct {
|
||||
|
||||
globalSync bool
|
||||
|
||||
poolLarge sync.Pool
|
||||
poolSmall sync.Pool
|
||||
|
||||
rootDisk bool
|
||||
|
||||
diskID string
|
||||
@@ -179,7 +201,7 @@ func getValidPath(path string) (string, error) {
|
||||
}
|
||||
if osIsNotExist(err) {
|
||||
// Disk not found create it.
|
||||
if err = reliableMkdirAll(path, 0777); err != nil {
|
||||
if err = mkdirAll(path, 0777); err != nil {
|
||||
return path, err
|
||||
}
|
||||
}
|
||||
@@ -249,20 +271,8 @@ func newXLStorage(ep Endpoint) (*xlStorage, error) {
|
||||
}
|
||||
|
||||
p := &xlStorage{
|
||||
diskPath: path,
|
||||
endpoint: ep,
|
||||
poolLarge: sync.Pool{
|
||||
New: func() interface{} {
|
||||
b := disk.AlignedBlock(blockSizeLarge)
|
||||
return &b
|
||||
},
|
||||
},
|
||||
poolSmall: sync.Pool{
|
||||
New: func() interface{} {
|
||||
b := disk.AlignedBlock(blockSizeSmall)
|
||||
return &b
|
||||
},
|
||||
},
|
||||
diskPath: path,
|
||||
endpoint: ep,
|
||||
globalSync: env.Get(config.EnvFSOSync, config.EnableOff) == config.EnableOn,
|
||||
ctx: GlobalContext,
|
||||
rootDisk: rootDisk,
|
||||
@@ -281,7 +291,7 @@ func newXLStorage(ep Endpoint) (*xlStorage, error) {
|
||||
_, _ = rand.Read(rnd[:])
|
||||
tmpFile := ".writable-check-" + hex.EncodeToString(rnd[:]) + ".tmp"
|
||||
filePath := pathJoin(p.diskPath, minioMetaTmpBucket, tmpFile)
|
||||
w, err := disk.OpenFileDirectIO(filePath, os.O_CREATE|os.O_WRONLY|os.O_EXCL, 0666)
|
||||
w, err := OpenFileDirectIO(filePath, os.O_CREATE|os.O_WRONLY|os.O_EXCL, 0666)
|
||||
if err != nil {
|
||||
return p, err
|
||||
}
|
||||
@@ -374,7 +384,22 @@ func (s *xlStorage) Healing() *healingTracker {
|
||||
return &h
|
||||
}
|
||||
|
||||
func (s *xlStorage) NSScanner(ctx context.Context, cache dataUsageCache) (dataUsageCache, error) {
|
||||
func (s *xlStorage) readMetadata(itemPath string) ([]byte, error) {
|
||||
f, err := os.OpenFile(itemPath, readMode, 0)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
defer f.Close()
|
||||
stat, err := f.Stat()
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return readXLMetaNoData(f, stat.Size())
|
||||
}
|
||||
|
||||
func (s *xlStorage) NSScanner(ctx context.Context, cache dataUsageCache, updates chan<- dataUsageEntry) (dataUsageCache, error) {
|
||||
// Updates must be closed before we return.
|
||||
defer close(updates)
|
||||
var lc *lifecycle.Lifecycle
|
||||
var err error
|
||||
|
||||
@@ -399,6 +424,7 @@ func (s *xlStorage) NSScanner(ctx context.Context, cache dataUsageCache) (dataUs
|
||||
globalHealConfigMu.Lock()
|
||||
healOpts := globalHealConfig
|
||||
globalHealConfigMu.Unlock()
|
||||
cache.Info.updates = updates
|
||||
|
||||
dataUsageInfo, err := scanDataFolder(ctx, s.diskPath, cache, func(item scannerItem) (sizeSummary, error) {
|
||||
// Look for `xl.meta/xl.json' at the leaf.
|
||||
@@ -408,7 +434,7 @@ func (s *xlStorage) NSScanner(ctx context.Context, cache dataUsageCache) (dataUs
|
||||
return sizeSummary{}, errSkipFile
|
||||
}
|
||||
|
||||
buf, err := xioutil.ReadFile(item.Path)
|
||||
buf, err := s.readMetadata(item.Path)
|
||||
if err != nil {
|
||||
if intDataUpdateTracker.debug {
|
||||
console.Debugf(color.Green("scannerBucket:")+" object path missing: %v: %w\n", item.Path, err)
|
||||
@@ -427,17 +453,18 @@ func (s *xlStorage) NSScanner(ctx context.Context, cache dataUsageCache) (dataUs
|
||||
return sizeSummary{}, errSkipFile
|
||||
}
|
||||
|
||||
var totalSize int64
|
||||
|
||||
sizeS := sizeSummary{}
|
||||
for _, version := range fivs.Versions {
|
||||
oi := version.ToObjectInfo(item.bucket, item.objectPath())
|
||||
totalSize += item.applyActions(ctx, objAPI, actionMeta{
|
||||
sz := item.applyActions(ctx, objAPI, actionMeta{
|
||||
oi: oi,
|
||||
bitRotScan: healOpts.Bitrot,
|
||||
}, &sizeS)
|
||||
if !oi.DeleteMarker && sz == oi.Size {
|
||||
sizeS.versions++
|
||||
}
|
||||
sizeS.totalSize += sz
|
||||
}
|
||||
sizeS.totalSize = totalSize
|
||||
return sizeS, nil
|
||||
})
|
||||
|
||||
@@ -627,7 +654,7 @@ func (s *xlStorage) MakeVol(ctx context.Context, volume string) error {
|
||||
// Volume does not exist we proceed to create.
|
||||
if osIsNotExist(err) {
|
||||
// Make a volume entry, with mode 0777 mkdir honors system umask.
|
||||
err = reliableMkdirAll(volumeDir, 0777)
|
||||
err = mkdirAll(volumeDir, 0777)
|
||||
}
|
||||
if osIsPermission(err) {
|
||||
return errDiskAccessDenied
|
||||
@@ -1093,7 +1120,7 @@ func (s *xlStorage) readAllData(volumeDir string, filePath string, requireDirect
|
||||
var r io.ReadCloser
|
||||
if requireDirectIO {
|
||||
var f *os.File
|
||||
f, err = disk.OpenFileDirectIO(filePath, readMode, 0666)
|
||||
f, err = OpenFileDirectIO(filePath, readMode, 0666)
|
||||
r = &odirectReader{f, nil, nil, true, true, s, nil}
|
||||
} else {
|
||||
r, err = OpenFile(filePath, readMode, 0)
|
||||
@@ -1311,9 +1338,9 @@ func (o *odirectReader) Read(buf []byte) (n int, err error) {
|
||||
}
|
||||
if o.buf == nil {
|
||||
if o.smallFile {
|
||||
o.bufp = o.s.poolSmall.Get().(*[]byte)
|
||||
o.bufp = xlPoolSmall.Get().(*[]byte)
|
||||
} else {
|
||||
o.bufp = o.s.poolLarge.Get().(*[]byte)
|
||||
o.bufp = xlPoolLarge.Get().(*[]byte)
|
||||
}
|
||||
}
|
||||
if o.freshRead {
|
||||
@@ -1355,9 +1382,9 @@ func (o *odirectReader) Read(buf []byte) (n int, err error) {
|
||||
// Close - Release the buffer and close the file.
|
||||
func (o *odirectReader) Close() error {
|
||||
if o.smallFile {
|
||||
o.s.poolSmall.Put(o.bufp)
|
||||
xlPoolSmall.Put(o.bufp)
|
||||
} else {
|
||||
o.s.poolLarge.Put(o.bufp)
|
||||
xlPoolLarge.Put(o.bufp)
|
||||
}
|
||||
return o.f.Close()
|
||||
}
|
||||
@@ -1382,7 +1409,7 @@ func (s *xlStorage) ReadFileStream(ctx context.Context, volume, path string, off
|
||||
var file *os.File
|
||||
// O_DIRECT only supported if offset is zero
|
||||
if offset == 0 && globalStorageClass.GetDMA() == storageclass.DMAReadWrite {
|
||||
file, err = disk.OpenFileDirectIO(filePath, readMode, 0666)
|
||||
file, err = OpenFileDirectIO(filePath, readMode, 0666)
|
||||
} else {
|
||||
// Open the file for reading.
|
||||
file, err = OpenFile(filePath, readMode, 0666)
|
||||
@@ -1503,7 +1530,7 @@ func (s *xlStorage) CreateFile(ctx context.Context, volume, path string, fileSiz
|
||||
if fileSize >= 0 && fileSize <= smallFileThreshold {
|
||||
// For streams smaller than 128KiB we simply write them as O_DSYNC (fdatasync)
|
||||
// and not O_DIRECT to avoid the complexities of aligned I/O.
|
||||
w, err := s.openFile(filePath, os.O_CREATE|os.O_WRONLY|os.O_TRUNC)
|
||||
w, err := s.openFile(filePath, os.O_CREATE|os.O_WRONLY|os.O_EXCL)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
@@ -1539,8 +1566,15 @@ func (s *xlStorage) CreateFile(ctx context.Context, volume, path string, fileSiz
|
||||
w.Close()
|
||||
}()
|
||||
|
||||
bufp := s.poolLarge.Get().(*[]byte)
|
||||
defer s.poolLarge.Put(bufp)
|
||||
var bufp *[]byte
|
||||
if fileSize > 0 && fileSize >= reallyLargeFileThreshold {
|
||||
// use a larger 4MiB buffer for really large streams.
|
||||
bufp = xlPoolReallyLarge.Get().(*[]byte)
|
||||
defer xlPoolReallyLarge.Put(bufp)
|
||||
} else {
|
||||
bufp = xlPoolLarge.Get().(*[]byte)
|
||||
defer xlPoolLarge.Put(bufp)
|
||||
}
|
||||
|
||||
written, err := xioutil.CopyAligned(w, r, *bufp, fileSize)
|
||||
if err != nil {
|
||||
@@ -1983,7 +2017,7 @@ func (s *xlStorage) RenameData(ctx context.Context, srcVolume, srcPath string, f
|
||||
|
||||
legacyDataPath := pathJoin(dstVolumeDir, dstPath, legacyDataDir)
|
||||
// legacy data dir means its old content, honor system umask.
|
||||
if err = reliableMkdirAll(legacyDataPath, 0777); err != nil {
|
||||
if err = mkdirAll(legacyDataPath, 0777); err != nil {
|
||||
return osErrToFileErr(err)
|
||||
}
|
||||
|
||||
|
||||
@@ -1787,7 +1787,7 @@ func TestXLStorageVerifyFile(t *testing.T) {
|
||||
algo = HighwayHash256S
|
||||
shardSize := int64(1024 * 1024)
|
||||
shard := make([]byte, shardSize)
|
||||
w := newStreamingBitrotWriter(storage, volName, fileName, size, algo, shardSize, false)
|
||||
w := newStreamingBitrotWriter(storage, volName, fileName, size, algo, shardSize)
|
||||
reader := bytes.NewReader(data)
|
||||
for {
|
||||
// Using io.Copy instead of this loop will not work for us as io.Copy
|
||||
|
||||
@@ -1,6 +1,6 @@
|
||||
# ILM Tiering Design [](https://slack.min.io) [](https://hub.docker.com/r/minio/minio/)
|
||||
|
||||
Lifecycle transition functionality provided in [bucket lifecycle guide]https://raw.githubusercontent.com/minio/minio/master/docs/bucket/lifecycle/README.md) allows tiering of content from MinIO object store to public clouds or other MinIO clusters ( possibly running on HDD drives).
|
||||
Lifecycle transition functionality provided in [bucket lifecycle guide](https://github.com/minio/minio/master/docs/bucket/lifecycle/README.md) allows tiering of content from MinIO object store to public clouds or other MinIO clusters.
|
||||
|
||||
Transition tiers can be added to MinIO using `mc admin tier add` command to associate a `gcs`, `s3` or `azure` bucket or prefix path on a bucket to the tier name.
|
||||
Lifecycle transition rules can be applied to buckets (both versioned and un-versioned) by specifying the tier name defined above as the transition storage class for the lifecycle rule.
|
||||
@@ -27,7 +27,7 @@ When a transitioned object is restored temporarily to local MinIO instance via P
|
||||
"X-Amz-Restore-Expiry-Days": "4",
|
||||
"X-Amz-Restore-Request-Date": "Mon, 22 Feb 2021 21:10:09 GMT",
|
||||
"x-amz-restore": "ongoing-request=false, expiry-date=Sat, 27 Feb 2021 00:00:00 GMT",
|
||||
...
|
||||
...
|
||||
```
|
||||
### Encrypted/Object locked objects
|
||||
For objects under SSE-S3 or SSE-C encryption, the encrypted content from MinIO cluster is copied as is to the remote tier without any decryption. The content is decrypted as it is streamed from remote tier on `GET/HEAD`. Objects under retention are protected because the metadata present on MinIO server ensures that the object (version) is not deleted until retention period is over. Administrators need to ensure that the remote tier bucket is under proper access control.
|
||||
|
||||
@@ -16,7 +16,7 @@ If synchronous replication is configured above, replication is attempted right a
|
||||
|
||||
Any metadata changes on the source object version, such as metadata updates via PutObjectTagging, PutObjectRetention, PutObjectLegalHold and COPY api are replicated in a similar manner to target version, with the `X-Amz-Replication-Status` again cycling through the same states.
|
||||
|
||||
The description above details one way replication from source to target w.r.t incoming object uploads and metadata changes to source object version. If active-active replication is configured, any incoming uploads and metadata changes to versions created on the target, will sync back to the source and be marked as `REPLICA` on the source. AWS, as well as MinIO do not by default sync metadata changes on a object version marked `REPLICA` back to source. This requires a setting in the replication configuration called [replica modification sync](https://aws.amazon.com/about-aws/whats-new/2020/12/amazon-s3-replication-adds-support-two-way-replication/) which is not yet available in MinIO.
|
||||
The description above details one way replication from source to target w.r.t incoming object uploads and metadata changes to source object version. If active-active replication is configured, any incoming uploads and metadata changes to versions created on the target, will sync back to the source and be marked as `REPLICA` on the source. AWS, as well as MinIO do not by default sync metadata changes on a object version marked `REPLICA` back to source. This requires a setting in the replication configuration called [replica modification sync](https://aws.amazon.com/about-aws/whats-new/2020/12/amazon-s3-replication-adds-support-two-way-replication/).
|
||||
|
||||
For active-active replication, automatic failover occurs on `GET/HEAD` operations if object or object version requested qualifies for replication and is missing on one site, but present on the other. This allows the applications to take full advantage of two-way replication even before the two sites get fully synced.
|
||||
|
||||
|
||||
@@ -132,6 +132,11 @@ The replication configuration can now be added to the source bucket by applying
|
||||
"Destination": {
|
||||
"Bucket": "arn:aws:s3:::destbucket",
|
||||
"StorageClass": "STANDARD"
|
||||
},
|
||||
"SourceSelectionCriteria": {
|
||||
"ReplicaModifications": {
|
||||
"Status": "Enabled"
|
||||
}
|
||||
}
|
||||
}
|
||||
]
|
||||
@@ -150,6 +155,19 @@ To perform bi-directional replication, repeat the above process on the target si
|
||||
|
||||
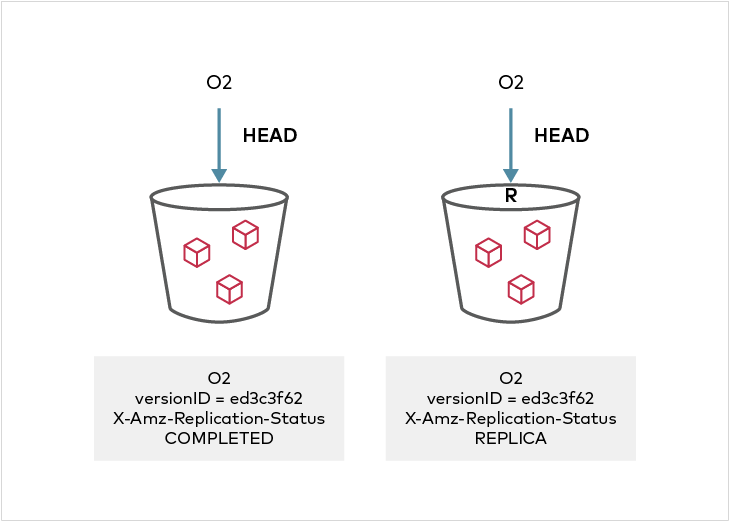
|
||||
|
||||
## Replica Modification sync
|
||||
If bi-directional replication is set up between two clusters, any metadata update on the REPLICA object is by default reflected back in the source object when `ReplicaModifications` status in the `SourceSelectionCriteria` is `Enabled`. In MinIO, this is enabled by default. If a metadata update is performed on the "REPLICA" object, its `X-Amz-Replication-Status` will change from `PENDING` to `COMPLETE` or `FAILED`, and the source object version will show `X-Amz-Replication-Status` of `REPLICA` once the replication operation is complete.
|
||||
|
||||
The replication configuration in use on a bucket can be viewed using the `mc replicate export alias/bucket` command.
|
||||
|
||||
To disable replica metadata modification syncing, use `mc replicate edit` with the --replicate flag.
|
||||
```
|
||||
$ mc replicate edit alias/bucket --id xyz.id --replicate "delete,delete-marker"
|
||||
```
|
||||
To re-enable replica metadata modification syncing,
|
||||
```
|
||||
$ mc replicate edit alias/bucket --id xyz.id --replicate "delete,delete-marker,replica-metadata-sync"
|
||||
```
|
||||
## MinIO Extension
|
||||
### Replicating Deletes
|
||||
|
||||
@@ -185,6 +203,6 @@ remote replication target using the `mc admin bucket remote add` command
|
||||
```
|
||||
|
||||
## Explore Further
|
||||
- [MinIO Bucket Replication Design](https://raw.githubusercontent.com/minio/minio/master/docs/bucket/replication/DESIGN.md)
|
||||
- [MinIO Bucket Replication Design](https://github.com/minio/minio/blob/master/docs/bucket/replication/DESIGN.md)
|
||||
- [MinIO Bucket Versioning Implementation](https://docs.minio.io/docs/minio-bucket-versioning-guide.html)
|
||||
- [MinIO Client Quickstart Guide](https://docs.minio.io/docs/minio-client-quickstart-guide.html)
|
||||
|
||||
@@ -1,8 +1,8 @@
|
||||
# Bucket Versioning Guide [](https://slack.min.io) [](https://hub.docker.com/r/minio/minio/)
|
||||
|
||||
MinIO versioning is designed to keep multiple versions of an object in one bucket. For example, you could store `spark.csv` (version `ede336f2`) and `spark.csv` (version `fae684da`) in a single bucket. Versioning protects you from unintended overwrites, deletions, to apply retention policies and archive your objects.
|
||||
MinIO versioning is designed to keep multiple versions of an object in one bucket. For example, you could store `spark.csv` (version `ede336f2`) and `spark.csv` (version `fae684da`) in a single bucket. Versioning protects you from unintended overwrites, deletions, protect objects with retention policies.
|
||||
|
||||
To custom data retention and storage usage, use object versioning with object lifecycle management. If you have an object expiration lifecycle policy in your non-versioned bucket and you want to maintain the same permanent delete behavior when on versioning-enabled bucket, you must add a noncurrent expiration policy. The noncurrent expiration lifecycle policy will manage the deletes of the noncurrent object versions in the versioning-enabled bucket. (A version-enabled bucket maintains one current and zero or more noncurrent object versions.)
|
||||
To control data retention and storage usage, use object versioning with [object lifecycle management](https://github.com/minio/minio/master/docs/bucket/lifecycle/README.md). If you have an object expiration lifecycle policy in your non-versioned bucket and you want to maintain the same permanent delete behavior when on versioning-enabled bucket, you must add a noncurrent expiration policy. The noncurrent expiration lifecycle policy will manage the deletes of the noncurrent object versions in the versioning-enabled bucket. (A version-enabled bucket maintains one current and zero or more noncurrent object versions.)
|
||||
|
||||
Versioning must be explicitly enabled on a bucket, versioning is not enabled by default. Object locking enabled buckets have versioning enabled automatically. Enabling and suspending versioning is done at the bucket level.
|
||||
|
||||
@@ -12,7 +12,7 @@ When you PUT an object in a versioning-enabled bucket, the noncurrent version is
|
||||
|
||||
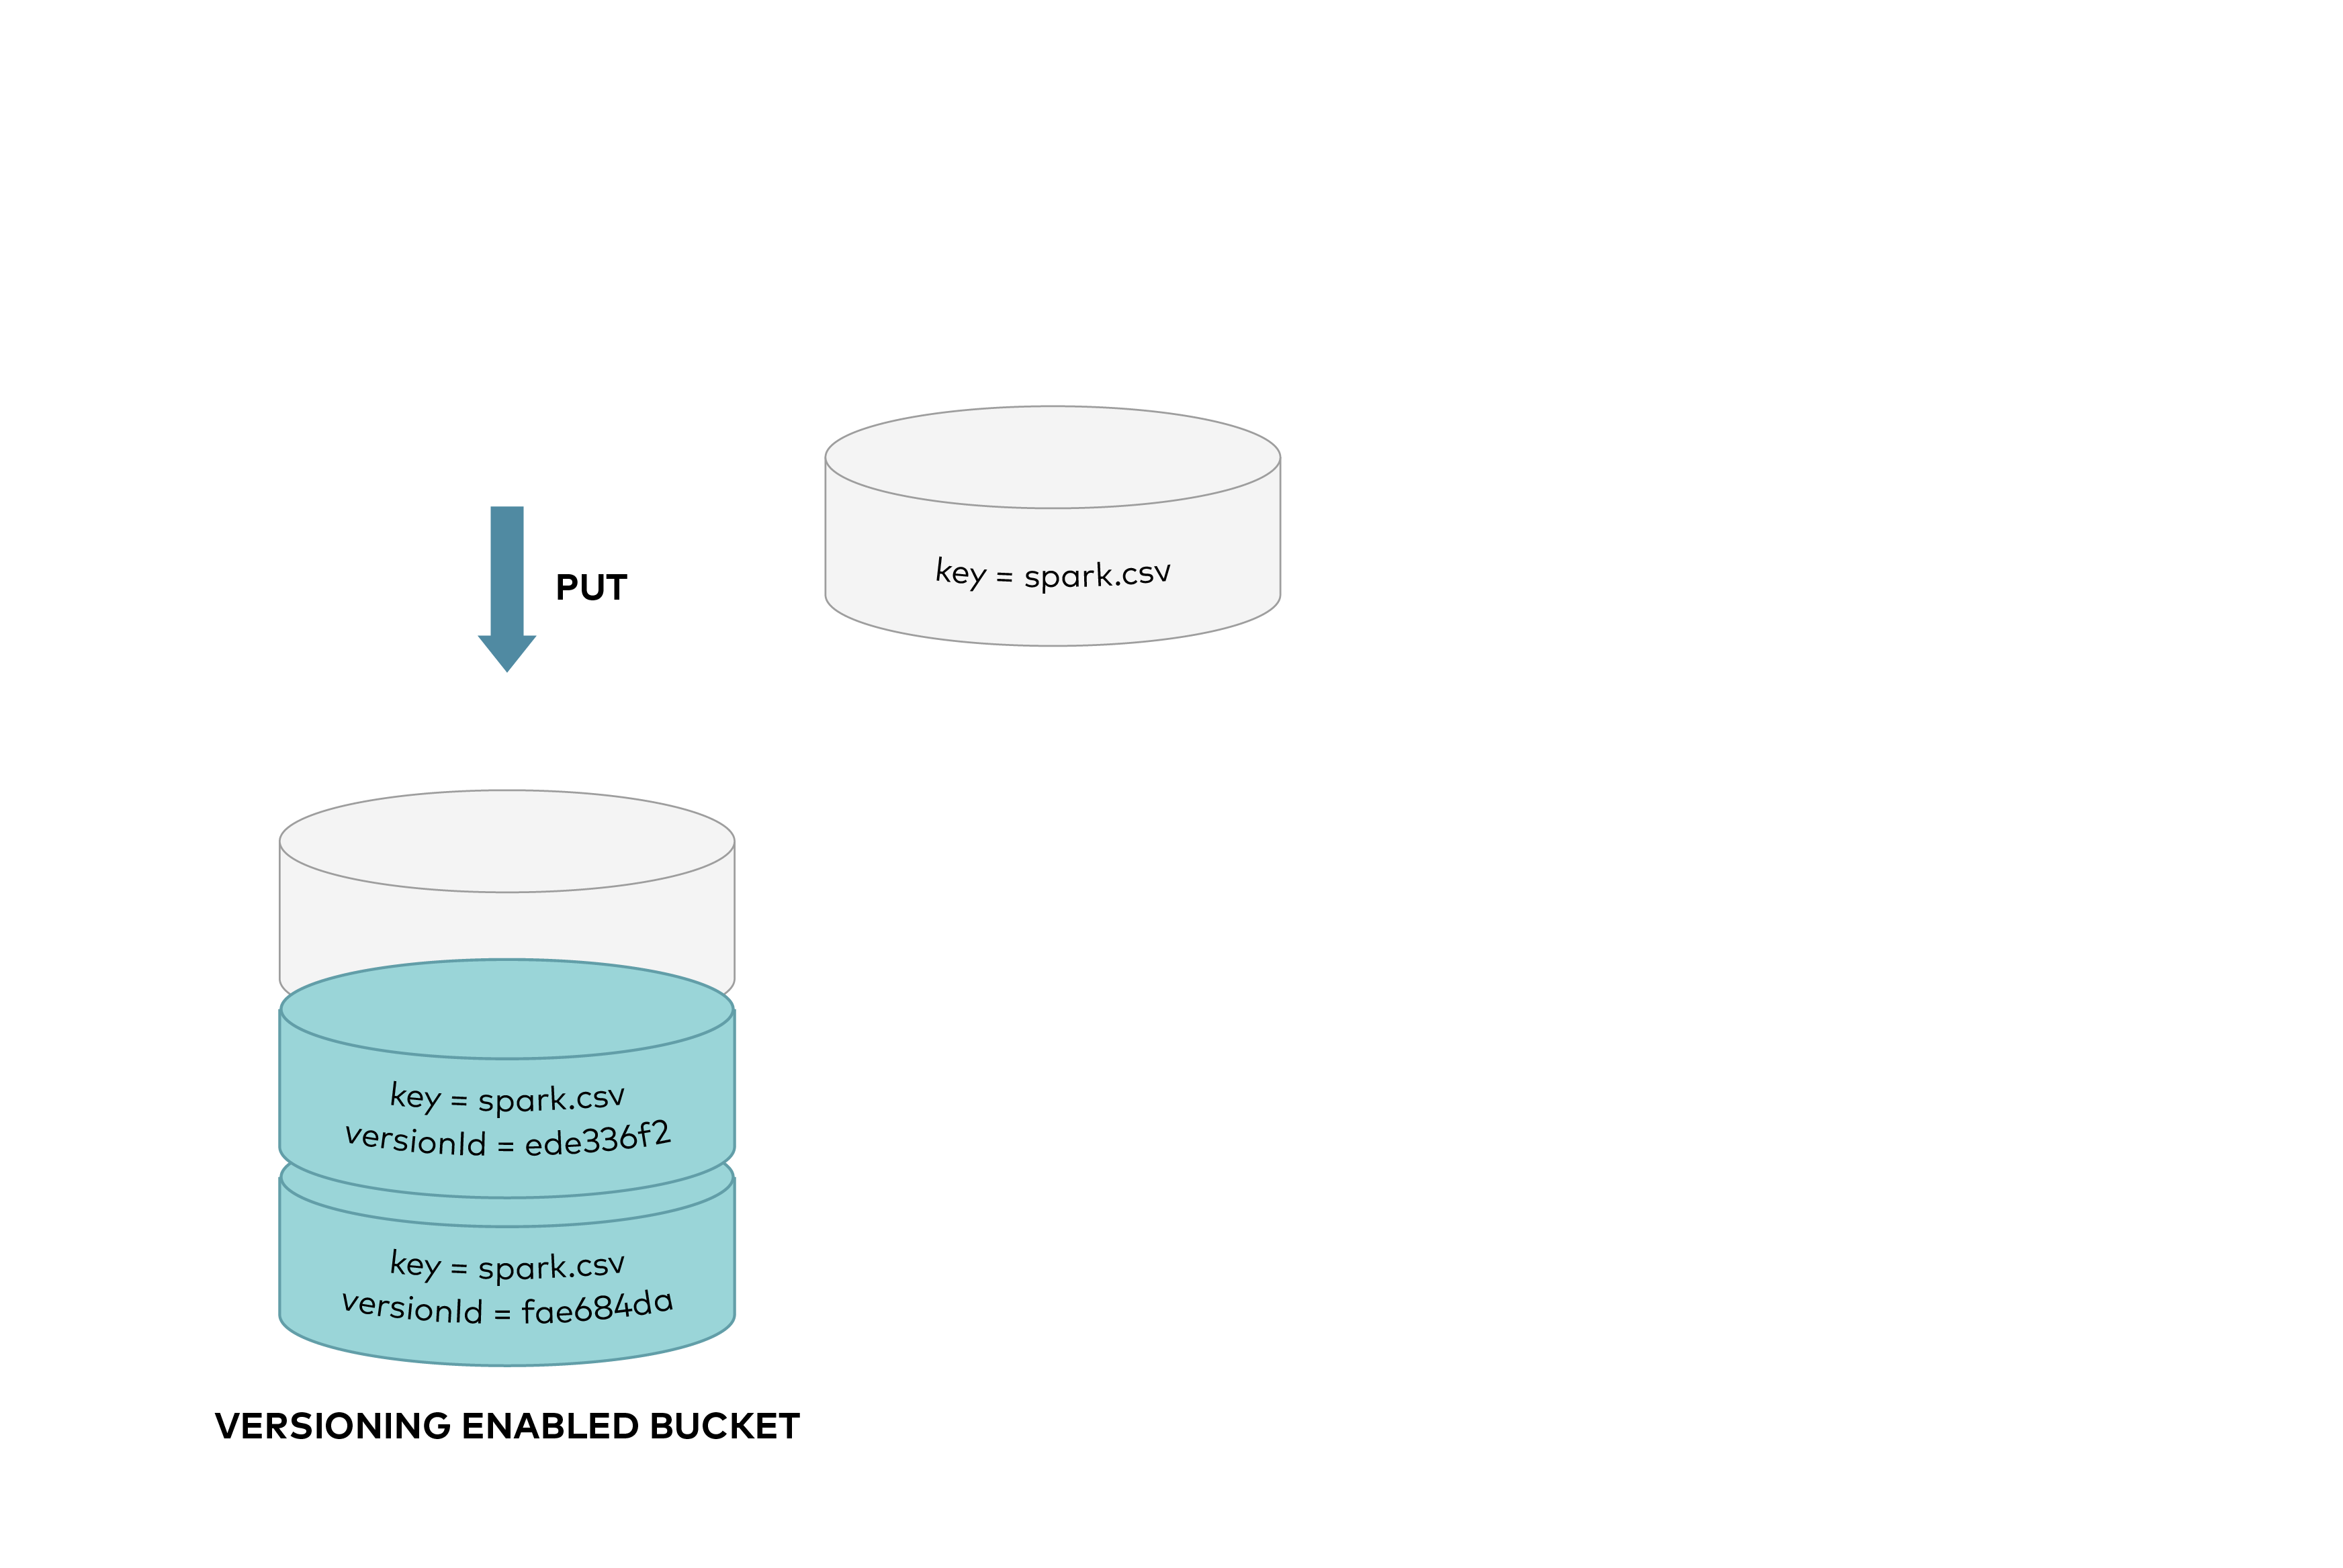
|
||||
|
||||
This means accidental overwrites or deletes of objects are protected, allows previous version of on object to be retrieved.
|
||||
This protects against accidental overwrites or deletes of objects, allows previous versions to be retrieved.
|
||||
|
||||
When you DELETE an object, all versions remain in the bucket and MinIO adds a delete marker, as shown below:
|
||||
|
||||
|
||||
@@ -20,7 +20,9 @@ Refer to sizing guide for more understanding on default values chosen depending
|
||||
|
||||
### Consistency Guarantees
|
||||
|
||||
MinIO follows strict **read-after-write** and **list-after-write** consistency model for all i/o operations both in distributed and standalone modes.
|
||||
MinIO follows strict **read-after-write** and **list-after-write** consistency model for all i/o operations both in distributed and standalone modes. This consistency model is only guaranteed if you use disk filesystems such as xfs, ext4 or zfs etc.. for distributed setup.
|
||||
|
||||
**If MinIO distributed setup is using NFS volumes underneath it is not guaranteed MinIO will provide these consistency guarantees since NFS is not consistent filesystem by design (If you must use NFS we recommend that you atleast use NFSv4 instead of NFSv3).**
|
||||
|
||||
# Get started
|
||||
|
||||
@@ -36,7 +38,7 @@ To start a distributed MinIO instance, you just need to pass drive locations as
|
||||
|
||||
__NOTE:__
|
||||
|
||||
- All the nodes running distributed MinIO need to have same access key and secret key for the nodes to connect. To achieve this, it is __recommended__ to export access key and secret key as environment variables, `MINIO_ROOT_USER` and `MINIO_ROOT_PASSWORD`, on all the nodes before executing MinIO server command.
|
||||
- All the nodes running distributed MinIO should share a common root credentials, for the nodes to connect and trust each other. To achieve this, it is __recommended__ to export root user and root password as environment variables, `MINIO_ROOT_USER` and `MINIO_ROOT_PASSWORD`, on all the nodes before executing MinIO server command. If not exported, default `minioadmin/minioadmin` credentials shall be used.
|
||||
- __MinIO creates erasure-coding sets of *4* to *16* drives per set. The number of drives you provide in total must be a multiple of one of those numbers.__
|
||||
- __MinIO chooses the largest EC set size which divides into the total number of drives or total number of nodes given - making sure to keep the uniform distribution i.e each node participates equal number of drives per set__.
|
||||
- __Each object is written to a single EC set, and therefore is spread over no more than 16 drives.__
|
||||
|
||||
@@ -1834,7 +1834,7 @@
|
||||
"targets": [
|
||||
{
|
||||
"exemplar": true,
|
||||
"expr": "rate(minio_node_process_cpu_total_seconds[$__interval])",
|
||||
"expr": "rate(minio_node_process_cpu_total_seconds[$__rate_interval])",
|
||||
"interval": "",
|
||||
"legendFormat": "CPU Usage Rate [{{server}}]",
|
||||
"refId": "A"
|
||||
@@ -2445,7 +2445,7 @@
|
||||
"targets": [
|
||||
{
|
||||
"exemplar": true,
|
||||
"expr": "rate(minio_node_io_rchar_bytes[$__interval])",
|
||||
"expr": "rate(minio_node_io_rchar_bytes[$__rate_interval])",
|
||||
"format": "time_series",
|
||||
"instant": false,
|
||||
"interval": "",
|
||||
@@ -2454,7 +2454,7 @@
|
||||
},
|
||||
{
|
||||
"exemplar": true,
|
||||
"expr": "rate(minio_node_io_wchar_bytes[$__interval])",
|
||||
"expr": "rate(minio_node_io_wchar_bytes[$__rate_interval])",
|
||||
"interval": "",
|
||||
"legendFormat": "Node WChar [{{server}}]",
|
||||
"refId": "B"
|
||||
@@ -2544,5 +2544,5 @@
|
||||
"timezone": "",
|
||||
"title": "MinIO Overview",
|
||||
"uid": "pJnnS4hZz",
|
||||
"version": 37
|
||||
}
|
||||
"version": 4
|
||||
}
|
||||
@@ -60,7 +60,7 @@ minio server --address :9003 http://192.168.10.1{1...4}/data/tenant3
|
||||
|
||||
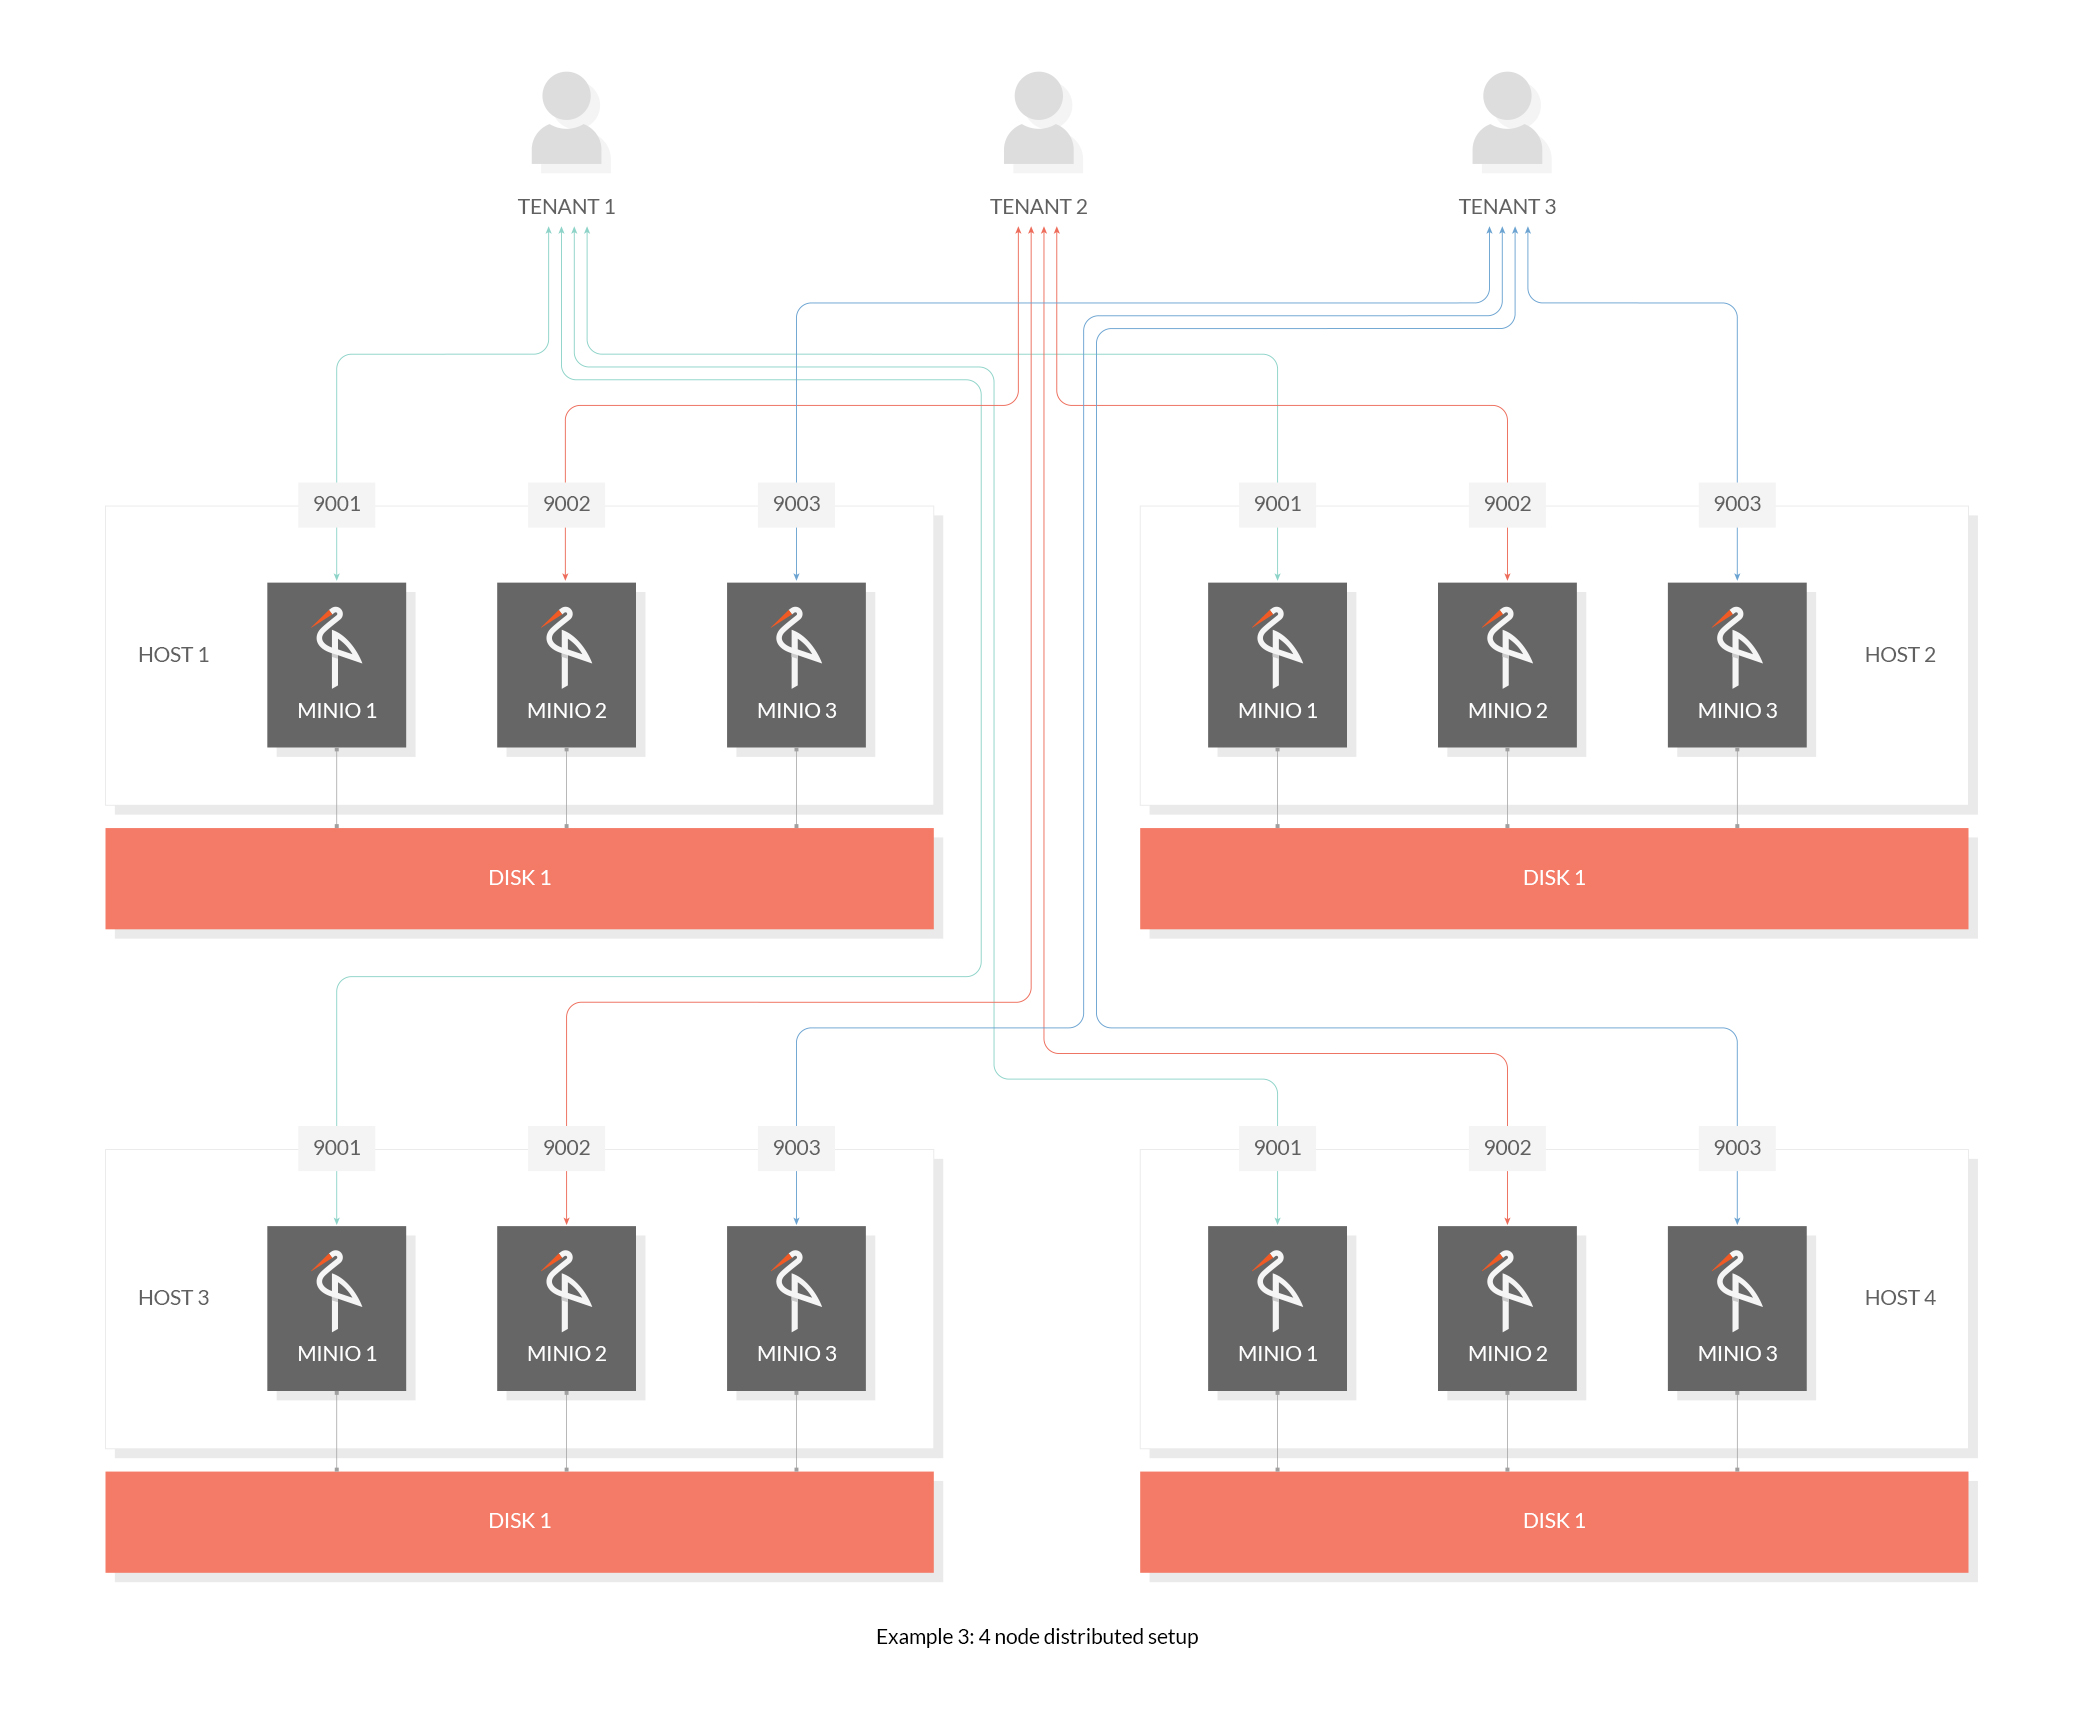
|
||||
|
||||
**Note**: On distributed systems, credentials must be defined and exported using the `MINIO_ROOT_USER` and `MINIO_ROOT_PASSWORD` environment variables. If a domain is required, it must be specified by defining and exporting the `MINIO_DOMAIN` environment variable.
|
||||
**Note**: On distributed systems, root credentials are recommend to be defined by exporting the `MINIO_ROOT_USER` and `MINIO_ROOT_PASSWORD` environment variables. If no value is set MinIO setup will assume `minioadmin/minioadmin` as default credentials. If a domain is required, it must be specified by defining and exporting the `MINIO_DOMAIN` environment variable.
|
||||
|
||||
## <a name="cloud-scale-deployment"></a>Cloud Scale Deployment
|
||||
|
||||
|
||||
@@ -5,7 +5,7 @@ version: '3.7'
|
||||
# it through port 9000.
|
||||
services:
|
||||
minio1:
|
||||
image: minio/minio:RELEASE.2021-04-22T15-44-28Z
|
||||
image: minio/minio:RELEASE.2021-05-20T22-31-44Z
|
||||
volumes:
|
||||
- data1-1:/data1
|
||||
- data1-2:/data2
|
||||
@@ -22,7 +22,7 @@ services:
|
||||
retries: 3
|
||||
|
||||
minio2:
|
||||
image: minio/minio:RELEASE.2021-04-22T15-44-28Z
|
||||
image: minio/minio:RELEASE.2021-05-20T22-31-44Z
|
||||
volumes:
|
||||
- data2-1:/data1
|
||||
- data2-2:/data2
|
||||
@@ -39,7 +39,7 @@ services:
|
||||
retries: 3
|
||||
|
||||
minio3:
|
||||
image: minio/minio:RELEASE.2021-04-22T15-44-28Z
|
||||
image: minio/minio:RELEASE.2021-05-20T22-31-44Z
|
||||
volumes:
|
||||
- data3-1:/data1
|
||||
- data3-2:/data2
|
||||
@@ -56,7 +56,7 @@ services:
|
||||
retries: 3
|
||||
|
||||
minio4:
|
||||
image: minio/minio:RELEASE.2021-04-22T15-44-28Z
|
||||
image: minio/minio:RELEASE.2021-05-20T22-31-44Z
|
||||
volumes:
|
||||
- data4-1:/data1
|
||||
- data4-2:/data2
|
||||
|
||||
+1
-1
@@ -236,7 +236,7 @@ $ export MINIO_ROOT_PASSWORD=minio123
|
||||
$ export MINIO_IDENTITY_LDAP_SERVER_ADDR='my.ldap-active-dir-server.com:636'
|
||||
$ export MINIO_IDENTITY_LDAP_USERNAME_FORMAT='cn=%s,ou=Users,ou=BUS1,ou=LOB,dc=somedomain,dc=com;cn=%s,ou=Users,ou=BUS2,ou=LOB,dc=somedomain,dc=com'
|
||||
$ export MINIO_IDENTITY_LDAP_GROUP_SEARCH_BASE_DN='dc=minioad,dc=local;dc=somedomain,dc=com'
|
||||
$ export MINIO_IDENTITY_LDAP_GROUP_SEARCH_FILTER='(&(objectclass=group)(member=%s))'
|
||||
$ export MINIO_IDENTITY_LDAP_GROUP_SEARCH_FILTER='(&(objectclass=groupOfNames)(member=%d))'
|
||||
$ minio server ~/test
|
||||
```
|
||||
You can make sure it works appropriately using our [example program](https://raw.githubusercontent.com/minio/minio/master/docs/sts/ldap.go):
|
||||
|
||||
@@ -77,17 +77,17 @@ require (
|
||||
github.com/shirou/gopsutil/v3 v3.21.3
|
||||
github.com/spf13/pflag v1.0.5 // indirect
|
||||
github.com/streadway/amqp v1.0.0
|
||||
github.com/tinylib/msgp v1.1.3
|
||||
github.com/tinylib/msgp v1.1.6-0.20210521143832-0becd170c402
|
||||
github.com/valyala/bytebufferpool v1.0.0
|
||||
github.com/valyala/tcplisten v0.0.0-20161114210144-ceec8f93295a
|
||||
github.com/willf/bloom v2.0.3+incompatible
|
||||
github.com/xdg/scram v0.0.0-20180814205039-7eeb5667e42c
|
||||
go.etcd.io/etcd v0.0.0-20201125193152-8a03d2e9614b
|
||||
go.uber.org/zap v1.14.1
|
||||
golang.org/x/crypto v0.0.0-20210421170649-83a5a9bb288b
|
||||
golang.org/x/mod v0.4.0 // indirect
|
||||
golang.org/x/sys v0.0.0-20210420072515-93ed5bcd2bfe
|
||||
golang.org/x/sys v0.0.0-20210510120138-977fb7262007
|
||||
golang.org/x/time v0.0.0-20200416051211-89c76fbcd5d1 // indirect
|
||||
golang.org/x/tools v0.1.1-0.20210201201750-4d4ee958a9b7 // indirect
|
||||
golang.org/x/tools v0.1.1 // indirect
|
||||
google.golang.org/api v0.31.0
|
||||
gopkg.in/yaml.v2 v2.3.0
|
||||
honnef.co/go/tools v0.0.1-2020.1.6 // indirect
|
||||
|
||||
@@ -686,8 +686,9 @@ github.com/tidwall/pretty v1.1.0/go.mod h1:XNkn88O1ChpSDQmQeStsy+sBenx6DDtFZJxhV
|
||||
github.com/tidwall/sjson v1.0.4/go.mod h1:bURseu1nuBkFpIES5cz6zBtjmYeOQmEESshn7VpF15Y=
|
||||
github.com/tidwall/sjson v1.1.6 h1:8fDdlahON04OZBlTQCIatW8FstSFJz8oxidj5h0rmSQ=
|
||||
github.com/tidwall/sjson v1.1.6/go.mod h1:KN3FZ7odvXIHPbJdhNorK/M9lWweVUbXsXXhrJ/kGOA=
|
||||
github.com/tinylib/msgp v1.1.3 h1:3giwAkmtaEDLSV0MdO1lDLuPgklgPzmk8H9+So2BVfA=
|
||||
github.com/tinylib/msgp v1.1.3/go.mod h1:+d+yLhGm8mzTaHzB+wgMYrodPfmZrzkirds8fDWklFE=
|
||||
github.com/tinylib/msgp v1.1.6-0.20210521143832-0becd170c402 h1:x5VlSgDgIGXNegkO4gigpYmb/RFkKGgy12Kkrbif7XE=
|
||||
github.com/tinylib/msgp v1.1.6-0.20210521143832-0becd170c402/go.mod h1:75BAfg2hauQhs3qedfdDZmWAPcFMAvJE5b9rGOMufyw=
|
||||
github.com/tklauser/go-sysconf v0.3.4 h1:HT8SVixZd3IzLdfs/xlpq0jeSfTX57g1v6wB1EuzV7M=
|
||||
github.com/tklauser/go-sysconf v0.3.4/go.mod h1:Cl2c8ZRWfHD5IrfHo9VN+FX9kCFjIOyVklgXycLB6ek=
|
||||
github.com/tklauser/numcpus v0.2.1 h1:ct88eFm+Q7m2ZfXJdan1xYoXKlmwsfP+k88q05KvlZc=
|
||||
@@ -697,6 +698,8 @@ github.com/tmc/grpc-websocket-proxy v0.0.0-20170815181823-89b8d40f7ca8/go.mod h1
|
||||
github.com/tv42/httpunix v0.0.0-20150427012821-b75d8614f926/go.mod h1:9ESjWnEqriFuLhtthL60Sar/7RFoluCcXsuvEwTV5KM=
|
||||
github.com/urfave/cli v1.20.0/go.mod h1:70zkFmudgCuE/ngEzBv17Jvp/497gISqfk5gWijbERA=
|
||||
github.com/urfave/cli v1.22.1/go.mod h1:Gos4lmkARVdJ6EkW0WaNv/tZAAMe9V7XWyB60NtXRu0=
|
||||
github.com/valyala/bytebufferpool v1.0.0 h1:GqA5TC/0021Y/b9FG4Oi9Mr3q7XYx6KllzawFIhcdPw=
|
||||
github.com/valyala/bytebufferpool v1.0.0/go.mod h1:6bBcMArwyJ5K/AmCkWv1jt77kVWyCJ6HpOuEn7z0Csc=
|
||||
github.com/valyala/tcplisten v0.0.0-20161114210144-ceec8f93295a h1:0R4NLDRDZX6JcmhJgXi5E4b8Wg84ihbmUKp/GvSPEzc=
|
||||
github.com/valyala/tcplisten v0.0.0-20161114210144-ceec8f93295a/go.mod h1:v3UYOV9WzVtRmSR+PDvWpU/qWl4Wa5LApYYX4ZtKbio=
|
||||
github.com/willf/bitset v1.1.11 h1:N7Z7E9UvjW+sGsEl7k/SJrvY2reP1A07MrGuCjIOjRE=
|
||||
@@ -713,6 +716,7 @@ github.com/yuin/goldmark v1.1.25/go.mod h1:3hX8gzYuyVAZsxl0MRgGTJEmQBFcNTphYh9de
|
||||
github.com/yuin/goldmark v1.1.27/go.mod h1:3hX8gzYuyVAZsxl0MRgGTJEmQBFcNTphYh9decYSb74=
|
||||
github.com/yuin/goldmark v1.1.32/go.mod h1:3hX8gzYuyVAZsxl0MRgGTJEmQBFcNTphYh9decYSb74=
|
||||
github.com/yuin/goldmark v1.2.1/go.mod h1:3hX8gzYuyVAZsxl0MRgGTJEmQBFcNTphYh9decYSb74=
|
||||
github.com/yuin/goldmark v1.3.5/go.mod h1:mwnBkeHKe2W/ZEtQ+71ViKU8L12m81fl3OWwC1Zlc8k=
|
||||
go.etcd.io/bbolt v1.3.3/go.mod h1:IbVyRI1SCnLcuJnV2u8VeU0CEYM7e686BmAb1XKL+uU=
|
||||
go.etcd.io/bbolt v1.3.5 h1:XAzx9gjCb0Rxj7EoqcClPD1d5ZBxZJk0jbuoPHenBt0=
|
||||
go.etcd.io/bbolt v1.3.5/go.mod h1:G5EMThwa9y8QZGBClrRx5EY+Yw9kAhnjy3bSjsnlVTQ=
|
||||
@@ -794,8 +798,8 @@ golang.org/x/mod v0.1.1-0.20191105210325-c90efee705ee/go.mod h1:QqPTAvyqsEbceGzB
|
||||
golang.org/x/mod v0.1.1-0.20191107180719-034126e5016b/go.mod h1:QqPTAvyqsEbceGzBzNggFXnrqF1CaUcvgkdR5Ot7KZg=
|
||||
golang.org/x/mod v0.2.0/go.mod h1:s0Qsj1ACt9ePp/hMypM3fl4fZqREWJwdYDEqhRiZZUA=
|
||||
golang.org/x/mod v0.3.0/go.mod h1:s0Qsj1ACt9ePp/hMypM3fl4fZqREWJwdYDEqhRiZZUA=
|
||||
golang.org/x/mod v0.4.0 h1:8pl+sMODzuvGJkmj2W4kZihvVb5mKm8pB/X44PIQHv8=
|
||||
golang.org/x/mod v0.4.0/go.mod h1:s0Qsj1ACt9ePp/hMypM3fl4fZqREWJwdYDEqhRiZZUA=
|
||||
golang.org/x/mod v0.4.2 h1:Gz96sIWK3OalVv/I/qNygP42zyoKp3xptRVCWRFEBvo=
|
||||
golang.org/x/mod v0.4.2/go.mod h1:s0Qsj1ACt9ePp/hMypM3fl4fZqREWJwdYDEqhRiZZUA=
|
||||
golang.org/x/net v0.0.0-20180724234803-3673e40ba225/go.mod h1:mL1N/T3taQHkDXs73rZJwtUhF3w3ftmwwsq0BUmARs4=
|
||||
golang.org/x/net v0.0.0-20180826012351-8a410e7b638d/go.mod h1:mL1N/T3taQHkDXs73rZJwtUhF3w3ftmwwsq0BUmARs4=
|
||||
golang.org/x/net v0.0.0-20180906233101-161cd47e91fd/go.mod h1:mL1N/T3taQHkDXs73rZJwtUhF3w3ftmwwsq0BUmARs4=
|
||||
@@ -836,6 +840,7 @@ golang.org/x/net v0.0.0-20200822124328-c89045814202/go.mod h1:/O7V0waA8r7cgGh81R
|
||||
golang.org/x/net v0.0.0-20200904194848-62affa334b73/go.mod h1:/O7V0waA8r7cgGh81Ro3o1hOxt32SMVPicZroKQ2sZA=
|
||||
golang.org/x/net v0.0.0-20201021035429-f5854403a974/go.mod h1:sp8m0HH+o8qH0wwXwYZr8TS3Oi6o0r6Gce1SSxlDquU=
|
||||
golang.org/x/net v0.0.0-20210226172049-e18ecbb05110/go.mod h1:m0MpNAwzfU5UDzcl9v0D8zg8gWTRqZa9RBIspLL5mdg=
|
||||
golang.org/x/net v0.0.0-20210405180319-a5a99cb37ef4/go.mod h1:p54w0d4576C0XHj96bSt6lcn1PtDYWL6XObtHCRCNQM=
|
||||
golang.org/x/net v0.0.0-20210421230115-4e50805a0758 h1:aEpZnXcAmXkd6AvLb2OPt+EN1Zu/8Ne3pCqPjja5PXY=
|
||||
golang.org/x/net v0.0.0-20210421230115-4e50805a0758/go.mod h1:72T/g9IO56b78aLF+1Kcs5dz7/ng1VjMUvfKvpfy+jM=
|
||||
golang.org/x/oauth2 v0.0.0-20180821212333-d2e6202438be/go.mod h1:N/0e6XlmueqKjAGxoOufVs8QHGRruUQn6yWY3a++T0U=
|
||||
@@ -853,8 +858,9 @@ golang.org/x/sync v0.0.0-20190911185100-cd5d95a43a6e/go.mod h1:RxMgew5VJxzue5/jJ
|
||||
golang.org/x/sync v0.0.0-20200317015054-43a5402ce75a/go.mod h1:RxMgew5VJxzue5/jJTE5uejpjVlOe/izrB70Jof72aM=
|
||||
golang.org/x/sync v0.0.0-20200625203802-6e8e738ad208/go.mod h1:RxMgew5VJxzue5/jJTE5uejpjVlOe/izrB70Jof72aM=
|
||||
golang.org/x/sync v0.0.0-20201020160332-67f06af15bc9/go.mod h1:RxMgew5VJxzue5/jJTE5uejpjVlOe/izrB70Jof72aM=
|
||||
golang.org/x/sync v0.0.0-20201207232520-09787c993a3a h1:DcqTD9SDLc+1P/r1EmRBwnVsrOwW+kk2vWf9n+1sGhs=
|
||||
golang.org/x/sync v0.0.0-20201207232520-09787c993a3a/go.mod h1:RxMgew5VJxzue5/jJTE5uejpjVlOe/izrB70Jof72aM=
|
||||
golang.org/x/sync v0.0.0-20210220032951-036812b2e83c h1:5KslGYwFpkhGh+Q16bwMP3cOontH8FOep7tGV86Y7SQ=
|
||||
golang.org/x/sync v0.0.0-20210220032951-036812b2e83c/go.mod h1:RxMgew5VJxzue5/jJTE5uejpjVlOe/izrB70Jof72aM=
|
||||
golang.org/x/sys v0.0.0-20180823144017-11551d06cbcc/go.mod h1:STP8DvDyc/dI5b8T5hshtkjS+E42TnysNCUPdjciGhY=
|
||||
golang.org/x/sys v0.0.0-20180905080454-ebe1bf3edb33/go.mod h1:STP8DvDyc/dI5b8T5hshtkjS+E42TnysNCUPdjciGhY=
|
||||
golang.org/x/sys v0.0.0-20180909124046-d0be0721c37e/go.mod h1:STP8DvDyc/dI5b8T5hshtkjS+E42TnysNCUPdjciGhY=
|
||||
@@ -912,8 +918,10 @@ golang.org/x/sys v0.0.0-20210119212857-b64e53b001e4/go.mod h1:h1NjWce9XRLGQEsW7w
|
||||
golang.org/x/sys v0.0.0-20210124154548-22da62e12c0c/go.mod h1:h1NjWce9XRLGQEsW7wpKNCjG9DtNlClVuFLEZdDNbEs=
|
||||
golang.org/x/sys v0.0.0-20210217105451-b926d437f341/go.mod h1:h1NjWce9XRLGQEsW7wpKNCjG9DtNlClVuFLEZdDNbEs=
|
||||
golang.org/x/sys v0.0.0-20210225134936-a50acf3fe073/go.mod h1:h1NjWce9XRLGQEsW7wpKNCjG9DtNlClVuFLEZdDNbEs=
|
||||
golang.org/x/sys v0.0.0-20210420072515-93ed5bcd2bfe h1:WdX7u8s3yOigWAhHEaDl8r9G+4XwFQEQFtBMYyN+kXQ=
|
||||
golang.org/x/sys v0.0.0-20210330210617-4fbd30eecc44/go.mod h1:h1NjWce9XRLGQEsW7wpKNCjG9DtNlClVuFLEZdDNbEs=
|
||||
golang.org/x/sys v0.0.0-20210420072515-93ed5bcd2bfe/go.mod h1:h1NjWce9XRLGQEsW7wpKNCjG9DtNlClVuFLEZdDNbEs=
|
||||
golang.org/x/sys v0.0.0-20210510120138-977fb7262007 h1:gG67DSER+11cZvqIMb8S8bt0vZtiN6xWYARwirrOSfE=
|
||||
golang.org/x/sys v0.0.0-20210510120138-977fb7262007/go.mod h1:oPkhp1MJrh7nUepCBck5+mAzfO9JrbApNNgaTdGDITg=
|
||||
golang.org/x/term v0.0.0-20201117132131-f5c789dd3221/go.mod h1:Nr5EML6q2oocZ2LXRh80K7BxOlk5/8JxuGnuhpl+muw=
|
||||
golang.org/x/term v0.0.0-20201126162022-7de9c90e9dd1/go.mod h1:bj7SfCRtBDWHUb9snDiAeCFNEtKQo2Wmx5Cou7ajbmo=
|
||||
golang.org/x/term v0.0.0-20210406210042-72f3dc4e9b72/go.mod h1:bj7SfCRtBDWHUb9snDiAeCFNEtKQo2Wmx5Cou7ajbmo=
|
||||
@@ -980,11 +988,12 @@ golang.org/x/tools v0.0.0-20200729194436-6467de6f59a7/go.mod h1:njjCfa9FT2d7l9Bc
|
||||
golang.org/x/tools v0.0.0-20200804011535-6c149bb5ef0d/go.mod h1:njjCfa9FT2d7l9Bc6FUM5FLjQPp3cFF28FI3qnDFljA=
|
||||
golang.org/x/tools v0.0.0-20200825202427-b303f430e36d/go.mod h1:njjCfa9FT2d7l9Bc6FUM5FLjQPp3cFF28FI3qnDFljA=
|
||||
golang.org/x/tools v0.0.0-20200828161849-5deb26317202/go.mod h1:njjCfa9FT2d7l9Bc6FUM5FLjQPp3cFF28FI3qnDFljA=
|
||||
golang.org/x/tools v0.0.0-20201022035929-9cf592e881e9/go.mod h1:emZCQorbCU4vsT4fOWvOPXz4eW1wZW4PmDk9uLelYpA=
|
||||
golang.org/x/tools v0.0.0-20201105001634-bc3cf281b174/go.mod h1:emZCQorbCU4vsT4fOWvOPXz4eW1wZW4PmDk9uLelYpA=
|
||||
golang.org/x/tools v0.0.0-20210106214847-113979e3529a/go.mod h1:emZCQorbCU4vsT4fOWvOPXz4eW1wZW4PmDk9uLelYpA=
|
||||
golang.org/x/tools v0.1.0/go.mod h1:xkSsbof2nBLbhDlRMhhhyNLN/zl3eTqcnHD5viDpcZ0=
|
||||
golang.org/x/tools v0.1.1-0.20210201201750-4d4ee958a9b7 h1:/wdPW261t381NDQd8TBo63/FyvACfLICwtH8wMRoHJQ=
|
||||
golang.org/x/tools v0.1.1-0.20210201201750-4d4ee958a9b7/go.mod h1:xkSsbof2nBLbhDlRMhhhyNLN/zl3eTqcnHD5viDpcZ0=
|
||||
golang.org/x/tools v0.1.1 h1:wGiQel/hW0NnEkJUk8lbzkX2gFJU6PFxf1v5OlCfuOs=
|
||||
golang.org/x/tools v0.1.1/go.mod h1:o0xws9oXOQQZyjljx8fwUC0k7L1pTE6eaCbjGeHmOkk=
|
||||
golang.org/x/xerrors v0.0.0-20190717185122-a985d3407aa7/go.mod h1:I/5z698sn9Ka8TeJc9MKroUUfqBBauWjQqLJ2OPfmY0=
|
||||
golang.org/x/xerrors v0.0.0-20191011141410-1b5146add898/go.mod h1:I/5z698sn9Ka8TeJc9MKroUUfqBBauWjQqLJ2OPfmY0=
|
||||
golang.org/x/xerrors v0.0.0-20191204190536-9bdfabe68543/go.mod h1:I/5z698sn9Ka8TeJc9MKroUUfqBBauWjQqLJ2OPfmY0=
|
||||
|
||||
@@ -21,6 +21,10 @@ import (
|
||||
"encoding/xml"
|
||||
"errors"
|
||||
"io"
|
||||
"net/http"
|
||||
|
||||
"github.com/minio/minio/cmd/crypto"
|
||||
xhttp "github.com/minio/minio/cmd/http"
|
||||
)
|
||||
|
||||
const (
|
||||
@@ -107,6 +111,49 @@ func ParseBucketSSEConfig(r io.Reader) (*BucketSSEConfig, error) {
|
||||
if config.XMLNS == "" {
|
||||
config.XMLNS = xmlNS
|
||||
}
|
||||
|
||||
return &config, nil
|
||||
}
|
||||
|
||||
// Apply applies the SSE bucket configuration on the given HTTP headers and
|
||||
// sets the specified SSE headers.
|
||||
//
|
||||
// Apply does not overwrite any existing SSE headers. Further, it will
|
||||
// set minimal SSE-KMS headers if autoEncrypt is true and the BucketSSEConfig
|
||||
// is nil.
|
||||
func (b *BucketSSEConfig) Apply(headers http.Header, autoEncrypt bool) {
|
||||
if _, ok := crypto.IsRequested(headers); ok {
|
||||
return
|
||||
}
|
||||
if b == nil {
|
||||
if autoEncrypt {
|
||||
headers.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
}
|
||||
return
|
||||
}
|
||||
|
||||
switch b.Algorithm() {
|
||||
case xhttp.AmzEncryptionAES:
|
||||
headers.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionAES)
|
||||
case xhttp.AmzEncryptionKMS:
|
||||
headers.Set(xhttp.AmzServerSideEncryption, xhttp.AmzEncryptionKMS)
|
||||
headers.Set(xhttp.AmzServerSideEncryptionKmsID, b.KeyID())
|
||||
}
|
||||
}
|
||||
|
||||
// Algorithm returns the SSE algorithm specified by the SSE configuration.
|
||||
func (b *BucketSSEConfig) Algorithm() SSEAlgorithm {
|
||||
for _, rule := range b.Rules {
|
||||
return rule.DefaultEncryptionAction.Algorithm
|
||||
}
|
||||
return ""
|
||||
}
|
||||
|
||||
// KeyID returns the KMS key ID specified by the SSE configuration.
|
||||
// If the SSE configuration does not specify SSE-KMS it returns an
|
||||
// empty key ID.
|
||||
func (b *BucketSSEConfig) KeyID() string {
|
||||
for _, rule := range b.Rules {
|
||||
return rule.DefaultEncryptionAction.MasterKeyID
|
||||
}
|
||||
return ""
|
||||
}
|
||||
|
||||
@@ -129,7 +129,7 @@ func (t *Transition) UnmarshalXML(d *xml.Decoder, startElement xml.StartElement)
|
||||
return nil
|
||||
}
|
||||
|
||||
// Validate - validates the "Expiration" element
|
||||
// Validate - validates the "Transition" element
|
||||
func (t Transition) Validate() error {
|
||||
if !t.set {
|
||||
return nil
|
||||
|
||||
@@ -58,6 +58,7 @@ var (
|
||||
errReplicationUniquePriority = Errorf("Replication configuration has duplicate priority")
|
||||
errReplicationDestinationMismatch = Errorf("The destination bucket must be same for all rules")
|
||||
errRoleArnMissing = Errorf("Missing required parameter `Role` in ReplicationConfiguration")
|
||||
errInvalidSourceSelectionCriteria = Errorf("Invalid ReplicaModification status")
|
||||
)
|
||||
|
||||
// Config - replication configuration specified in
|
||||
@@ -78,6 +79,16 @@ func ParseConfig(reader io.Reader) (*Config, error) {
|
||||
if err := xml.NewDecoder(io.LimitReader(reader, maxReplicationConfigSize)).Decode(&config); err != nil {
|
||||
return nil, err
|
||||
}
|
||||
// By default, set replica modification to enabled if unset.
|
||||
for i := range config.Rules {
|
||||
if len(config.Rules[i].SourceSelectionCriteria.ReplicaModifications.Status) == 0 {
|
||||
config.Rules[i].SourceSelectionCriteria = SourceSelectionCriteria{
|
||||
ReplicaModifications: ReplicaModifications{
|
||||
Status: Enabled,
|
||||
},
|
||||
}
|
||||
}
|
||||
}
|
||||
return &config, nil
|
||||
}
|
||||
|
||||
@@ -136,6 +147,7 @@ type ObjectOpts struct {
|
||||
DeleteMarker bool
|
||||
SSEC bool
|
||||
OpType Type
|
||||
Replica bool
|
||||
}
|
||||
|
||||
// FilterActionableRules returns the rules actions that need to be executed
|
||||
@@ -187,9 +199,8 @@ func (c Config) Replicate(obj ObjectOpts) bool {
|
||||
default:
|
||||
return rule.DeleteMarkerReplication.Status == Enabled
|
||||
}
|
||||
} else { // regular object/metadata replication
|
||||
return true
|
||||
}
|
||||
} // regular object/metadata replication
|
||||
return rule.MetadataReplicate(obj)
|
||||
}
|
||||
return false
|
||||
}
|
||||
|
||||
@@ -140,7 +140,7 @@ func TestParseAndValidateReplicationConfig(t *testing.T) {
|
||||
}
|
||||
func TestReplicate(t *testing.T) {
|
||||
cfgs := []Config{
|
||||
{ //Config0 - Replication config has no filters, all replication enabled
|
||||
{ // Config0 - Replication config has no filters, all replication enabled
|
||||
Rules: []Rule{
|
||||
{
|
||||
Status: Enabled,
|
||||
@@ -151,7 +151,7 @@ func TestReplicate(t *testing.T) {
|
||||
},
|
||||
},
|
||||
},
|
||||
{ //Config1 - Replication config has no filters, delete,delete-marker replication disabled
|
||||
{ // Config1 - Replication config has no filters, delete,delete-marker replication disabled
|
||||
Rules: []Rule{
|
||||
{
|
||||
Status: Enabled,
|
||||
@@ -162,7 +162,7 @@ func TestReplicate(t *testing.T) {
|
||||
},
|
||||
},
|
||||
},
|
||||
{ //Config2 - Replication config has filters and more than 1 matching rule, delete,delete-marker replication disabled
|
||||
{ // Config2 - Replication config has filters and more than 1 matching rule, delete,delete-marker replication disabled
|
||||
Rules: []Rule{
|
||||
{
|
||||
Status: Enabled,
|
||||
@@ -180,7 +180,7 @@ func TestReplicate(t *testing.T) {
|
||||
},
|
||||
},
|
||||
},
|
||||
{ //Config3 - Replication config has filters and no overlapping rules
|
||||
{ // Config3 - Replication config has filters and no overlapping rules
|
||||
Rules: []Rule{
|
||||
{
|
||||
Status: Enabled,
|
||||
@@ -198,6 +198,17 @@ func TestReplicate(t *testing.T) {
|
||||
},
|
||||
},
|
||||
},
|
||||
{ // Config4 - Replication config has filters and SourceSelectionCriteria Disabled
|
||||
Rules: []Rule{
|
||||
{
|
||||
Status: Enabled,
|
||||
Priority: 2,
|
||||
DeleteMarkerReplication: DeleteMarkerReplication{Status: Enabled},
|
||||
DeleteReplication: DeleteReplication{Status: Enabled},
|
||||
SourceSelectionCriteria: SourceSelectionCriteria{ReplicaModifications: ReplicaModifications{Status: Disabled}},
|
||||
},
|
||||
},
|
||||
},
|
||||
}
|
||||
testCases := []struct {
|
||||
opts ObjectOpts
|
||||
@@ -249,7 +260,9 @@ func TestReplicate(t *testing.T) {
|
||||
{ObjectOpts{Name: "abc/c4test", DeleteMarker: true, OpType: DeleteReplicationType}, cfgs[3], true}, //36. matches rule 2 - DeleteMarker replication allowed by rule
|
||||
{ObjectOpts{Name: "abc/c4test", DeleteMarker: true, VersionID: "vid", OpType: DeleteReplicationType}, cfgs[3], false}, //37. matches rule 2 - DeleteReplication disallowed by rule for permanent delete of DeleteMarker
|
||||
{ObjectOpts{Name: "abc/c4test", VersionID: "vid", OpType: DeleteReplicationType}, cfgs[3], false}, //38. matches rule 2 - DeleteReplication disallowed by rule for permanent delete of version
|
||||
|
||||
// using config 4 - with replica modification sync disabled.
|
||||
{ObjectOpts{Name: "xy/c5test", UserTags: "k1=v1", Replica: true}, cfgs[4], false}, //39. replica syncing disabled, this object is a replica
|
||||
{ObjectOpts{Name: "xa/c5test", UserTags: "k1=v1", Replica: false}, cfgs[4], true}, //40. replica syncing disabled, this object is NOT a replica
|
||||
}
|
||||
|
||||
for i, testCase := range testCases {
|
||||
|
||||
@@ -98,9 +98,10 @@ type Rule struct {
|
||||
Priority int `xml:"Priority" json:"Priority"`
|
||||
DeleteMarkerReplication DeleteMarkerReplication `xml:"DeleteMarkerReplication" json:"DeleteMarkerReplication"`
|
||||
// MinIO extension to replicate versioned deletes
|
||||
DeleteReplication DeleteReplication `xml:"DeleteReplication" json:"DeleteReplication"`
|
||||
Destination Destination `xml:"Destination" json:"Destination"`
|
||||
Filter Filter `xml:"Filter" json:"Filter"`
|
||||
DeleteReplication DeleteReplication `xml:"DeleteReplication" json:"DeleteReplication"`
|
||||
Destination Destination `xml:"Destination" json:"Destination"`
|
||||
SourceSelectionCriteria SourceSelectionCriteria `xml:"SourceSelectionCriteria" json:"SourceSelectionCriteria"`
|
||||
Filter Filter `xml:"Filter" json:"Filter"`
|
||||
}
|
||||
|
||||
var (
|
||||
@@ -192,6 +193,10 @@ func (r Rule) Validate(bucket string, sameTarget bool) error {
|
||||
if err := r.DeleteReplication.Validate(); err != nil {
|
||||
return err
|
||||
}
|
||||
if err := r.SourceSelectionCriteria.Validate(); err != nil {
|
||||
return err
|
||||
}
|
||||
|
||||
if r.Priority < 0 {
|
||||
return errPriorityMissing
|
||||
}
|
||||
@@ -200,3 +205,12 @@ func (r Rule) Validate(bucket string, sameTarget bool) error {
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
// MetadataReplicate returns true if object is not a replica or in the case of replicas,
|
||||
// replica modification sync is enabled.
|
||||
func (r Rule) MetadataReplicate(obj ObjectOpts) bool {
|
||||
if !obj.Replica {
|
||||
return true
|
||||
}
|
||||
return obj.Replica && r.SourceSelectionCriteria.ReplicaModifications.Status == Enabled
|
||||
}
|
||||
|
||||
@@ -0,0 +1,68 @@
|
||||
// Copyright (c) 2015-2021 MinIO, Inc.
|
||||
//
|
||||
// This file is part of MinIO Object Storage stack
|
||||
//
|
||||
// This program is free software: you can redistribute it and/or modify
|
||||
// it under the terms of the GNU Affero General Public License as published by
|
||||
// the Free Software Foundation, either version 3 of the License, or
|
||||
// (at your option) any later version.
|
||||
//
|
||||
// This program is distributed in the hope that it will be useful
|
||||
// but WITHOUT ANY WARRANTY; without even the implied warranty of
|
||||
// MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE. See the
|
||||
// GNU Affero General Public License for more details.
|
||||
//
|
||||
// You should have received a copy of the GNU Affero General Public License
|
||||
// along with this program. If not, see <http://www.gnu.org/licenses/>.
|
||||
|
||||
package replication
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"fmt"
|
||||
"testing"
|
||||
)
|
||||
|
||||
func TestMetadataReplicate(t *testing.T) {
|
||||
testCases := []struct {
|
||||
inputConfig string
|
||||
opts ObjectOpts
|
||||
expectedResult bool
|
||||
}{
|
||||
// case 1 - rule with replica modification enabled; not a replica
|
||||
{inputConfig: `<ReplicationConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Role>arn:aws:iam::AcctID:role/role-name</Role><Rule><Status>Enabled</Status><DeleteMarkerReplication><Status>Disabled</Status></DeleteMarkerReplication><DeleteReplication><Status>Disabled</Status></DeleteReplication><Prefix>key-prefix</Prefix><Destination><Bucket>arn:aws:s3:::destinationbucket</Bucket></Destination><SourceSelectionCriteria><ReplicaModifications><Status>Enabled</Status></ReplicaModifications></SourceSelectionCriteria></Rule></ReplicationConfiguration>`,
|
||||
opts: ObjectOpts{Name: "c1test", DeleteMarker: false, OpType: ObjectReplicationType, Replica: false}, //1. Replica mod sync enabled; not a replica
|
||||
expectedResult: true,
|
||||
},
|
||||
// case 2 - rule with replica modification disabled; a replica
|
||||
{inputConfig: `<ReplicationConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Role>arn:aws:iam::AcctID:role/role-name</Role><Rule><Status>Enabled</Status><DeleteMarkerReplication><Status>Disabled</Status></DeleteMarkerReplication><DeleteReplication><Status>Disabled</Status></DeleteReplication><Prefix>key-prefix</Prefix><Destination><Bucket>arn:aws:s3:::destinationbucket</Bucket></Destination><SourceSelectionCriteria><ReplicaModifications><Status>Disabled</Status></ReplicaModifications></SourceSelectionCriteria></Rule></ReplicationConfiguration>`,
|
||||
opts: ObjectOpts{Name: "c2test", DeleteMarker: false, OpType: ObjectReplicationType, Replica: true}, //1. Replica mod sync enabled; a replica
|
||||
expectedResult: false,
|
||||
},
|
||||
// case 3 - rule with replica modification disabled; not a replica
|
||||
{inputConfig: `<ReplicationConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Role>arn:aws:iam::AcctID:role/role-name</Role><Rule><Status>Enabled</Status><DeleteMarkerReplication><Status>Disabled</Status></DeleteMarkerReplication><DeleteReplication><Status>Disabled</Status></DeleteReplication><Prefix>key-prefix</Prefix><Destination><Bucket>arn:aws:s3:::destinationbucket</Bucket></Destination><SourceSelectionCriteria><ReplicaModifications><Status>Disabled</Status></ReplicaModifications></SourceSelectionCriteria></Rule></ReplicationConfiguration>`,
|
||||
opts: ObjectOpts{Name: "c2test", DeleteMarker: false, OpType: ObjectReplicationType, Replica: false}, //1. Replica mod sync disabled; not a replica
|
||||
expectedResult: true,
|
||||
},
|
||||
|
||||
// case 4 - rule with replica modification enabled; a replica
|
||||
{inputConfig: `<ReplicationConfiguration xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Role>arn:aws:iam::AcctID:role/role-name</Role><Rule><Status>Enabled</Status><DeleteMarkerReplication><Status>Disabled</Status></DeleteMarkerReplication><DeleteReplication><Status>Disabled</Status></DeleteReplication><Prefix>key-prefix</Prefix><Destination><Bucket>arn:aws:s3:::destinationbucket</Bucket></Destination><SourceSelectionCriteria><ReplicaModifications><Status>Enabled</Status></ReplicaModifications></SourceSelectionCriteria></Rule></ReplicationConfiguration>`,
|
||||
opts: ObjectOpts{Name: "c2test", DeleteMarker: false, OpType: MetadataReplicationType, Replica: true}, //1. Replica mod sync enabled; a replica
|
||||
expectedResult: true,
|
||||
},
|
||||
}
|
||||
|
||||
for i, tc := range testCases {
|
||||
tc := tc
|
||||
t.Run(fmt.Sprintf("Test_%d", i+1), func(t *testing.T) {
|
||||
cfg, err := ParseConfig(bytes.NewReader([]byte(tc.inputConfig)))
|
||||
if err != nil {
|
||||
t.Fatalf("Got unexpected error: %v", err)
|
||||
}
|
||||
if got := cfg.Rules[0].MetadataReplicate(tc.opts); got != tc.expectedResult {
|
||||
t.Fatalf("Expected result with recursive set to false: `%v`, got: `%v`", tc.expectedResult, got)
|
||||
}
|
||||
})
|
||||
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,76 @@
|
||||
// Copyright (c) 2015-2021 MinIO, Inc.
|
||||
//
|
||||
// This file is part of MinIO Object Storage stack
|
||||
//
|
||||
// This program is free software: you can redistribute it and/or modify
|
||||
// it under the terms of the GNU Affero General Public License as published by
|
||||
// the Free Software Foundation, either version 3 of the License, or
|
||||
// (at your option) any later version.
|
||||
//
|
||||
// This program is distributed in the hope that it will be useful
|
||||
// but WITHOUT ANY WARRANTY; without even the implied warranty of
|
||||
// MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE. See the
|
||||
// GNU Affero General Public License for more details.
|
||||
//
|
||||
// You should have received a copy of the GNU Affero General Public License
|
||||
// along with this program. If not, see <http://www.gnu.org/licenses/>.
|
||||
|
||||
package replication
|
||||
|
||||
import (
|
||||
"encoding/xml"
|
||||
)
|
||||
|
||||
// ReplicaModifications specifies if replica modification sync is enabled
|
||||
type ReplicaModifications struct {
|
||||
Status Status `xml:"Status" json:"Status"`
|
||||
}
|
||||
|
||||
// SourceSelectionCriteria - specifies additional source selection criteria in ReplicationConfiguration.
|
||||
type SourceSelectionCriteria struct {
|
||||
ReplicaModifications ReplicaModifications `xml:"ReplicaModifications" json:"ReplicaModifications"`
|
||||
}
|
||||
|
||||
// IsValid - checks whether SourceSelectionCriteria is valid or not.
|
||||
func (s SourceSelectionCriteria) IsValid() bool {
|
||||
return s.ReplicaModifications.Status == Enabled || s.ReplicaModifications.Status == Disabled
|
||||
}
|
||||
|
||||
// Validate source selection criteria
|
||||
func (s SourceSelectionCriteria) Validate() error {
|
||||
if (s == SourceSelectionCriteria{}) {
|
||||
return nil
|
||||
}
|
||||
if !s.IsValid() {
|
||||
return errInvalidSourceSelectionCriteria
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
// UnmarshalXML - decodes XML data.
|
||||
func (s *SourceSelectionCriteria) UnmarshalXML(dec *xml.Decoder, start xml.StartElement) (err error) {
|
||||
// Make subtype to avoid recursive UnmarshalXML().
|
||||
type sourceSelectionCriteria SourceSelectionCriteria
|
||||
ssc := sourceSelectionCriteria{}
|
||||
if err := dec.DecodeElement(&ssc, &start); err != nil {
|
||||
return err
|
||||
}
|
||||
if len(ssc.ReplicaModifications.Status) == 0 {
|
||||
ssc.ReplicaModifications.Status = Enabled
|
||||
}
|
||||
*s = SourceSelectionCriteria(ssc)
|
||||
return nil
|
||||
}
|
||||
|
||||
// MarshalXML - encodes to XML data.
|
||||
func (s SourceSelectionCriteria) MarshalXML(e *xml.Encoder, start xml.StartElement) error {
|
||||
if err := e.EncodeToken(start); err != nil {
|
||||
return err
|
||||
}
|
||||
if s.IsValid() {
|
||||
if err := e.EncodeElement(s.ReplicaModifications, xml.StartElement{Name: xml.Name{Local: "ReplicaModifications"}}); err != nil {
|
||||
return err
|
||||
}
|
||||
}
|
||||
return e.EncodeToken(xml.EndElement{Name: start.Name})
|
||||
}
|
||||
+1
-37
@@ -15,11 +15,6 @@
|
||||
// You should have received a copy of the GNU Affero General Public License
|
||||
// along with this program. If not, see <http://www.gnu.org/licenses/>.
|
||||
|
||||
// Forked from golang.org/pkg/os.ReadFile with NOATIME support.
|
||||
// Copyright 2009 The Go Authors. All rights reserved.
|
||||
// Use of this source code is governed by a BSD-style
|
||||
// license that can be found in the https://golang.org/LICENSE file.
|
||||
|
||||
package ioutil
|
||||
|
||||
import (
|
||||
@@ -40,36 +35,5 @@ func ReadFile(name string) ([]byte, error) {
|
||||
}
|
||||
defer f.Close()
|
||||
|
||||
var size int
|
||||
if info, err := f.Stat(); err == nil {
|
||||
size64 := info.Size()
|
||||
if int64(int(size64)) == size64 {
|
||||
size = int(size64)
|
||||
}
|
||||
}
|
||||
size++ // one byte for final read at EOF
|
||||
|
||||
// If a file claims a small size, read at least 512 bytes.
|
||||
// In particular, files in Linux's /proc claim size 0 but
|
||||
// then do not work right if read in small pieces,
|
||||
// so an initial read of 1 byte would not work correctly.
|
||||
if size < 512 {
|
||||
size = 512
|
||||
}
|
||||
|
||||
data := make([]byte, 0, size)
|
||||
for {
|
||||
if len(data) >= cap(data) {
|
||||
d := append(data[:cap(data)], 0)
|
||||
data = d[:len(data)]
|
||||
}
|
||||
n, err := f.Read(data[len(data):cap(data)])
|
||||
data = data[:len(data)+n]
|
||||
if err != nil {
|
||||
if err == io.EOF {
|
||||
err = nil
|
||||
}
|
||||
return data, err
|
||||
}
|
||||
}
|
||||
return io.ReadAll(f)
|
||||
}
|
||||
|
||||
@@ -15,11 +15,6 @@
|
||||
// You should have received a copy of the GNU Affero General Public License
|
||||
// along with this program. If not, see <http://www.gnu.org/licenses/>.
|
||||
|
||||
// Forked from golang.org/pkg/os.ReadFile with NOATIME support.
|
||||
// Copyright 2009 The Go Authors. All rights reserved.
|
||||
// Use of this source code is governed by a BSD-style
|
||||
// license that can be found in the https://golang.org/LICENSE file.
|
||||
|
||||
package ioutil
|
||||
|
||||
import (
|
||||
|
||||
+7
-1
@@ -22,6 +22,7 @@ import (
|
||||
"crypto/tls"
|
||||
"crypto/x509"
|
||||
"errors"
|
||||
"time"
|
||||
|
||||
"github.com/minio/kes"
|
||||
)
|
||||
@@ -79,6 +80,11 @@ var _ KMS = (*kesClient)(nil) // compiler check
|
||||
// Stat returns the current KES status containing a
|
||||
// list of KES endpoints and the default key ID.
|
||||
func (c *kesClient) Stat() (Status, error) {
|
||||
ctx, cancel := context.WithTimeout(context.Background(), 10*time.Second)
|
||||
defer cancel()
|
||||
if _, err := c.client.Version(ctx); err != nil {
|
||||
return Status{}, err
|
||||
}
|
||||
var endpoints = make([]string, len(c.client.Endpoints))
|
||||
copy(endpoints, c.client.Endpoints)
|
||||
return Status{
|
||||
@@ -115,7 +121,7 @@ func (c *kesClient) GenerateKey(keyID string, ctx Context) (DEK, error) {
|
||||
}
|
||||
dek, err := c.client.GenerateKey(context.Background(), keyID, ctxBytes)
|
||||
if err != nil {
|
||||
return DEK{}, nil
|
||||
return DEK{}, err
|
||||
}
|
||||
return DEK{
|
||||
KeyID: keyID,
|
||||
|
||||
Reference in New Issue
Block a user